Premiers pas avec ARDS
Accès anticipé. Cette doc est en v1. Elle couvre l'essentiel, honnêtement. Si quelque chose semble incorrect, dites-le-nous — voir Obtenir de l'aide.
Voici la documentation ARDS pour les testeurs. Elle est découpée en :
- Démarrage rapide — ce que vous ferez dans vos 15 à 30 premières minutes.
- Concepts clés — vocabulaire, cycle de vie, fonctionnement des coders, ce que ça coûte.
- Guides — pas à pas orientés tâches, à reconsulter plus tard.
- Workflows — construire et exécuter des workflows : l'éditeur, le cycle de vie, les runs et la gouvernance. Les missions passent de plus en plus par là, donc ce chapitre mérite sa taille.
- Avancé — surfaces de power-user. Lecture optionnelle ; vous pouvez les ignorer et profiter pleinement du produit.
- Fonctionnement / Architecture — comment la plateforme s'assemble sous le capot. Lecture de fond, pas nécessaire au quotidien.
- Référence — tableaux d'états, modèles, notifications, et la liste des pages que vous pouvez sauter.
- Dépannage — les aspérités que nous connaissons déjà.
- Obtenir de l'aide — comment nous joindre.
Si vous arrivez de l'email d'invitation, commencez par À propos d'ARDS et descendez la barre latérale Démarrage rapide. Tout le reste peut attendre.
Une note sur cette doc : elle évolue avec le produit. Nous indiquons les manques connus au fil du texte. Si une page promet quelque chose que l'interface ne fait pas, c'est un bug de cette doc — dites-le-nous et on corrigera.
À propos d'ARDS
ARDS est un système qui fait construire du logiciel par des agents IA, avec un humain dans la boucle.
Le fonctionnement est simple :
- Vous décrivez ce que vous voulez, en langage naturel, dans une conversation.
- ARDS transforme la conversation en mission, puis découpe la mission en tâches. Une mission peut aussi exécuter un workflow — un graphe d'étapes enregistré et pré-approuvé — au lieu d'une décomposition ad hoc.
- Des coders IA prennent les tâches et travaillent, chacun dans son propre environnement isolé.
- Tout ce qu'ils produisent atterrit d'abord dans un miroir de revue — une copie séparée de votre dépôt, que vous pouvez inspecter.
- Rien n'arrive dans votre dépôt réel tant que vous n'avez pas approuvé. La même règle vaut quand une mission exécute un workflow — les changements d'un run n'atterrissent que quand vous acceptez le run.
Le dernier point est le plus important. Vous ne donnez pas une carte bancaire à des bots pour qu'ils fusionnent du code à votre place. L'étape de revue n'est pas optionnelle ; c'est volontaire.
Ce que vous apportez : un dépôt sur lequel vous voulez faire travailler ARDS (ou un dépôt vide pour démarrer), et des identifiants pour au moins un fournisseur d'IA (Anthropic, OpenAI ou un fournisseur compatible).
Ce qu'ARDS apporte : l'orchestration, les coders, le miroir de revue, et une interface pour piloter le tout.
Pourquoi deux couches (miroir + origine)
Si vous avez l'habitude d'intégrations GitHub qui commitent directement sur main, la couche miroir vous paraîtra étrange. La raison de son existence :
- Les coders se trompent. Les bots qui poussent directement sur votre dépôt vous transforment en plan de récupération.
- Le miroir est à vous. Si un coder écrit quelque chose de faux, ça meurt sur le miroir sans jamais toucher à
origin. - L'approbation, c'est un clic. Refuser et demander des changements aussi.
Une fois que vous avez approuvé un changement sur le miroir, ARDS le pousse à votre place vers votre origine.
Ce qu'ARDS n'est pas
Quelques choses qu'ARDS ne cherche pas à être :
- Un éditeur de code. Vous lisez du code dans l'écran de revue ; vous n'écrivez pas de code dans ARDS.
- Une plateforme CI/CD. ARDS produit des commits et des PR. Que vos tests tournent au push, c'est votre CI qui s'en occupe.
- Une place de marché de modèles. ARDS utilise les modèles que vous connectez via clés d'API. Vous apportez le fournisseur ; ARDS l'utilise raisonnablement.
Si vous ne retenez qu'une phrase de cette page : le travail d'un coder atterrit sur un miroir que vous approuvez, jamais directement sur votre dépôt.
Avant de commencer
Quelques attentes honnêtes :
- C'est de l'accès anticipé. Le produit fonctionne, mais certaines aspérités sont encore en cours de ponçage. Vous en trouverez. C'est normal et bienvenu.
- Cette doc est en v1. Elle couvre le chemin que vous emprunterez réellement lors de votre première session. Les docs de référence détaillées viendront à mesure que le produit se stabilise.
- Un bon retour est précis. « Ça ne marche pas » est difficile à exploiter. « L'écran X est resté bloqué 60 s après avoir cliqué sur Y » est précieux. Captures d'écran et horodatages approximatifs aident.
- Comptez 15 à 30 minutes pour une première session — le temps de vous installer, vous connecter, connecter un fournisseur, enregistrer un projet et démarrer une première conversation.
Ce dont vous avez besoin avant le lien d'invitation
Pas grand-chose :
- Un navigateur de bureau récent. Chrome, Firefox, Edge ou Safari, versions à jour. Les navigateurs mobiles fonctionnent mais le tableau de bord n'est pas pensé pour les petits écrans pour l'instant.
- Une clé d'API d'un fournisseur pris en charge (voir Modèles, fournisseurs et coûts pour la liste à jour). Anthropic Claude est la valeur par défaut recommandée. Les clés OpenAI (et fournisseurs compatibles OpenAI) fonctionnent aussi.
- Un dépôt si vous voulez démarrer avec du vrai code — ou aucun. Quand vous enregistrez un projet, le champ URL du dépôt est facultatif : laissez-le vide et Genesis héberge le dépôt pour vous (un projet greenfield). Vous pourrez apporter votre propre dépôt plus tard.
Ce dont vous n'avez pas besoin
- Aucune installation. ARDS vit à
https://<votre-slug>.ards.etiakorp.com/. Rien à installer en local. - Aucune CLI. Tout est dans l'app web. (Une CLI existe pour les opérateurs qui provisionnent les tenants — les testeurs ne la voient pas.)
- Aucun moyen de paiement en accès anticipé. Les coûts sont facturés à la clé d'API que vous connectez (votre fournisseur, votre crédit).
Ce que cette doc suppose acquis
Nous supposons que vous êtes à l'aise avec :
- Les bases de Git (clone, branche, commit, PR) — vous ne lancerez pas de commandes
git, mais le vocabulaire aide. - L'idée de clé d'API / jeton d'accès personnel.
- La lecture de diffs.
Si certains de ces mots vous sont étrangers, le reste de la doc devrait quand même tenir debout — on explique le nouveau vocabulaire au fil de l'eau dans Vocabulaire. Si ce n'est pas le cas, c'est un bug — dites-le-nous via Obtenir de l'aide.
Prêt ? Direction Votre première session.
Votre première session
Voici le chemin idéal — à quoi ressemblent vos 15 à 30 premières minutes.
1. L'email d'invitation
Vous recevez un email depuis update@etiakorp.com avec un lien à l'intérieur. Quelques précisions honnêtes :
- Il peut atterrir dans les spams, surtout sur Outlook, Live et Gmail. Vérifiez votre dossier indésirables en premier. Marquez l'expéditeur comme légitime pour que les emails système suivants atterrissent dans votre boîte de réception.
- Si vous recevez plusieurs emails d'invitation (cela peut arriver si le provisionnement a réessayé pendant la mise en place), utilisez le plus récent. Les liens plus anciens peuvent encore fonctionner, mais le dernier est le bon.
- Le lien pointe vers notre fournisseur d'identité, et non vers une page Genesis directement.
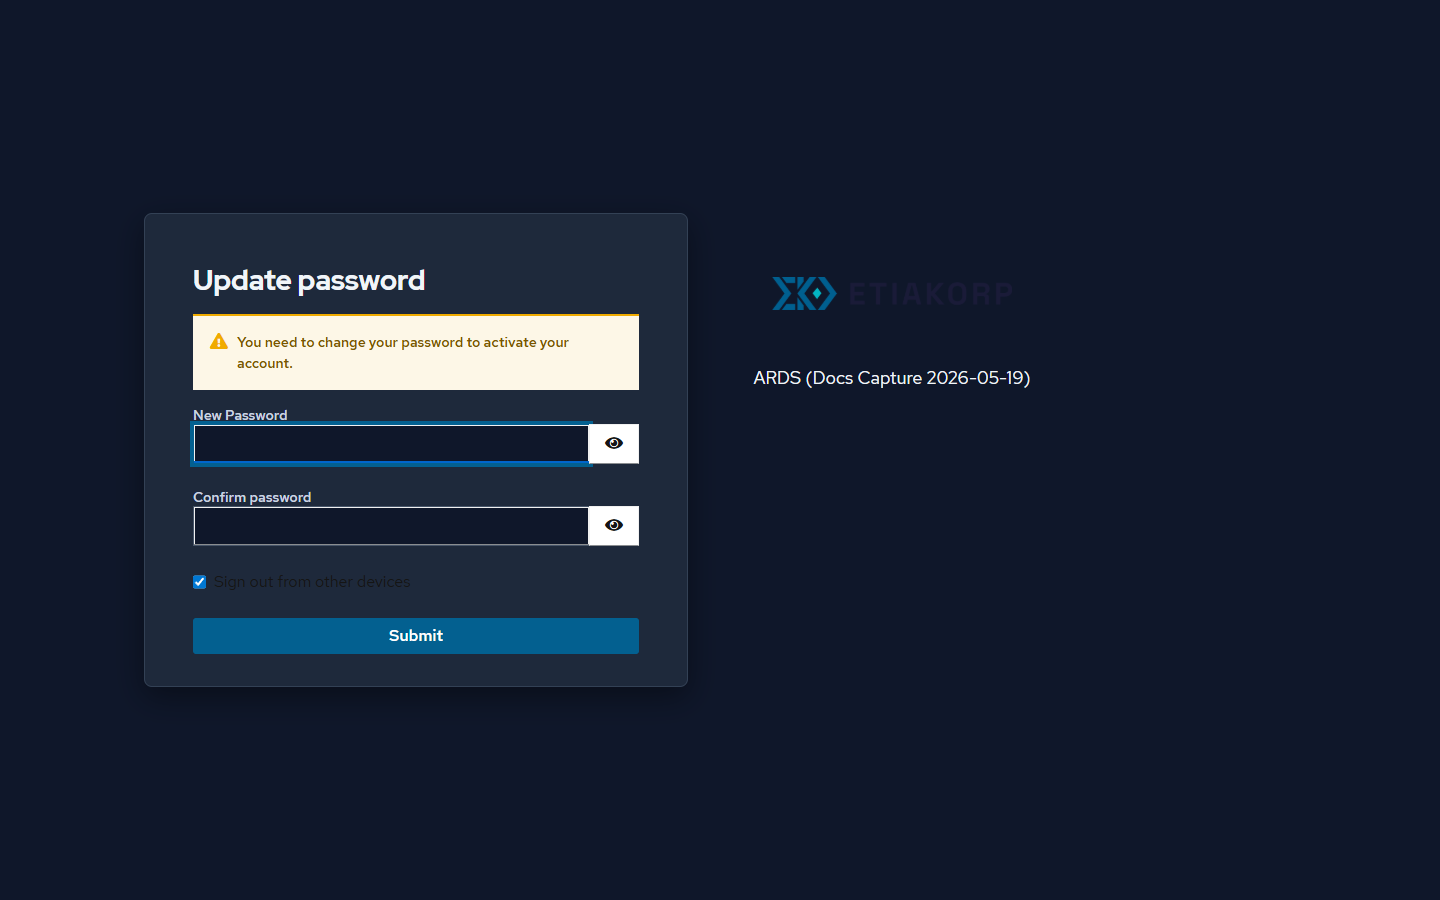
2. Activez votre compte
Le lien vous guide à travers deux étapes, toutes deux gérées par le fournisseur d'identité :
- Définissez votre mot de passe. N'importe quoi de raisonnable — vous n'en aurez besoin qu'une fois.
- Vérifiez votre email. Un seul clic confirme que c'est bien vous.
Une fois ces deux étapes terminées, vous êtes redirigé vers l'URL de votre tenant : https://<votre-slug>.ards.etiakorp.com/. Le slug exact est dans votre email — pensez à mettre la page en favori.
3. Connectez-vous
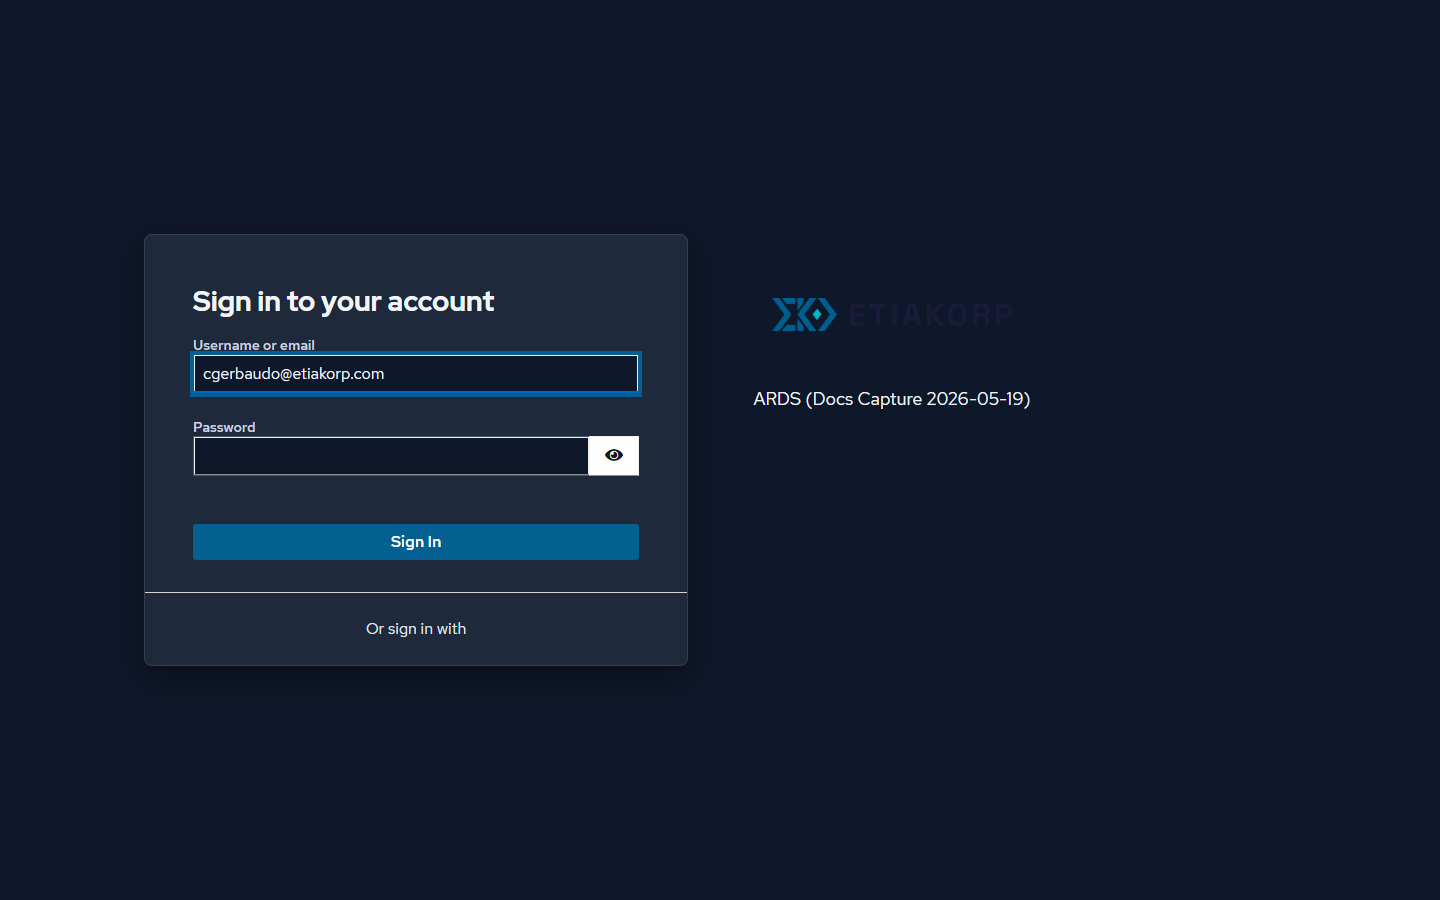
Vous arrivez sur l'écran de connexion (toujours le fournisseur d'identité — Genesis lui-même se trouve une étape plus loin). Votre email est pré-rempli. Saisissez le mot de passe que vous venez de définir. Vous ne ferez cette connexion qu'une seule fois pour la session.
Si l'URL ne se charge pas du premier coup, attendez 1 à 2 minutes et rafraîchissez. Les nouveaux sous-domaines tenant ont besoin d'un moment pour que le DNS et le certificat TLS se propagent. Si cela ne fonctionne toujours pas après 5 minutes, voir Dépannage.
4. Connectez un fournisseur de modèles
Il n'y a pas d'assistant de configuration séparé — la mise en route se fait sur les pages normales, en deux étapes courtes : connecter un fournisseur, puis enregistrer un projet.
Le fournisseur d'abord, parce que tout le reste tourne dessus :
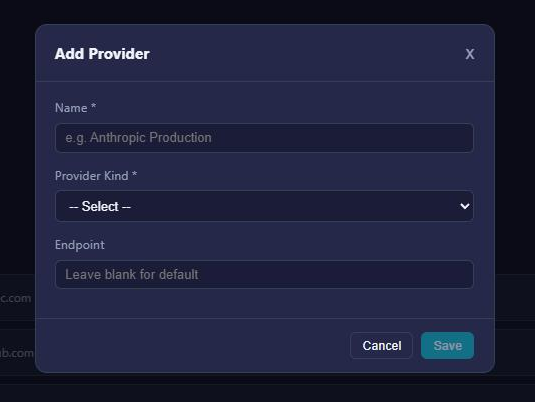
- Ouvrez Config LLM. La page figure dans l'index Toutes les fonctionnalités en bas de la barre latérale — et tant qu'aucun fournisseur n'est connecté, la page Conversations affiche aussi un raccourci Ouvrir Config LLM.
- Dans l'onglet Fournisseurs, cliquez sur Ajouter un fournisseur : donnez-lui un nom, choisissez le type de fournisseur — Anthropic (la valeur par défaut recommandée), OpenAI / Synthetic, Ollama ou JetBrains — et laissez le point d'accès vide pour utiliser celui par défaut.
- Sur le fournisseur que vous venez de créer, cliquez sur Ajouter un identifiant et collez votre Clé API.
5. Enregistrez votre premier projet
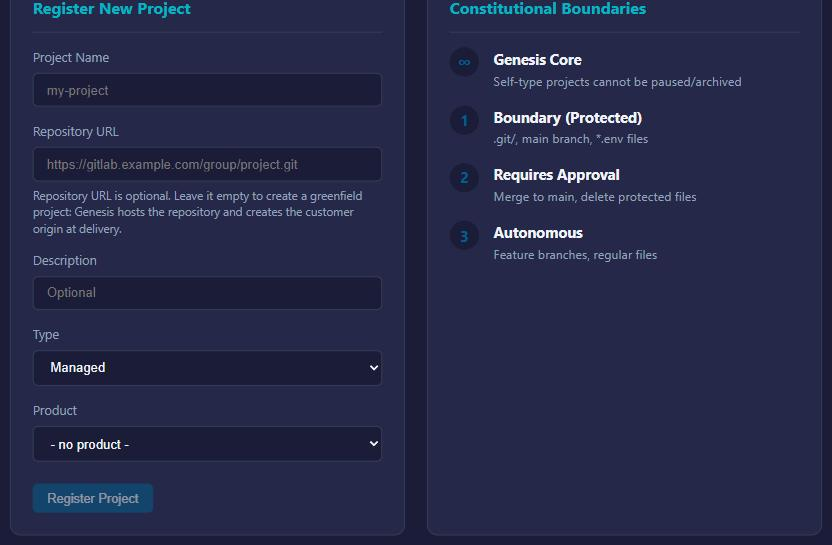
Ensuite, le projet. Cliquez sur Projets dans la barre latérale et remplissez le formulaire Enregistrer un nouveau projet :
- Nom du projet — quelque chose de lisible.
- URL du dépôt — facultative, HTTPS ou SSH.
- Collez une URL pour qu'ARDS travaille sur un dépôt existant. Pour un dépôt HTTPS privé, un champ Personal Access Token est proposé (portée lecture ; stocké chiffré, utilisé uniquement pour cloner vers le miroir). Pour une URL SSH, le formulaire génère une clé de déploiement à ajouter chez votre hébergeur Git.
- Ou laissez-la vide. Le formulaire l'explique lui-même : « L'URL du dépôt est facultative. Laissez-la vide pour créer un projet greenfield : Genesis héberge le dépôt et crée le dépôt d'origine du client à la livraison. » C'est la première prise en main la plus simple — aucun dépôt à préparer, aucune URL à chercher.
Cliquez sur Enregistrer un projet. Et c'est tout : le projet est cloné, indexé et intégré automatiquement — ARDS construit sa vision du projet à partir de ce qui se trouve réellement dans le dépôt. Il n'y a aucun parcours d'accueil séparé à surveiller.
Pendant que cela tourne, faites-en le projet actif : ouvrez le sélecteur de projet dans la barre du haut — la liste déroulante qui affiche Tous les projets tant que vous n'avez rien choisi — et sélectionnez votre projet. Cela cadre l'application sur ce projet et ajoute deux liens propres au projet sous Projets dans la barre latérale : Intel projet et Intégration.
6. Le tableau de bord
Direction Accueil — le tableau de bord est votre page d'accueil.
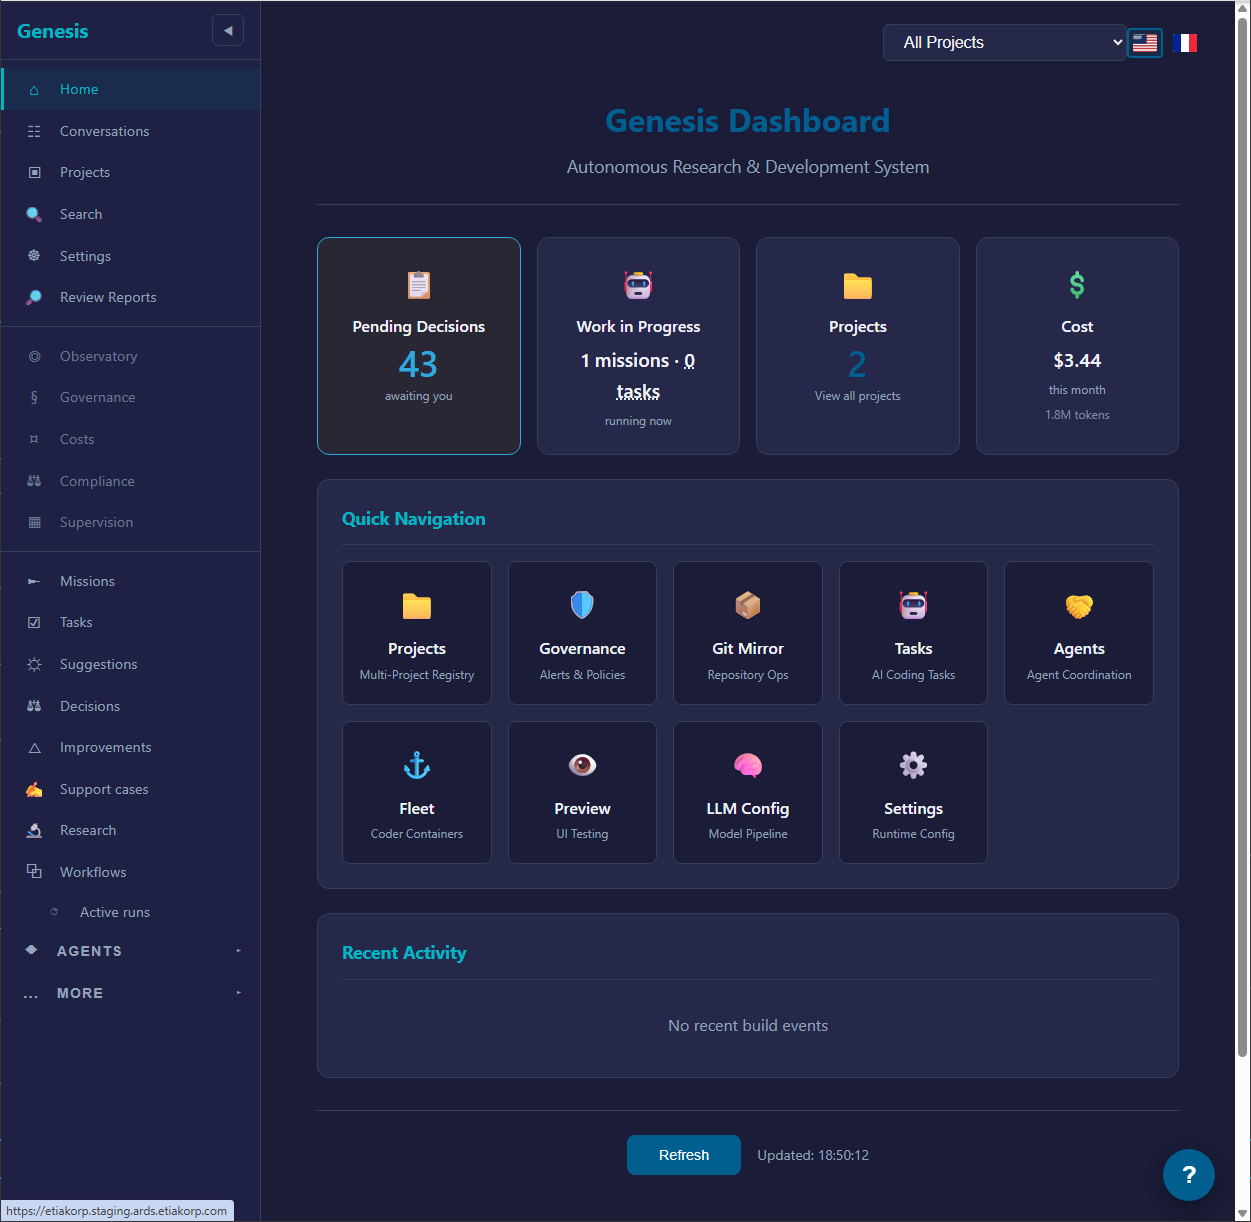
Une chose à savoir tôt : la barre latérale démarre volontairement réduite. Quelques entrées — Tâches, Revues, Suggestions, Tickets de support, Recherche approfondie — n'apparaissent qu'une fois que votre tenant a produit son premier artefact de ce type (votre première tâche, votre première revue…), et une fois révélées, elles restent. En attendant, chaque page reste accessible depuis l'index Toutes les fonctionnalités en bas de la barre latérale.
À partir d'ici, deux endroits comptent :
- Décisions — la file d'approbations. Une fois l'intégration terminée, le steward du projet y propose une première mission, et chaque approbation suivante arrive dans la même file.
- Conversations — là où vous briefez ARDS vous-même. C'est la page suivante : Première conversation, mission et revue.
À propos de l'application mobile
Une application mobile est en cours de développement. Elle n'est pas encore déployée pour les testeurs. Restez sur l'application web dans un navigateur de bureau pour la v1.
Première conversation, mission et revue
Vous êtes sur le tableau de bord. La boucle complète passe par trois pages : Conversations, Missions et Revues. Conversations et Missions sont toujours dans la barre latérale ; Revues les rejoint plus tard (l'entrée apparaît dès que votre première mission produit du travail). Y passer une fois cimente le modèle mental.
1. Démarrer une conversation
Cliquez sur Conversations dans la barre latérale, puis sur + Nouveau chat.
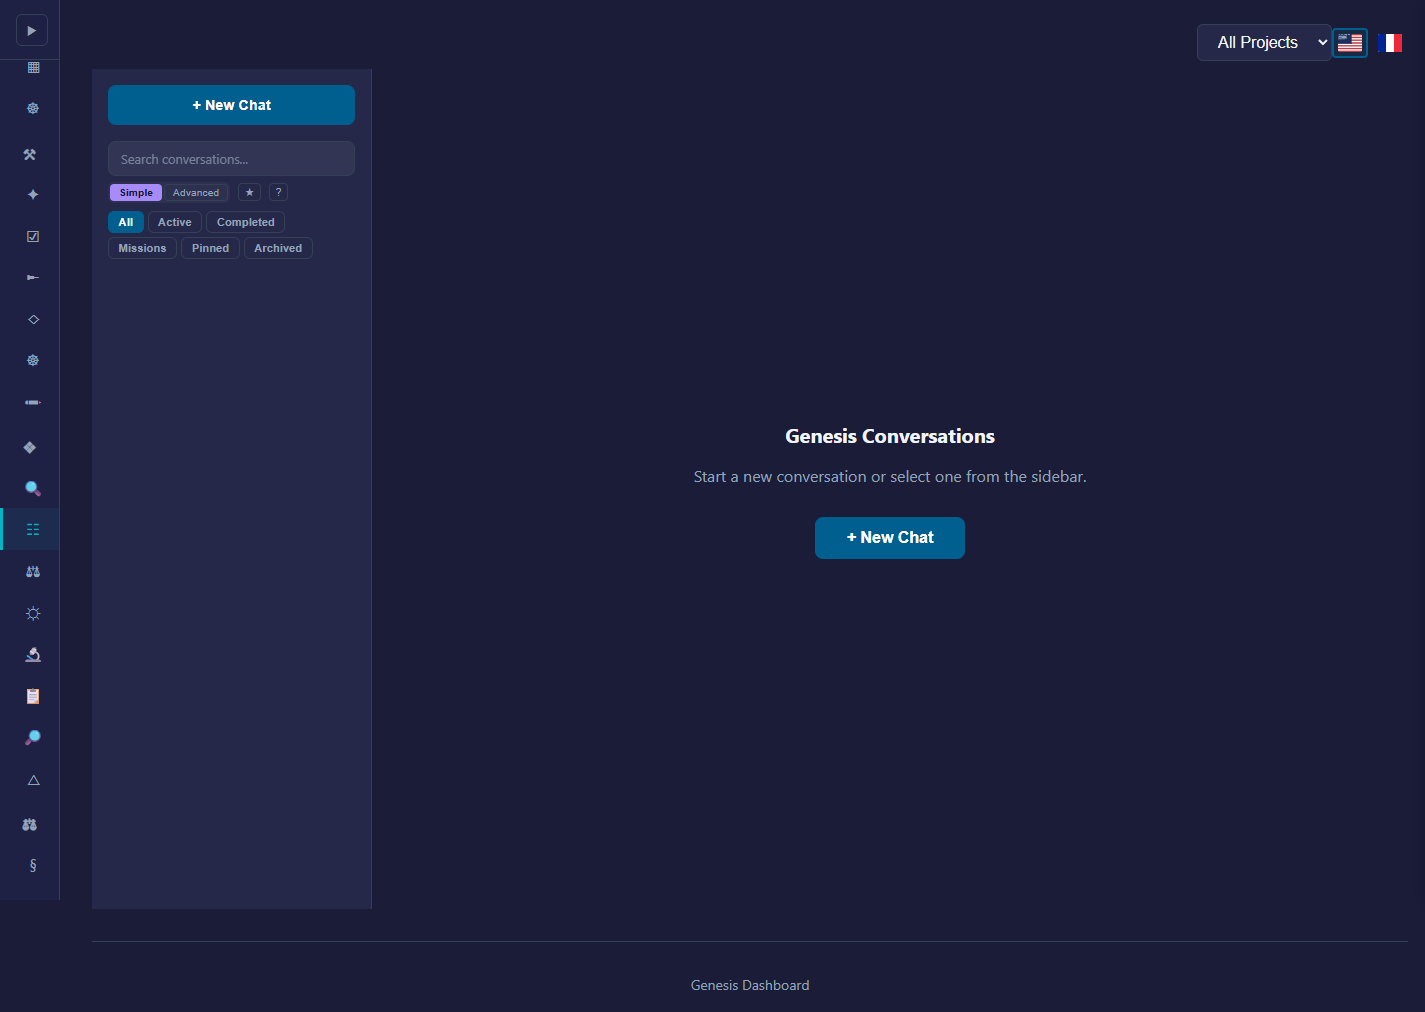
Un chat vide s'ouvre. Décrivez ce que vous voulez, en langage naturel, comme vous le diriez à un ami développeur. Exemples concrets :
- « Ébauche un service Python FastAPI avec un endpoint
/healthzet un Dockerfile. » - « Dans
my-app/, leLoginFormn'affiche pas les erreurs de validation. Ajoute un texte d'aide rouge sous chaque champ qui échoue. » - « Rédige une brève note de conception pour migrer notre module de paramètres de JSON vers YAML. N'implémente rien pour le moment. »
Astuces qui donnent systématiquement de bons résultats :
- Mentionnez le fichier ou la zone quand vous le pouvez. « le widget total du panier » bat « le truc des totaux ».
- Dites ce que vous ne voulez pas. « Ne touche pas au schéma de la base » ferme une mauvaise piste tentante.
- Un seul objectif par conversation, idéalement. Si vous voulez deux choses, deux conversations seront plus propres.
ARDS répond dans le chat. Vous parlez à un modèle de planification, pas à un coder — il pose des questions, clarifie le périmètre, propose un découpage. Répondez aux questions ; quand il a assez de matière, il propose une mission.
2. Promouvoir en mission
Quand ARDS a une image suffisamment concrète, il dépose lui-même une proposition de mission — il n'y a pas de bouton de création de mission dans le chat, et répondre « oui » ne lance rien par lui-même. Rien ne tourne encore : la proposition attend votre approbation.
La proposition arrive comme élément en attente dans la file Décisions de la barre latérale. Ouvrez Décisions, lisez-la et approuvez-la — la mission apparaît alors sur la page Missions (vous n'y êtes pas redirigé automatiquement). Vous préférez sauter la conversation ? La page Missions propose aussi un formulaire manuel Créer une mission.
3. Approuver le plan
Si votre mission a été créée avec un workflow attaché, il n'y a pas d'étape d'approbation de plan : le graphe est le plan, et vous décidez aux gates (« portes d'approbation ») du workflow — voir Runs, acceptation et changements.
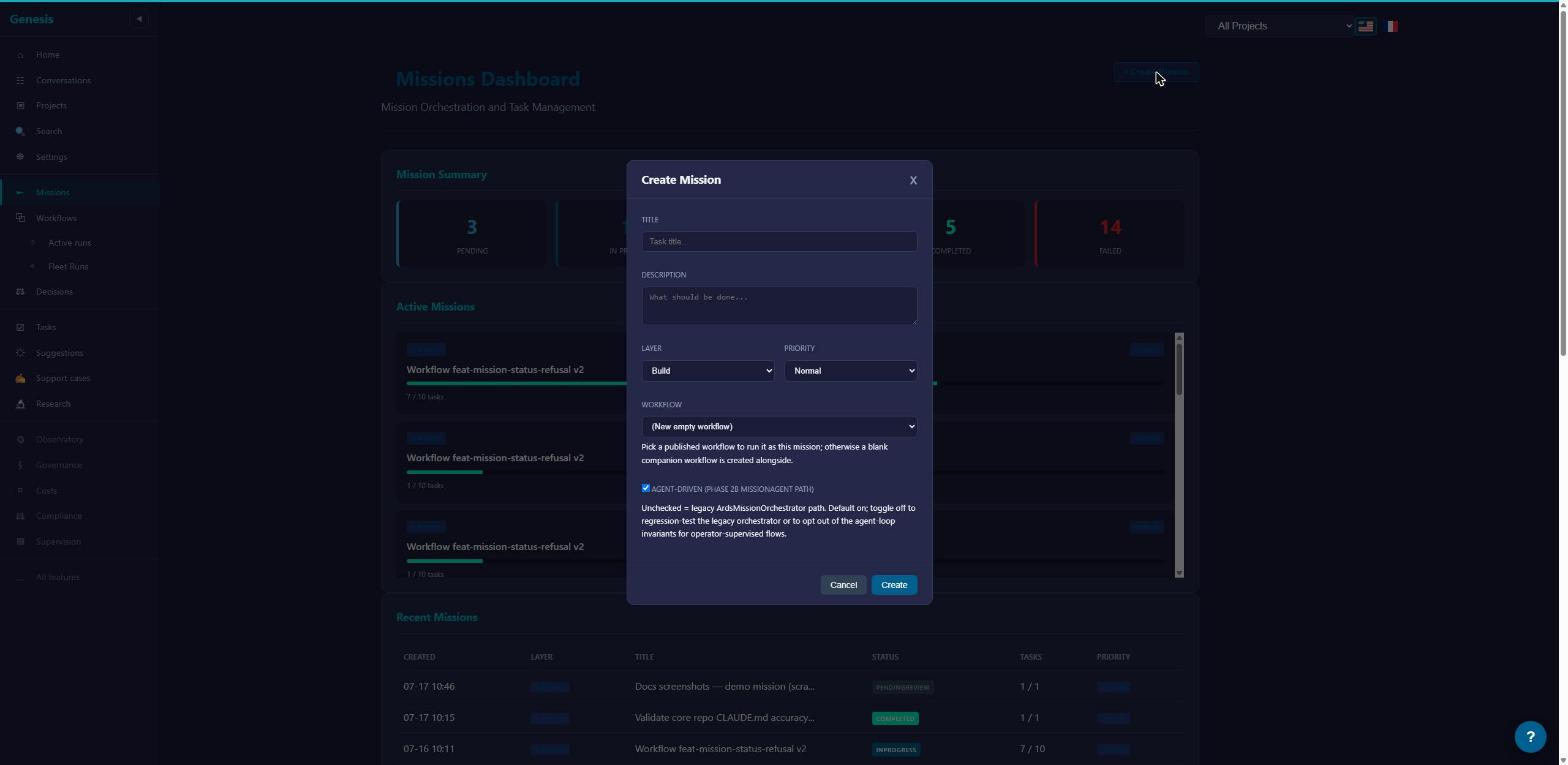
Sinon, la mission traverse ses états de planification (Planning, puis Decomposing pendant que le modèle planificateur découpe le travail en tâches individuelles — généralement 10 à 30 secondes) et s'arrête à Decomposed. Sur la page de la mission, vous voyez :
- Le plan : une liste de tâches que la mission propose d'exécuter, dans l'ordre. Chacune avec un résumé d'une ligne.
- Un bandeau — « Plan de décomposition prêt » — avec un seul bouton : Approuver le plan de décomposition (la liste des missions propose la même action).
Le plan s'approuve en bloc — il n'y a pas de sélection tâche par tâche. S'il ne vous convient pas, ne l'approuvez pas : rien n'est dispatché tant que la mission reste à Decomposed, et Annuler la mission sur la page de la mission l'abandonne.
Tant que vous n'avez pas approuvé, aucun coder ne tourne sur ce plan. (Les missions qui exécutent un workflow marquent plutôt une pause aux gates du workflow lui-même — et dans les deux cas, rien n'atterrit sur votre dépôt sans votre feu vert.) C'est le premier portail humain.
4. Regardez les coders travailler
Les tâches approuvées passent en Pending, puis InProgress quand un coder les prend. Chaque tâche affiche son avancée en direct : à quelle étape elle est, quels fichiers elle touche, quel modèle elle utilise. Pas besoin de surveiller — vous pouvez quitter la page et y revenir. ARDS envoie un email quand une tâche a besoin de votre attention ou quand la mission se termine.
Une tâche supplémentaire apparaîtra que vous n'avez jamais planifiée : l'étape de vérification de la plateforme. Sur une mission qui produit du code, une fois toutes les tâches planifiées terminées, ARDS ajoute une tâche système nommée « Verify the built application: … ». Elle ne demande aucune approbation — elle se dispatche toute seule. Son coder récupère la branche intégrée en lecture seule, construit et démarre l'application, exerce le flux principal de la mission, et rapporte un verdict en première ligne de son résultat — VERDICT: VERIFIED ou VERDICT: FAILED avec une raison — sans rien modifier ni committer. La mission ne se termine qu'une fois cette tâche finie, et le verdict est affiché avec la revue de fin de mission. Considérez tout autre chose que VERDICT: VERIFIED comme non vérifié, et lisez le résultat de la tâche pour les preuves.
Si une tâche a besoin de vous (une réponse, une clarification, une approbation), ce besoin apparaît comme un élément en attente sur la page Décisions de la barre latérale — ce n'est pas un échec, c'est votre tour. Voir États du cycle de vie pour comprendre comment les états s'articulent.
5. Revoir le résultat
Quand un coder a fini, son travail atterrit sur le miroir de revue — une copie séparée de votre dépôt. La page Revues liste les changements en attente (l'entrée de la barre latérale apparaît dès que votre première mission produit du travail).
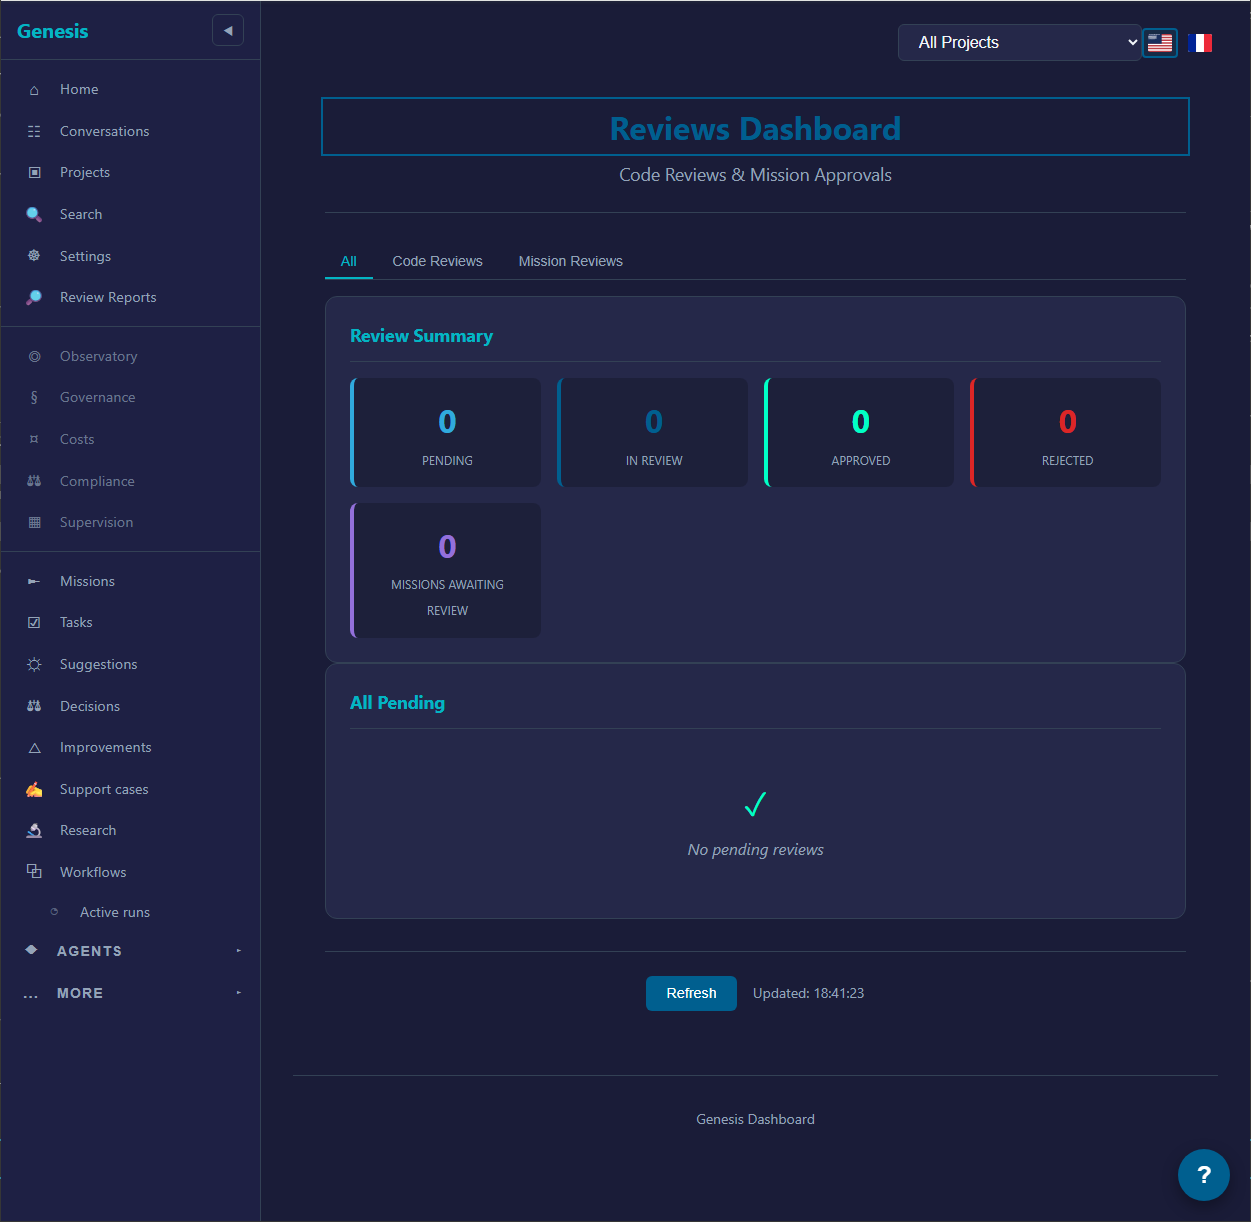
Cliquez sur une revue en attente. Vous voyez :
- Le diff, fichier par fichier.
- Un résumé d'un paragraphe expliquant ce qu'a fait le coder et pourquoi.
- Une zone de commentaire et deux boutons : Approuver / Rejeter.
Approuver propage le changement vers votre dépôt d'origine. Rejeter (une confirmation vous est demandée, avec un commentaire facultatif) décline le travail — rien n'atteint votre origine. Il n'y a pas de verbe « demander des changements » sur une revue : si vous voulez une nouvelle itération, briefez-la dans une conversation — c'est la même boucle que vous venez de parcourir.
Si votre mission a exécuté un workflow : le travail arrive sous forme d'un run que vous acceptez — ou laissez tel quel — pas comme une revue ici ; voir Runs, acceptation et changements.
Voilà toute la boucle. La majorité de ce qui se trouve derrière le tableau de bord (paramètres, gestion de flotte, observabilité, config LLM) peut être ignoré pour votre première session — on y reviendra quand vous voudrez.
Vocabulaire
Un petit glossaire des mots que vous verrez dans l'application. Chacun veut dire exactement ce qu'il dit — pas de complexité cachée.
-
Conversation — L'endroit où vous décrivez ce que vous voulez, en langage naturel. Comme discuter avec un développeur particulièrement doué pour lire entre les lignes d'un cahier des charges. Une conversation peut rester informelle indéfiniment, ou être promue en mission quand elle est suffisamment concrète.
-
Mission — L'unité de travail complète pour un changement concret — le plus souvent une conversation devenue assez précise pour être promue. Une mission vit sur sa propre branche durable et porte les runs qui construisent le changement. Et elle reste conversable : chaque mission a son propre chat, où vous pouvez demander où ça en est ou la réorienter en cours de route.
-
Workflow — Un plan réutilisable et versionné, dessiné comme un graphe de nœuds dans l'éditeur visuel. Un workflow n'exécute rien par lui-même : vous l'attachez à une mission, et c'est là qu'il tourne.
-
Run — Une exécution d'un workflow au sein d'une mission, sur sa propre branche. Vous examinez le résultat de chaque run — le diff — et vous l'acceptez ou l'écartez ; l'accepter l'intègre à la mission. Voir États du cycle de vie.
-
Tâche — Un nœud du plan en cours d'exécution, matérialisé en unité de travail de coder. Une tâche est un instantané d'exécution que vous pouvez inspecter : le résultat, le diff, ce que ça a coûté, combien de tentatives il a fallu.
-
Changement — Le delta réversible qu'un run accepté ajoute à la mission. La merge request de la mission est la composition de ses changements acceptés, et chacun peut être annulé individuellement (ce qui a été construit par-dessus suit, après confirmation).
-
Coder — L'agent IA qui fait le travail. Chaque coder tourne dans son propre conteneur, avec le modèle et les outils dont il a besoin, et pousse ses résultats vers le miroir de revue. Les coders existent en trois variantes (standard, browser, android) — les files dans lesquelles ARDS met en attente et dimensionne les conteneurs — et une tâche peut en plus puiser dans des pools de capacités partagés (un vrai navigateur, un émulateur Android, un environnement Windows). Voir Comment travaillent les coders.
-
Revue / portail d'approbation — L'étape avec un humain dans la boucle. Les coders poussent vers un miroir de revue — une copie séparée de votre dépôt — et rien n'arrive dans votre dépôt réel tant que vous n'avez pas approuvé. Vous approuvez ou rejetez chaque lot.
-
Demande d'attention (attention request) — Un signal du système indiquant qu'une personne est nécessaire. La plupart viennent des missions (« approuvez ce plan », « répondez à cette clarification ») mais elles peuvent aussi se déclencher quand un coder se bloque ou qu'une clé d'API échoue. Les demandes d'attention sont remontées dans le tableau de bord et par email.
-
Modification — Un changement qui a été approuvé et fusionné jusqu'à votre dépôt d'origine. La page Modifications est la trace de « ce qui a réellement atterri ». Avec le modèle des runs, chaque run accepté atterrit comme un changement réversible, et la merge request est leur composition.
-
Produit — Une couche de regroupement prévue au-dessus des projets. Pas en v1 : aujourd'hui, le sommet de l'arbre que vous toucherez réellement est le projet/workspace. Si vous croisez le mot « produit » dans ces docs ou dans une sortie de chat, lisez-le comme « un futur regroupement de projets » — rien dans l'UI actuelle ne pointe vers un produit.
-
Workspace / projet — Un dépôt qu'ARDS connaît. Vous en enregistrez un depuis la page Projects ; vous pouvez en ajouter ou en changer là plus tard. Chaque workspace a son propre miroir de revue.
-
GitMirror — Le service interne qui héberge les clones côté revue. Vous verrez « le miroir » dans les messages et les écrans de revue ; c'est GitMirror.
-
Fournisseur (Provider) — Un fournisseur d'IA que vous avez connecté : Anthropic, compatible OpenAI, Synthetic.new, etc. Les fournisseurs portent les clés d'API ; plusieurs fournisseurs peuvent être connectés simultanément.
-
Modèle — Un LLM précis vers lequel router le travail :
claude-opus-4-7,claude-haiku-4-5,hf:Qwen/Qwen3-Coder-480B-A35B-Instruct, etc. Modèles différents pour usages différents — voir Modèles, fournisseurs et coûts. -
Instructions de node (node instructions) — Chaque node de workflow peut porter des instructions supplémentaires superposées à son prompt. Vous les définissez à la main — par run, par projet, par tenant, ou globalement ; la plus spécifique gagne. Qu'ARDS propose de lui-même un meilleur prompt n'est pas en v1 ; si ça arrive un jour, la proposition arrivera comme une décision que vous approuvez ou refusez — rien ne s'appliquera jamais tout seul.
Voilà le vocabulaire de base. Quelques termes supplémentaires existent sur les pages avancées (l'orchestrateur, Ghost, Cycle) — voir Avancé. Lecture optionnelle.
États du cycle de vie
Missions, tâches et revues ont chacune leur machine à états. Comprendre ça prend ~2 minutes et économise beaucoup de « euh, c'est bloqué ou ça réfléchit ? » plus tard.
Toutes les missions suivent le même cycle de vie ; ce qui varie, c'est l'origine de leur plan. Aujourd'hui, la plupart des missions sont décomposées en tâches par le planificateur, et vous approuvez le plan avant que quoi que ce soit ne tourne — c'est le chemin que décrit cette page. De plus en plus, une mission porte un workflow comme plan : chaque exécution est un run sur sa propre branche ; vous acceptez le résultat d'un run — ou le laissez tel quel — et les runs acceptés s'empilent en changements réversibles qui composent le changement de la mission. Le chemin workflow-run devient le modèle d'exécution principal ; la décomposition par le planificateur reste disponible le temps de cette transition. Les issues d'un run sont dans la cheatsheet des états.
États de mission
Le chemin nominal se lit de gauche à droite : une mission est créée (Pending), se fait planifier (Planning — la décomposition en tâches, avec un arrêt en Decomposed pendant qu'ARDS attend votre approbation du plan proposé), s'exécute (InProgress), passe en PendingReview pendant que ses résultats vous attendent, et finit Completed — ou Failed si elle ne peut plus continuer. Cancelled est la sortie anticipée, et elle se propage aux tâches en cours. Une mission proposée depuis une conversation démarre un cran plus tôt encore, en AwaitingApproval : la proposition elle-même attend votre feu vert avant même que la mission n'entre en Pending.
Deux états se tiennent à côté de cette ligne plutôt que dessus :
- Paused est une mise en attente réversible. Le bouton Pause sur la page mission arrête le nouveau travail ; Reprendre remet la mission en InProgress. Rien n'est perdu pendant la pause.
- Completed, Failed et Cancelled sont terminaux — avec exactement une exception sanctionnée : démarrer un nouveau run sur une mission Completed la rouvre en InProgress. C'est la seule sortie de Completed.
Un changement d'état que la mission n'autorise pas est refusé, pas ignoré en silence : l'erreur vous donne l'état actuel de la mission et les transitions qu'elle accepte. Si une action rebondit en « invalid transition », lisez cette liste avant de réessayer — le même clic rebondira encore.
Le tableau complet des états (tous les états, terminal vs. réversible) vit dans la cheatsheet des états.
Vous pouvez agir sur une mission à tout moment :
- Annuler la mission apparaît tant que la mission n'est pas déjà Completed ou Cancelled.
- Pause / Reprendre suspendent et relâchent le travail.
- La re-planification passe par la décision de plan elle-même : au lieu d'approuver, choisissez Demander des modifications et la mission retourne en Planning pour une nouvelle décomposition. Rejeter annule entièrement la mission.
États de tâche
Une tâche est Pending pendant qu'elle attend un coder, InProgress pendant que le coder travaille, puis Completed (le résultat atterrit sur le miroir de revue), Failed (la page tâche affiche les logs et le dernier message du modèle), ou Cancelled. Quelques tâches marquent plutôt une pause dans des états spéciaux — le coder peut épuiser son budget de tours, ou attendre la fin d'une fenêtre de quota fournisseur. C'est couvert dans Dépannage, et le tableau complet est dans la cheatsheet des états.
Avoir besoin de vous n'est pas un état de tâche. Quand une tâche veut un humain — une approbation, une réponse, un choix de direction — ce besoin apparaît comme un élément en attente sur la page Decisions. Une décision en attente n'est pas un échec ; c'est un « à vous » poli, et le travail attend votre réponse.
États de revue
Les revues existent par tâche. Chaque revue représente un lot de changements poussé sur le miroir.
| État | Sens |
|---|---|
| Pending | Commit miroir prêt ; personne n'a regardé. |
| In review | La revue est ouverte ; le diff est en lecture. |
| Approved | Vous avez approuvé. ARDS poussera (ou a déjà poussé) vers votre dépôt d'origine. |
| Rejected | Vous avez décliné le travail. La branche reste sur le miroir mais n'atteint jamais l'origine. |
| Cancelled | La revue a été retirée sans verdict ; rien n'atterrit. |
Une revue encore Pending ou In review offre exactement deux boutons — Approuver et Rejeter. Rejeter demande une confirmation et accepte un commentaire optionnel.
Si un constat vient du Review Engine (le revueur automatique — voir Review Engine), chaque constat individuel porte son propre statut : Open, Investigating, Resolved, Dismissed, Deferred.
Le chemin d'un run
Quand une mission exécute un workflow, chaque exécution est un run avec sa propre petite machine à états :
| État | Sens |
|---|---|
| Proposed | Le run est en cours ou terminé ; le résultat n'est pas encore jugé. Rien n'atterrit tant que vous n'avez pas décidé. |
| Accepted | Vous avez accepté le run. Ses changements atterrissent sur la branche de la mission sous forme d'un changement réversible. |
| Rejected | Le run a été décliné — y compris les propositions rejetées automatiquement quand vous acceptez un run concurrent. Rien n'a atterri ; il n'y a rien à annuler. |
Quand un run attend à une gate, la gate met en pause les tâches du run, et la mission affiche PendingOperatorDecision jusqu'à votre décision. Les issues d'un run sont dans la cheatsheet des états ; la boucle complète d'acceptation est dans Runs, acceptation et changements.
Quand un état vous surprend
- Bloqué en Decomposing depuis plus de ~2 minutes → rafraîchissez la page ; le planificateur a parfois besoin que la page soit ouverte pour les mises à jour SignalR. Si toujours bloqué, voir Dépannage.
- Une tâche semble vous attendre → ouvrez la page Decisions ; la carte de l'élément en attente dit ce qui manque.
- Mission marquée Failed sans cause évidente → le résumé d'échec en haut de la page mission remonte l'erreur de la première tâche défaillante. Cliquez sur cette tâche pour le log complet.
Comment travaillent les coders
Un coder, c'est un conteneur Docker qui fait tourner un agent IA câblé avec un modèle, un ensemble d'outils (édition de fichiers, shell, git, MCP) et — pour chaque tâche qu'il prend — un clone de votre workspace. Les coders ne sont pas lancés un par tâche : ce sont des consommateurs de file mutualisés, et ARDS agrandit ou réduit le pool selon la demande.
Cycle de vie du conteneur
Les tâches s'empilent dans des files par outil de codage et par variante (standard, browser, android). ARDS compare régulièrement la profondeur de chaque file au nombre de conteneurs coder qui la consomment, et agit :
- Démarrage à froid — des tâches attendent et aucun conteneur ne tourne pour cette file → ARDS en démarre un. C'est pour ça que la première tâche après une période calme met un peu plus longtemps à quitter Pending.
- Montée en charge — le retard dépasse un seuil → un conteneur de plus rejoint le pool, jusqu'à un plafond.
- Travail — un conteneur prend une tâche (la tâche passe InProgress), clone votre workspace depuis le miroir de revue, et s'y met : lit des fichiers, exécute des commandes, édite, teste, itère. Tout se passe dans le conteneur — votre système de fichiers hôte et votre dépôt d'origine ne voient jamais rien. Les identifiants nécessaires (clés d'API, jetons git) sont injectés comme variables d'environnement au démarrage du conteneur.
- Fin de tâche — succès, échec ou annulation : le coder commite sur une branche du miroir et pousse. Tout ce qui n'a pas été commité est perdu — c'est voulu.
- Réutilisation — le conteneur ne meurt pas avec la tâche ; il retourne à sa file et consomme la suivante.
- Retour à zéro — quand une file est restée vide plusieurs minutes, ses conteneurs sont retirés. Un conteneur qui sort ou devient malsain est remplacé automatiquement tant qu'il reste du travail en file.
Un conteneur peut donc vivre une tâche ou plusieurs — mais les produits d'une tâche ne vivent qu'à condition d'avoir été commités sur le miroir. Ce point compte pour ce que les coders peuvent et ne peuvent pas faire, voir ci-dessous.
Au sein d'un workflow, le succès, l'échec ou le refus d'un coder est routé par les outcome arms (« bras d'issue ») du workflow — voir Anatomie d'un workflow.
Capacités du coder
Toutes les tâches tournent sur l'image coder standard (back-end, front-end, développement d'outils MCP — SDK .NET 10, Node.js, npm, frameworks de test courants). Ce qui varie par tâche, ce sont les capacités supplémentaires qui lui sont attachées, puisées dans des pools de capacités partagés :
- Navigateur — un vrai Chrome pour les tests visuels, l'automatisation navigateur ou les flux E2E qui ont besoin d'un vrai DOM.
- Émulateur — un émulateur Android pour le travail mobile.
- Outillage Windows — un environnement Windows pour les tâches qui en demandent un.
Vous ne les choisissez pas vous-même — elles sont attachées quand la tâche le demande, et la plupart des tâches n'en ont besoin d'aucune. Si vous êtes curieux de savoir comment une tâche a tourné, le détail de la page tâche montre le fournisseur qui l'a servie, la branche sur laquelle elle a travaillé, le nombre de tours et son coût.
Ce que les coders peuvent faire
- Lire, modifier, créer des fichiers dans le workspace cloné.
- Exécuter n'importe quelle commande disponible dans l'image —
dotnet,npm,pytest, etc. - Aller sur Internet pour de la doc et le téléchargement de paquets.
- Utiliser les outils MCP (le bridge ARDS) pour consulter l'état du projet, valider le travail, etc.
- Commiter + pousser sur le miroir.
Ce que les coders ne peuvent pas faire (ou ne feront pas)
- Pousser sur votre dépôt d'origine. Seul le flux d'approbation propage vers l'origine.
- Persister du travail ailleurs que sur le miroir. Seul ce qui est commité et poussé survit à une tâche ; l'état de travail du conteneur est jetable, et les conteneurs inactifs sont régulièrement retirés.
- Voir les données d'autres tenants. Le pool de coders est par tenant ; les conteneurs d'un tenant ne servent jamais les tâches d'un autre.
- Tenir une conversation directe avec vous. Si un coder a besoin d'une entrée, il lève une attention request visible dans le tableau de bord — il n'ouvre pas une fenêtre de chat.
- Modifier du code hors du workspace. Les coders sont restreints à un workspace à la fois.
Où lire les logs d'un coder
Sur toute page tâche, le lien Session du codeur en haut ouvre la vue de session en direct de cette tâche — tout ce qu'a dit et fait le coder : appels d'outils, sortie du modèle, commandes lancées. Si une tâche a échoué, c'est généralement là que se trouve la cause. Les mêmes données alimentent la page Costs (comptabilité au niveau token par tâche — voir Suivre les coûts).
Pour les runs de workflow, le visualiseur de run va plus loin : la fiche de node et le panneau Session du codeur montrent le prompt effectif exactement tel que dispatché, les fichiers touchés, un diff à la demande, et des téléchargements par fichier ou en zip. Voir Suivre un run.
Combien de temps prend une tâche
Très variable. Les petits refactorings finissent en quelques minutes ; une tâche « écrire un nouveau module avec ses tests » prend 10 à 20 minutes ; une tâche « implémenter la feature X de bout en bout » peut tourner une heure ou plus. La consommation en tokens évolue grossièrement avec le temps de mur quand c'est le même modèle qui tourne.
Modèles, fournisseurs et coûts
ARDS n'héberge pas ses propres modèles. Vous apportez les clés d'API et ARDS route le travail vers ces fournisseurs. Cette page couvre la liste des modèles, à quoi chacun sert, et comment se passe la facturation.
Familles de fournisseurs
- Anthropic Claude — la valeur par défaut recommandée. Facturation au token via votre compte Anthropic. Quatre niveaux de modèle (Fable / Opus / Sonnet / Haiku) qui arbitrent intelligence contre coût.
- OpenAI et compatibles — pris en charge via le même format de clé
sk-…. Utilisez-le pour OpenAI directement ou pour tout fournisseur qui expose une API au format OpenAI (Azure OpenAI, OpenRouter, etc.). - Synthetic.new — abonnement à forfait, pas au token. Héberge un catalogue trié de bons modèles open-weight (Qwen, Kimi, GLM, MiniMax et d'autres). Bon pour du gros volume où les coûts au token finiraient par grimper. Les modèles portent le préfixe
hf:dans leur ID. - JetBrains — sélectionnable aussi dans le dialogue d'ajout de fournisseur de la page LLM Config.
- Ollama (local) — pris en charge mais uniquement quand vous faites tourner de l'infrastructure ARDS-adjacente vous-même ; pas pertinent pour les testeurs hébergés.
Vous croiserez peut-être aussi une entrée fournisseur GitHub Copilot : un mode « apportez votre clé », adossé à un PAT GitHub fine-grained avec le scope Copilot Requests.
Vous pouvez connecter plusieurs fournisseurs. ARDS utilise des chaînes de fallback pour qu'un appel Claude qui échoue sur les crédits, par exemple, soit silencieusement retenté sur Synthetic. Les chaînes se configurent sur la page LLM Config.
Choisir un modèle
Pour votre première session, ne touchez pas aux valeurs par défaut. Le modèle de conversation par défaut est Opus ; les tâches de coder suivent les presets de la plateforme, qui choisissent un modèle par type de travail.
Quand vous êtes à l'aise, les règles grossières :
- Planification / décomposition → Sonnet. Rapide et bon pour structurer.
- Tâches d'implémentation → Opus pour les tâches difficiles, Sonnet pour la routine.
- Échafaudage de tests / boilerplate → Haiku. Un cinquième du prix d'Opus au token et parfaitement capable pour le travail répétitif.
- Gros volume sous contrôle de coût → Synthetic.new (par ex. Qwen3 Coder 480B). Forfait, donc vous pouvez laisser tourner.
Coûts visibles
Le tableau de bord Costs suit chaque dollar dépensé. Ses deux panneaux principaux sont Coûts par source (quelle partie de la plateforme a dépensé) et Coûts par modèle (où votre dépense se concentre). Au-dessus, des filtres découpent par fournisseur et par plage de dates, et basculent la base de coût entre Facturé, Équivalent API (ce que l'usage couvert par l'abonnement aurait coûté au token) et Les deux. La page montre aussi les fenêtres d'utilisation de l'abonnement, les événements de limite de débit, et un tableau des enregistrements récents.
Les tarifs Anthropic sont fixés par famille de modèles (par million de tokens, actuels en v1) :
| Famille | Entrée | Sortie | Contexte |
|---|---|---|---|
| Claude Fable | 10 $ | 50 $ | 1M tokens |
| Claude Opus | 5 $ | 25 $ | 200K tokens |
| Claude Sonnet | 3 $ | 15 $ | 200K tokens |
| Claude Haiku | 1 $ | 5 $ | 200K tokens |
Les versions nouvellement découvertes héritent des chiffres de leur famille — Opus 4.8 et Opus 4.7 se facturent toutes deux au tarif Opus. Fable est le niveau du haut, avec une fenêtre de contexte d'un million de tokens pour le travail qui demande une très grande vue d'ensemble. La liste complète et à jour est dans la référence des modèles.
Synthetic.new est au forfait par abonnement — pas de maths au token ; vous prenez un plan et vous y faites couler autant de travail que vous voulez.
Attente honnête : une tâche « répare ce bug » coûte des centimes sur Sonnet. Une mission « construire un nouveau microservice de bout en bout » couvrant plusieurs tâches Opus peut tourner à plusieurs dollars. La page Costs vous dit en temps réel.
Que se passe-t-il quand une clé manque de crédit
- Plus de crédit → vous voyez une erreur dans la mission, et (si une chaîne de fallback est configurée) ARDS retente sur le fournisseur suivant.
- Rate-limit → ARDS recule et retente. Les rate-limits longs remontent en demande d'attention.
- Clé révoquée ou invalide → la mission échoue. Ré-ajoutez la clé sur la page LLM Config.
Voir Dépannage pour les formes d'erreur précises.
Sécurité et frontières des données
La version en langage clair de « où va mon code » et « qu'est-ce qu'ARDS garde ». Si vous utilisez ARDS sur un vrai dépôt, c'est la page à lire attentivement.
Votre code
- Dépôt d'origine (le vôtre) : ARDS n'y pousse jamais sans votre clic explicite d'approbation. Il n'existe pas de mode « auto-merge » en v1.
- Miroir de revue (chez nous) : quand vous connectez un dépôt, ARDS le clone sur un serveur Git interne. Les coders travaillent contre ce miroir. Les changements approuvés sont repoussés sur votre origine à votre place.
- Conteneurs des coders : chaque coder travaille sur son propre clone du miroir, dans un conteneur du pool de votre tenant. Les conteneurs sont réutilisés d'une tâche à l'autre et retirés après quelques minutes d'inactivité — et rien de ce qu'un coder ne commite et ne pousse pas sur le miroir ne survit à la tâche.
Si vous supprimez votre tenant, tous les miroirs et l'historique de conversation partent avec. (Des sauvegardes sont conservées sur rotation pour restauration à court terme. Demandez au support si vous avez besoin des chiffres de rétention exacts.)
Vos clés d'API
- Stockées dans notre coffre de secrets (HashiCorp Vault côté plateforme).
- Injectées dans les conteneurs coder uniquement comme variables d'environnement au démarrage du conteneur.
- Jamais écrites sur disque dans le conteneur.
- Jamais loguées en clair.
- Jamais envoyées à des fournisseurs autres que celui à qui la clé appartient.
Vous pouvez les révoquer à tout moment. Soit en les retirant de la page LLM Config (on arrête immédiatement de les utiliser), soit en les révoquant chez le fournisseur — ARDS fera remonter le rejet en erreur.
Vos conversations et missions
- Stockées dans notre base de données (Postgres).
- Visibles uniquement par votre tenant.
- Utilisées en interne pour :
- L'orchestration des missions (le modèle planificateur lit la conversation qu'il planifie).
- L'historique recherchable dans le tableau de bord Intelligence (votre recherche à vous ; restreinte au tenant).
- La comptabilité des coûts (compteurs de tokens par tâche).
Nous n'entraînons pas de modèles sur vos données. Nous n'avons pas de modèle à entraîner.
L'assistant d'aide intégré Demander à Genesis répond uniquement aux questions produit — il ne peut ni voir ni modifier les données de votre projet.
Isolation des tenants
- Chaque testeur a son propre sous-domaine :
<slug>.ards.etiakorp.com. - Chaque tenant a sa propre base Postgres (base séparée par tenant dans un cluster Postgres partagé).
- Chaque tenant a son propre namespace Vault pour ses secrets.
- Les conteneurs coder sont mutualisés par tenant ; le coder d'un tenant ne peut pas voir les données d'un autre.
Les composants partagés (cluster Postgres, serveur Vault, control plane K8s) sont conscients du tenant : chaque requête est filtrée par tenant ID au niveau ligne et base.
Et les secrets dans le code ?
Si votre dépôt contient des secrets en dur et que vous les poussez via le miroir de revue, les coders les verront. Ils n'en feront rien délibérément, mais ils restent visibles. Recommandation : ne faites pas confiance au miroir pour des secrets non masqués ; rotez toute clé qui aurait vécu dans l'historique du miroir si vous décidez de quitter ARDS.
Le domaine secret-scan du Review Engine attrape les fuites évidentes (clés AWS, JWT, etc.) et les remonte en findings — voir Review Engine.
Ce qu'on logue
- Les transitions d'état des missions.
- Les démarrages, fins, échecs de tâches, avec durées et compteurs de tokens anonymisés.
- Les erreurs HTTP qui touchent le tableau de bord.
- Les métriques plateforme côté opérateur (CPU, RAM, etc.).
Les logs ne contiennent pas les prompts ni les sorties de modèle. Ils contiennent ce qu'il faut pour déboguer « pourquoi cette mission a échoué » sans faire de capture du contenu de votre conversation.
Notifications
ARDS envoie des emails quand quelque chose réclame votre attention ou que quelque chose s'est terminé. Tout ce qui apparaît par email est aussi visible dans le tableau de bord.
Évènements email possibles
- Bienvenue / activation — une fois, à la création de votre tenant. Expéditeur :
update@etiakorp.com. Le sujet mentionne l'activation du compte. - Mission décomposée — quand le plan d'une mission est prêt et attend votre approbation. Le sujet nomme la mission et le nombre de tâches. Le lien va directement sur l'écran d'approbation.
- Mission terminée — quand toutes les tâches d'une mission ont réussi.
- Mission échouée — quand une mission ne peut plus continuer. L'email résume quelle tâche a échoué et pourquoi ; le lien va sur la tâche défaillante.
- Demande d'attention — quand un coder a besoin d'une entrée humaine en cours de tâche (clarification, approbation, décision). L'email contient le texte de la question. Utilisez le lien vers le tableau de bord pour répondre ; répondre à l'email lui-même ne fonctionne pas en v1.
- Échec de tâche — quand une tâche individuelle plante (distinct de l'échec global de mission, par ex. une tâche sur cinq).
Ce sur quoi vous ne serez pas notifié par email
- L'avancée routinière des tâches (ça atterrit dans le tableau de bord uniquement).
- Les seuils de coûts (visibles dans le tableau de bord Costs).
- Les findings positifs du Review Engine (ils s'empilent sur la page Reviews).
- Les fenêtres de maintenance système — passent par la com opérateur, pas par l'email applicatif.
Domaine d'expéditeur et spam
Tout le courrier système part de update@etiakorp.com. Sur Outlook, Live et Gmail, le premier email atterrit fréquemment dans les spams — marquez l'expéditeur comme légitime la première fois et les suivants arrivent normalement.
Nous n'envoyons pas d'email marketing. Si nous devons un jour envoyer des nouvelles plateforme, ce sera par le même canal avec un préfixe de sujet clair.
Threading
Les emails relatifs à une même mission sont threadés par ID de mission. Si votre client mail montre les conversations par fil, toutes les notifications d'une mission vivent dans une seule conversation.
Répondre aux notifications
Répondre à un email système atterrit dans notre file entrante mais ne pilote pas d'action dans le produit. Pour une réponse de support, utilisez directement support@etiakorp.com. Pour répondre à une demande d'attention, cliquez jusqu'au tableau de bord.
Couper le son
Il n'y a pas encore de panneau de préférences en libre-service — le tableau de bord Settings contient les valeurs de configuration de la plateforme et un journal d'audit, pas des préférences de notification. Les destinataires et les modèles par type d'évènement sont gérés côté plateforme. Si une catégorie d'emails vous dérange, écrivez à support@etiakorp.com et nous l'ajusterons pour vous.
Workspaces et dépôts
Dans le tableau de bord, la maison d'une base de code est un projet : en enregistrer un dit à ARDS où vit votre code et en fait le terrain des missions. En coulisses, ARDS garde son propre clone de votre dépôt — la copie de travail sur laquelle les coders écrivent (vous la verrez appelée workspace dans les messages d'état) — et pousse le travail approuvé vers votre vrai dépôt. Vous ne gérez jamais le clone vous-même ; vous gérez des projets.
Il n'y a plus d'assistant de configuration séparé. Enregistrer un projet fait tout le travail : il est cloné, indexé et embarqué automatiquement, et la première mission — comme chaque approbation ensuite — arrive dans la file de décisions.
La page Projets
Projets dans la barre latérale ouvre le registre — la page s'intitule Gestion de projets. Tous les projets liste chaque projet sous forme de carte : son nom (cliquez pour rejoindre la page du projet), un badge d'état, son type, un lien vers son dépôt, et un indicateur d'avancement Aspects issu de l'embarquement.
Pendant le premier clonage, la carte affiche Cloning workspace… ; en cas d'échec, Workspace clone failed. avec une piste sur la cause probable et un bouton Try Again (ces messages s'affichent en anglais dans l'interface) — un token invalide ou un hébergeur injoignable sont les suspects habituels.
Enregistrer un projet
Le formulaire Enregistrer un nouveau projet est sur la même page :
- Nom du projet — obligatoire.
- URL du dépôt — là où vit votre code. Le formulaire s'adapte à ce que vous collez :
- HTTPS — pour un dépôt privé, ajoutez un Personal Access Token. Le formulaire précise (en anglais) la portée requise : « Required scope:
read_repository(GitLab) /reporead (GitHub). Stored encrypted; used only to clone into the mirror. » Il propose aussi un lien direct vers la page de création de token de votre hébergeur. - SSH — cliquez Generate deploy key ; ARDS génère une paire de clés ed25519 et vous montre la clé publique à coller dans la liste des clés de déploiement de votre hébergeur. Donnez l'accès en écriture : une clé en lecture seule clone très bien, mais bloque plus tard le push vers votre dépôt quand le travail est approuvé.
- Vide — autorisé. Le formulaire l'explique : « L'URL du dépôt est facultative. Laissez-la vide pour créer un projet greenfield : Genesis héberge le dépôt et crée le dépôt d'origine du client à la livraison. »
- HTTPS — pour un dépôt privé, ajoutez un Personal Access Token. Le formulaire précise (en anglais) la portée requise : « Required scope:
- Description — facultative.
- Type — Géré, Consulté ou Observé.
Cliquez Enregistrer un projet et regardez la nouvelle carte apparaître dans la liste ; le clonage, l'indexation et l'embarquement s'enchaînent tout seuls à partir de là.
Choisir le projet actif
Le sélecteur de projet vit dans la barre du haut du tableau de bord et affiche Tous les projets par défaut. Choisir un projet cadre ce que vous voyez — conversations, missions et décisions se filtrent sur lui — et des entrées propres au projet (Intelligence, Onboarding) apparaissent pour lui dans la barre latérale.
La page d'un projet
Cliquez sur le nom d'un projet pour ouvrir sa page : la description, son identifiant, la phase en cours, le lien vers le dépôt et la date de création, plus la vision du projet quand elle est renseignée (les libellés de cette page s'affichent en anglais). De là, vous atteignez les vues Intelligence et Onboarding du projet, voyez l'état des branches à travers ses missions, consultez ses canevas de design et configurez les cibles de navigation d'application.
Frontières : ce que les agents peuvent toucher
La page Projets énonce aussi les règles permanentes — Limites constitutionnelles — qui s'appliquent à chaque projet :
- Frontière (Protégé) — « .git/, branche principale, fichiers *.env » : les agents n'y touchent pas.
- Nécessite une approbation — « Fusion vers main, suppression de fichiers protégés » : seulement avec votre approbation explicite.
- Autonome — « Branches de fonctionnalité, fichiers réguliers » : les agents y travaillent librement.
C'est pourquoi le travail quotidien des agents se fait sur des branches, et pourquoi tout ce qui atterrit sur votre branche principale est d'abord passé par une approbation humaine.
Comment les changements approuvés atteignent votre dépôt
Le travail approuvé est poussé vers votre dépôt automatiquement, avec l'identifiant fourni à l'enregistrement — le Personal Access Token en HTTPS, la clé de déploiement en SSH. Il n'y a pas d'étape « publier » séparée ; c'est aussi pourquoi une clé en lecture seule finit par faire mal : le clonage a marché, mais le push d'approbation échoue.
Quand une mission exécute des workflows, le chemin a une couche nommée de plus : chaque run que vous acceptez atterrit comme un changement sur la branche de la mission, et la merge request de la mission est la pile composée de ces changements. Chaque changement peut être annulé individuellement — les changements dépendants suivent en cascade, et vous voyez un aperçu de la cascade avant que quoi que ce soit ne soit défait. Voir la pile de changements.
Canevas de design
Un canevas de design est un ensemble de maquettes visuelles — plusieurs plans disposés sur une même surface — produit pour votre projet par une tâche de design. La page du projet a un panneau Canevas de design qui liste chaque canevas produit, avec son nombre de plans (N plans) ; tant qu'il n'y en a aucun, il dit : « Aucun canevas de design pour l'instant. Lancez une tâche de design pour en créer un. »

Cliquez sur un canevas pour ouvrir la visionneuse plein écran à /projects/{id}/design/{taskId}/{slug}. Vous pouvez y naviguer et zoomer à travers les plans, exporter ce que vous voyez en PNG ou PDF, et télécharger les sources du canevas en zip (Sources (zip)). La visionneuse est en consultation et export uniquement.
Comment un canevas naît : une tâche de type design le produit. Quand la direction visuelle est vraiment ouverte, le coder esquisse d'abord quelques plans de direction en basse fidélité et vous demande de choisir entre eux — cette question arrive dans la file de décisions. Regardez les directions dans la visionneuse, répondez à la décision, et la tâche continue en développant la direction que vous avez choisie.
Une limite honnête : les canevas sont produits par des tâches, pas retouchés à la main — impossible de les éditer dans le tableau de bord. Si vous voulez qu'un canevas change, dites-le dans la mission ou la tâche qui le possède.
Régler la configuration LLM
La page LLM Config dans la barre latérale, c'est là où vous allez au-delà du « je colle une clé d'API et c'est parti » par défaut. Vous n'en avez probablement pas besoin pour votre première session. Revenez-y quand vous voudrez :
- Connecter un second fournisseur, ou une seconde clé sur le même fournisseur.
- Changer le modèle qu'utilise un site d'appel (dialogue, décomposition de mission, recherche…).
- Mettre en place une chaîne de fallback (la configuration principale échoue → on retente sur la suivante).
- Rhabiller toute la configuration en un clic avec un mode.
Un sélecteur Projet se trouve en haut de la page : System (default) modifie la configuration partagée ; choisir un projet restreint vos changements à ce projet.
Les six onglets
La page est organisée en six onglets : Fournisseurs, Outils, Préréglages, Sites d'appel, Invites, Modes.
- Fournisseurs — les fournisseurs que vous avez connectés et les identifiants (clés d'API) attachés à chacun. C'est ici que vivent les clés.
- Outils — l'outillage des agents de code pour la flotte de coders : l'outil, la variante et le modèle par défaut avec lesquels tournent les coders, et combien peuvent tourner en même temps. La plupart des testeurs n'y touchent jamais.
- Préréglages — des configurations de modèle sauvegardées, construites en étapes. L'étape 0 est la configuration principale ; les étapes suivantes forment la chaîne de fallback.
- Sites d'appel — chaque endroit où le produit appelle un modèle, groupé Research / Planning / Build. C'est ici qu'on attache un préréglage ou qu'on gère les substitutions existantes d'un site. C'est le levier principal que vous utiliserez.
- Invites — ajustements du prompt système par site : ajouter un préambule devant le prompt par défaut, ou le remplacer entièrement, avec un aperçu Invite effective.
- Modes — des bascules en un clic qui appliquent une configuration nommée sur tous les sites d'appel à la fois.
Choses courantes à faire
Ajouter un fournisseur et une clé
Ouvrez l'onglet Fournisseurs. Cliquez Ajouter un fournisseur et renseignez un Nom, le Type de fournisseur (Anthropic, OpenAI / Synthetic, Ollama ou JetBrains) et, si besoin, un Point d'accès (laissez vide pour le défaut du fournisseur). Dépliez ensuite la ligne du fournisseur et cliquez Ajouter un identifiant : donnez un Libellé à la clé, éventuellement un Groupe de limite et une Priorité, puis collez la Clé API.
Cliquez Tester sur la ligne de l'identifiant pour vérifier que la clé s'authentifie. La ligne du fournisseur a aussi son propre bouton Tester — il teste l'identifiant actif de plus haute priorité.
Un fournisseur peut porter plusieurs identifiants. Ils sont essayés par ordre de priorité, et les boutons ▲/▼ déplacent une clé plus tôt ou plus tard dans cet ordre. Une clé qui se met à échouer peut être mise en Quarantaine (et réactivée plus tard) sans la supprimer.
Choisir le modèle d'un site d'appel
Ouvrez l'onglet Sites d'appel. Les sites sont groupés par couche — Research (sites de dialogue et de recherche), Planning (décomposition de mission), Build (exécution). Trouvez la carte voulue — par exemple Dialogue, ou Mission Decomposition — et dépliez-la. Choisissez un préréglage dans le menu déroulant — Select preset — pour l'appliquer à ce site — attacher un préréglage est la façon de choisir le modèle. La section Substitutions du site en dessous liste les substitutions déjà en vigueur sur le site ; le bouton ✕ en réinitialise une à sa valeur par défaut.
Dialogue est le site le plus bavard ; la décomposition est là où s'écrivent les plans de mission. Monter ou descendre l'un des deux d'un cran de modèle est la façon la moins chère d'arbitrer entre qualité et coût.
Mettre une chaîne de fallback en place
Les chaînes de fallback vivent dans les préréglages. Ouvrez l'onglet Préréglages et créez ou modifiez un préréglage : c'est une liste d'étapes (Steps), où l'étape 0 est la configuration principale et chaque étape supplémentaire est essayée tour à tour si la précédente échoue. Attachez le préréglage aux sites d'appel qui vous intéressent depuis l'onglet Sites d'appel.
Une chaîne courante : une étape Anthropic d'abord, une étape Synthetic ensuite. Au quotidien on tourne sur votre quota Anthropic ; s'il est épuisé, l'étape Synthetic à forfait prend le relais.
À part ça, au sein d'un même fournisseur, plusieurs identifiants basculent entre eux par ordre de priorité (voir plus haut) — pas besoin de préréglage pour ça.
Appliquer un mode
L'onglet Modes porte des bascules de configuration complète nommées — des cartes comme Economy Mode, Max Intelligence, Synthetic Only, Local (Ollama) ou Reset All. Cliquez Apply sur une carte pour prévisualiser et l'appliquer sur tous les sites d'appel d'un coup. Vous pouvez aussi capturer votre configuration actuelle comme nouveau mode (Capture Current State as Mode), et un historique en bas de page enregistre qui a appliqué quoi, et quand.
Basculer sur un modèle Synthetic.new
ARDS reconnaît les modèles Synthetic par le préfixe hf: (par ex. hf:deepseek-ai/DeepSeek-V3.2). Connectez un identifiant Synthetic sur un fournisseur OpenAI / Synthetic, puis choisissez un modèle hf: dans une étape de préréglage.
À savoir
- Les changements s'appliquent immédiatement. Le prochain appel (tour de dialogue, prochaine tâche) utilise la nouvelle config. Les appels en cours finissent sur la config sur laquelle ils ont démarré.
- Chaque appel est snapshoté. La page LLM Snapshots est une visionneuse par appel — elle enregistre la configuration résolue et la provenance de chaque appel LLM. Interrogez-la par plage de temps et par site d'appel pour retracer « quel setup a produit cette sortie ». Le texte requête/réponse capturé est purgé après 7 jours ; les lignes de snapshot après 30.
- Les surprises de coût sont réelles. Monter tout d'un cran de modèle peut multiplier la dépense plusieurs fois. Surveillez la page Costs après de gros changements.
Quand laisser tranquille
Pour vos trois ou quatre premières missions, laissez les défauts en place : les sites de dialogue partent sur Opus, la recherche et la décomposition de mission sur Sonnet 4.5. La page LLM Config est puissante mais expose beaucoup — ne la réglez pas avant d'avoir senti le comportement de base.
Suivre les coûts
Le tableau de bord Costs est la source de vérité pour « combien me coûte ARDS ? ». Il tire ses chiffres de la comptabilité de tokens vivante générée par chaque appel LLM.
Facturé vs. équivalent API
L'idée maîtresse du tableau : tout l'usage n'est pas facturé. Un appel passé sur un identifiant à forfait (un abonnement Anthropic, Synthetic.new) ne vous coûte rien de plus — mais le tableau calcule quand même ce qu'il aurait coûté au prix public de l'API, pour que vous voyiez le poids réel de votre usage.
Le sélecteur Base de coût en haut de page a trois positions :
- Facturé — seulement les dollars réellement comptés (usage par clé d'API).
- Équivalent API — la valeur ≈$ de tout, comme si tout avait été compté à l'API.
- Les deux — le défaut : la dépense facturée et l'usage couvert par abonnement côte à côte.
Le panneau Aperçu des coûts reflète la base choisie, avec le nombre total d'enregistrements et les compteurs de tokens entrée/sortie. Une carte dédiée, Équivalent API (couvert par l'abonnement), porte la note « Non facturé — cet usage est couvert par l'abonnement forfaitaire ».
Quand des identifiants d'abonnement sont actifs, une carte Utilisation de l'abonnement montre aussi les fenêtres de quota du fournisseur — session (5 h) et semaine (7 j) — avec le pourcentage utilisé et l'heure de réinitialisation de chaque fenêtre.
Ce que vous voyez par défaut
La vue d'accueil affiche les 30 derniers jours. La barre de filtres propose :
- Période — les onglets 24 h / 7 j / 30 j / Tout, ou une plage personnalisée Du / Au.
- Fournisseur — tout filtrer sur un fournisseur.
Sous l'aperçu, deux panneaux découpent la dépense :
- Coûts par source — par ce qui a généré l'appel :
coding_task,research,dialogue,mission_agent,workflow,email_content,search_synthesis, etc. C'est là que vous repérez les schémas du genre « la recherche fait 30 % de mon total ». - Coûts par modèle — par modèle, tous fournisseurs confondus.
Descendre dans le détail
Cliquez une ligne de Coûts par source ou de Coûts par modèle pour ouvrir un tiroir de répartition : la dépense d'une source ventilée par modèle (Répartition par modèle), ou celle d'un modèle ventilée par source (Répartition par source).
Il n'y a pas de rapport de coût par mission. À la place, la table Enregistrements récents en bas de page liste les enregistrements individuels — horodatage, source, modèle, tokens, coût estimé — et chaque ligne renvoie vers la page qui la possède : la tâche de code, la mission, la conversation. Pour le détail par appel (la configuration exacte et la provenance d'un appel LLM), utilisez la page LLM Snapshots.
Gratuit vs. compté
- Identifiants d'abonnement (abonnement Anthropic, forfait Synthetic.new) — pas de facturation à l'appel. Leur usage apparaît en valeurs ≈$ équivalent API et s'impute sur les fenêtres de quota de l'abonnement.
- Identifiants par clé d'API — comptés au token. Chaque token entrée et sortie compte, au prix public du fournisseur.
Le tableau affiche les prix publics. Si votre relation contractuelle vous donne une remise, votre facture réelle sera plus petite que ce que la page indique.
Quotas et limites
Deux surfaces vous gardent en avance sur les ennuis de quota :
- La table Événements de limite de débit sur la page Costs liste les limites de débit récemment atteintes — horodatage, la tâche qui a touché le mur, fournisseur, modèle, et l'heure de réinitialisation.
- La page Quotas montre les fenêtres de quota d'abonnement de chaque compte avec un verdict Ouvert / Fermé jusqu'à par compte. Quand le quota d'un compte est épuisé, ARDS arrête d'y lancer du nouveau travail d'agent jusqu'à la réinitialisation de la fenêtre.
Il n'y a pas de plafond de dépense dur : ARDS ne met pas le travail en pause parce que la dépense comptée aurait franchi un seuil en dollars. Si vous voulez un garde-fou, tournez sur des identifiants d'abonnement (forfait, pas de surprise possible) ou configurez un plafond mensuel chez votre fournisseur (la console Anthropic en a un) — et surveillez la page Costs après de gros changements de configuration.
Le tableau de bord des décisions
Décisions est toujours dans la barre latérale, et c'est la file qui compte le plus : tout ce qui, dans ARDS, attend un humain atterrit ici. Partout où une demande d'attention est levée — une mission qui vous demande d'approuver ses tâches, un run de workflow bloqué sur une gate d'approbation, un coder bloqué sur une clarification, une clé de fournisseur qui a échoué — elle remonte sur cette page, à travers toutes vos missions et tous vos projets, pour que vous n'ayez jamais à écumer les pages de mission une par une pour trouver ce qui a besoin de vous.
Son sous-titre le dit sans détour : File de décisions et demandes d'attention.
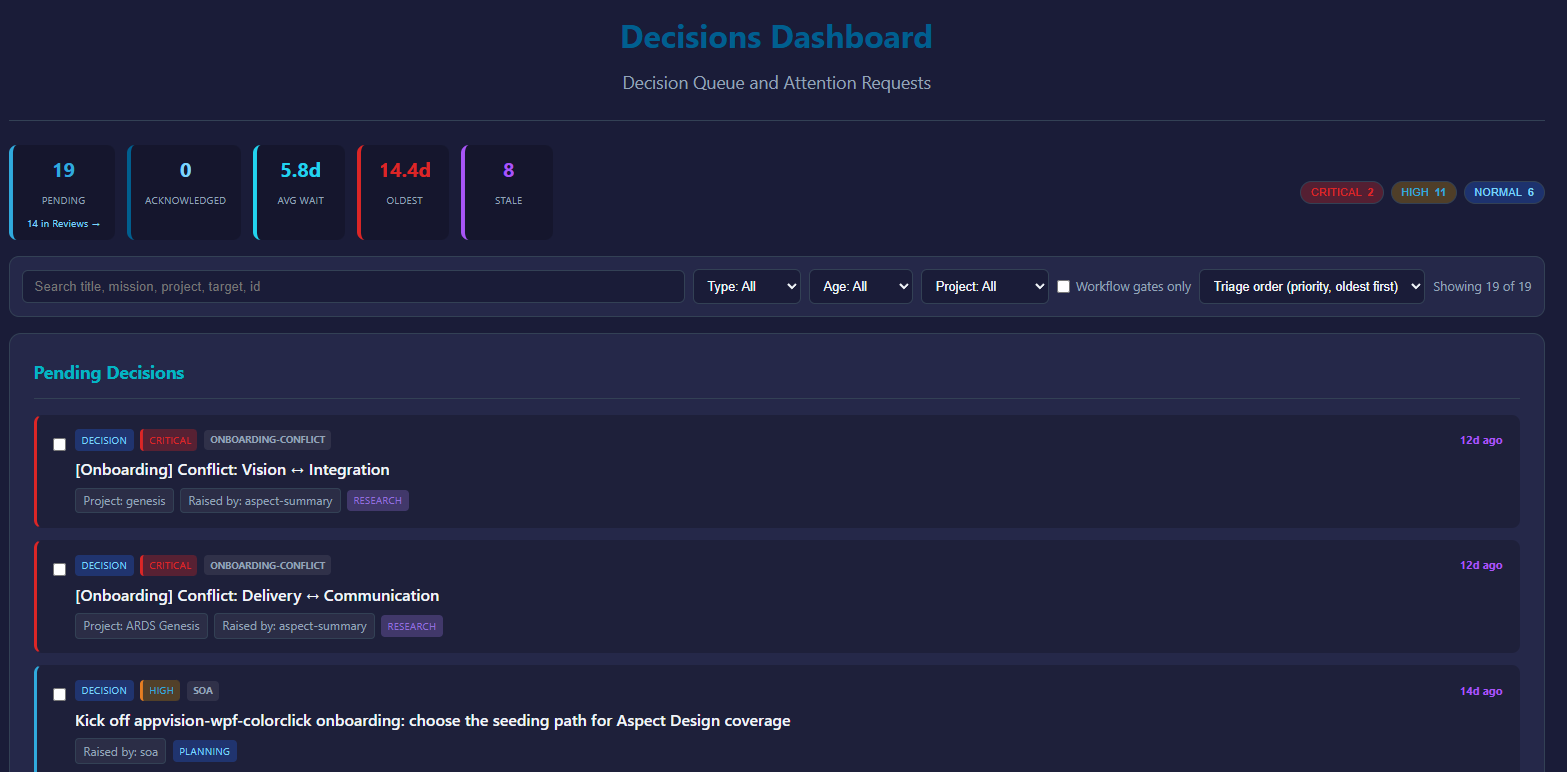
Ce qui atterrit ici
Chaque carte de Décisions en attente est quelque chose qu'ARDS ne peut pas (et ne veut pas) faire tout seul :
- Approbations de tâches — une mission s'est décomposée en tâches et attend que vous les approuviez avant que les coders ne démarrent.
- Gates de workflow — un workflow en cours d'exécution a atteint une gate d'approbation. Ces cartes portent un badge Porte de flux, et quand un run vivant attend derrière la gate, un second badge : Une exécution est bloquée sur cette porte. Une gate peut déclarer ses propres choix nommés, et même des champs typés à remplir.
- Choix de direction de design — une tâche de design a esquissé quelques directions visuelles et vous demande d'en choisir une. Regardez-les d'abord sur la page du projet (voir Canevas de design), puis répondez ici.
- Clarifications — un coder est bloqué et a besoin d'une réponse à sa question.
- Erreurs qui demandent un humain — par exemple une clé de fournisseur qui a échoué.
Chaque carte nomme son type (Decision, Approval, Input, Clarification, Error), sa priorité (Critical, High, Normal, Low), la mission et le projet dont elle vient, ce sur quoi elle décide, qui l'a levée, et depuis combien de temps elle attend. Ces valeurs de type et de priorité s'affichent en anglais dans l'interface.
Une exception délibérée : les revues de code des missions se traitent sur la page Revues, pas ici. La tuile En attente pointe vers elles — N dans Revues — pour que le compte reste honnête sans dupliquer le circuit de revue.
Lire la file
Le bandeau du haut — Statistiques de file — montre En attente, Accusé, Attente moy., Plus ancien et Obsolète (les éléments qui attendent depuis plus de 7 jours), plus des pastilles par priorité sur lesquelles cliquer pour filtrer. Chaque chiffre est calculé sur exactement les lignes affichées en dessous.
La barre d'outils permet de réduire la file : un champ de recherche (Rechercher titre, mission, projet, cible, id), des filtres par type, par âge (Dernières 24 h, 1 à 7 jours, Dormante (7 j et +)) et par projet, une case Portes de flux uniquement, et un tri — Ordre de traitement (priorité, plus ancienne d'abord) par défaut. X sur Y affichée(s) vous dit ce que les filtres cachent ; Réinitialiser ramène tout.
Agir sur une décision
Cliquez sur une carte pour ouvrir le panneau Détails de la décision. Il montre la description complète, le contexte avec lequel la décision a été levée (une gate posée sur des branches de recherche montre la sortie de chaque branche séparément), et les choix que la décision déclare.
- Accuser réception marque la décision comme vue — elle passe de En attente à Accusé — mais ne résout rien. Servez-vous-en pour signaler « je sais, j'y viendrai ».
- Résoudre est la vraie action : choisissez une résolution, ajoutez des notes si besoin, et confirmez. Quand une décision ne déclare pas ses propres choix, la liste propose Proceed, Skip, Fail/Reject et Defer (ces libellés s'affichent en anglais dans l'interface) : Proceed laisse le travail gardé continuer, Skip annule l'étape gardée, Fail/Reject la fait échouer, Defer la laisse en attente. Une gate de workflow peut à la place déclarer ses propres options nommées et des champs typés — les champs obligatoires doivent être remplis avant que Résoudre ne s'active.
Résoudre est ce qui débloque la mission, la tâche ou le run qui attendait. Voir États du cycle de vie, les gates et la gouvernance des workflows.
Résoudre plusieurs décisions à la fois
Quand les relances s'accumulent, on se retrouve souvent face à plusieurs décisions identiques à l'octet près. Cochez leurs cases et une barre groupée apparaît (N sélectionnée(s)) :
- Résoudre la sélection applique une même résolution à toute la sélection — mais seulement quand les décisions sélectionnées sont vraiment de même nature. Les sélections mélangées sont refusées avec une explication : « Ces décisions ne sont pas de même nature. Un même verbe ne peut pas signifier la même chose pour toutes : sélectionnez des décisions d'une seule nature, ou résolvez-les une par une. »
- Sélectionner les N identiques élargit la sélection à toutes les décisions visibles de même nature — cela sélectionne, cela ne résout jamais.
- Certaines décisions ne peuvent jamais être résolues en groupe : les changements de gouvernance, les gates de séparation des tâches et les gates à champs typés obligatoires doivent chacune être ouvertes et résolues seules. La barre vous dit quel garde-fou a tenu, et pourquoi.
- Le reçu reste visible après le lot : « N résolue(s), M refusée(s). Les décisions refusées restent sélectionnées et toujours en attente. »
Il n'y a pas d'accusé de réception groupé — accuser réception se fait décision par décision, dans le panneau de détails.
L'habitude
Quand une mission semble immobile, regardez Décisions — c'est en général vous qu'elle attend. L'autonomie d'ARDS est bornée par cette file : le travail s'arrête à chaque gate humaine tant que vous n'avez pas répondu, donc le débit de la file est votre débit.
- Traitez d'abord la priorité Critical et les éléments les plus anciens — ce sont eux qui retiennent le plus de travail.
- Actualiser recharge la file ; Mis à jour : HH:mm:ss indique quand la vue l'a fait pour la dernière fois.
- Une décision peut aussi se résoudre depuis la page de la mission dont elle vient ; ce tableau de bord n'est que la vue agrégée, toutes missions confondues, de la même file.
- Les décisions arrivent aussi par email sous forme de notifications de demande d'attention, mais répondre à l'email ne déclenche rien en v1 — cliquez pour rejoindre le tableau de bord et répondre là.
Rechercher dans votre historique
Deux pages vous donnent deux portes d'entrée différentes : Search fédère une requête à travers votre projet et votre historique, et la page Conversations porte son propre langage de filtres pour fouiller le dialogue passé.
Search
Tapez une phrase, appuyez sur Entrée. La requête s'éclate vers sept sources, chacune avec sa bascule au-dessus des résultats :
- Code — le code de votre projet, tel qu'ARDS l'a cloné.
- Chat — vos conversations, vos entrées comme les réponses d'ARDS.
- Expert — les connaissances expertes attachées à vos projets.
- Docs — les sources de documentation.
- Git — l'historique de commits de votre dépôt.
- CI — les résultats de pipelines CI.
- Web — le web public.
Chaque résultat ramène à l'enregistrement d'origine, et des pastilles par source au-dessus de la liste montrent combien de résultats chaque source a renvoyés. Les résultats s'affichent en mode Classés (une liste fusionnée) ou Groupés (par source).
Afficher les filtres avancés ajoute un Filtre de fichiers (par ex. *.cs *.razor), une Branche, des sélecteurs de dates Depuis / Au, et Max par source.
Synthèse IA
Cochez Synthèse IA avant de chercher et ARDS écrit une réponse par-dessus les résultats — une courte synthèse avec des citations qui renvoient vers les sources individuelles utilisées. Ça coûte un appel de modèle (il apparaît sur la page Costs en search_synthesis), donc laissez-la décochée pour les recherches rapides.
Filtrer les conversations
La barre de recherche de la page Conversations est un outil différent : un langage de filtres sur votre liste de conversations. Passez-la de Simple à Avancé et la barre accepte des requêtes comme :
title:"architecture review",body:refactor,id:a1b2— champs texte.model:opus,status:active,tag:CI— filtres d'attributs.messages:>5,tokens:>10000— seuils numériques.after:monday,after:yesterday,age:>24h— temps.is:pinned,is:archived— drapeaux.has:missions,has:tasks,missions.status:failed— relations.
Les termes se combinent avec des espaces (ET), OR entre alternatives, et un - en tête nie : -status:completed. Le bouton ? ouvre la référence de syntaxe complète avec des exemples cliquables ; le bouton constructeur de requêtes compose une requête visuellement ; et le bouton signet porte des requêtes préréglées plus celles que vous sauvegardez avec Enregistrer la requête actuelle....
Tableau de bord Intelligence
Intelligence n'est pas une vue d'historique de recherche — c'est une page de connaissances par projet. Ouvrez un projet et son entrée Intelligence apparaît dans la barre latérale, avec des onglets :
- Profil — ce qu'ARDS sait du code : langage principal, framework, système de build, complétude.
- Connaissances — les sources de connaissances enregistrées pour le projet, et la découverte pour en trouver d'autres.
- Prisms — les passes d'analyse sur le projet.
- Gouvernance — les règles de gouvernance en vigueur.
- Alertes — ce qui demande de l'attention.
Utilisez-la pour voir ce qu'ARDS comprend d'un projet — pas pour retrouver ce que vous avez dit la semaine dernière.
Ce qui n'est pas dans la recherche
- Les logs de coder — ils sont par tâche, sur la page tâche. La recherche ne les indexe pas.
- Les logs de fournisseurs externes (Anthropic, Synthetic). La recherche n'y va pas.
Rappel vie privée
Les résultats de recherche sont restreints à votre tenant. Il n'y a pas de recherche inter-tenant, et il n'y a pas de recherche opérateur sur votre tenant. (Les opérateurs voient les logs système pour le débogage, pas le contenu de vos prompts ni les sorties de modèle.)
Si vous voulez qu'un enregistrement soit supprimé — disons que vous avez collé un secret dans une conversation par accident — ouvrez un ticket de support et nous effacerons l'enregistrement précis (on le fait à la demande en v1 ; à plus long terme, un chemin self-service arrivera).
Ouvrir un ticket de support
Vous pouvez signaler un problème sans quitter ARDS. Utilisez-le pour tout ce qui semble lourd à passer par email — rapports de bug, « est-ce attendu ? », demandes de fonctionnalités.
Ouvrir un ticket
Cliquez le bouton flottant ? en bas à droite (Aide et support). Il propose deux options : Demander à l'assistant, pour les questions produit, et Signaler un problème, qui ouvre le formulaire de signalement :
- Résumé — une courte ligne. « Mission bloquée en Decomposing depuis 3 minutes » est bon. « Ça ne marche pas » ne l'est pas.
- Description — ce qu'il s'est passé, ce que vous attendiez, ce que vous avez essayé. Incluez des horodatages approximatifs (pour qu'on retrouve les logs).
- Sévérité (facultatif) — Faible / Moyenne / Élevée. Laissez vide si vous hésitez ; on triage tout de toute façon.
- Inclure une capture de la page courante — cochez et ARDS capture la page pour vous à l'envoi.
- Pièces jointes (facultatif) — ajoutez des fichiers depuis le disque : jusqu'à 20 par signalement, 10 Mo au total. Pour plus gros, passez par email.
Cliquez Envoyer. Le ticket apparaît sur votre page Tickets de support à l'état Received.
Pourquoi l'utiliser plutôt que l'email
Les tickets ouverts dans l'app sont liés à votre tenant, peuvent porter une capture de la page exacte où ça s'est mal passé, et remontent dans votre tableau de bord — vous voyez chaque changement d'état directement, sans aller voir votre boîte de réception.
L'email marche toujours (voir Obtenir de l'aide — support@etiakorp.com). Utilisez l'email quand :
- Vous ne pouvez pas vous connecter (donc vous ne pouvez pas ouvrir un ticket).
- Vos fichiers dépassent la limite in-app (20 pièces jointes / 10 Mo par signalement).
- Le problème touche à la facturation ou à la sécurité et vous préférez ne pas le poser dans le canal habituel.
Et après
On le lit. Les temps de réponse en accès anticipé sont au mieux — entre quelques minutes et quelques jours ouvrés selon le fuseau et la sévérité.
Le ticket traverse des états que vous verrez en badges :
- Received — déposé, pas encore pris en charge.
- Investigating — quelqu'un (ou une mission d'investigation) regarde.
- AwaitingReporter — on a posé une question ; le fil du ticket dit « L'équipe attend votre réponse. » — répondez là.
- Confirmed / Fixing — le bug est reproduit, puis en cours de correction.
- AwaitingVerification — un correctif est parti, et c'est à vous de trancher : « L'équipe a déployé un correctif. Veuillez vérifier s'il résout votre problème. » avec deux boutons, Confirmer la résolution et Toujours présent. Vous seul, le rapporteur, pouvez fermer cette boucle.
- Resolved — vous avez confirmé le correctif.
Un ticket peut aussi se fermer sur un verdict plutôt qu'un correctif : WontFix, CannotReproduce, Misconfiguration, Misuse ou Duplicate — chacun dit pourquoi, pour que l'issue ne soit jamais une fermeture silencieuse.
Tant qu'un ticket est ouvert vous pouvez ajouter du contexte au fil à tout moment ; ça ne change pas l'état.
Anti-patterns
- Ne collez pas de secrets. Masquez tout ce qui est sensible dans les captures. On n'a pas besoin de clés d'API ni de jetons pour diagnostiquer — ça complique juste notre rétention.
- N'ouvrez pas deux fois le même ticket. Si vous revoyez le bug, ajoutez un message au ticket existant. Plusieurs tickets pour un même bug nous ralentissent.
- Ne gonflez pas la sévérité des demandes de fonctionnalité. Ça noie le signal. Laissez la sévérité vide ou Faible ; on lit tout.
Suivi
Votre page Tickets de support liste tous les tickets de votre tenant, filtrables par projet et par état. Chaque ligne montre l'état du ticket, son indice de sévérité, et un badge SLA — Dans les temps, En retard ou Dépassé — pour voir d'un coup d'œil si ça avance. Ouvrir un ticket montre son fil complet, ses pièces jointes, et les missions d'investigation qu'ARDS a lancées pour lui.
Ce qu'est un workflow
Un workflow est un graphe d'étapes sauvegardé et versionné — lectures, appels au modèle, travail de coder, gates d'approbation — qu'une mission peut exécuter à la place d'une planification ad hoc. Quatre règles définissent le comportement des workflows dans ARDS. Apprenez-les sur cette page ; toutes les autres pages de cette section s'appuient dessus.
Un workflow n'exécute rien par lui-même
Un workflow n'exécute rien par lui-même. C'est un plan, pas un processus. La seule chose qui s'exécute dans ARDS est une mission : le workflow décrit ce qui doit se passer, et il reste inerte tant qu'une mission ne le fait pas tourner.
Un workflow rencontre une mission de deux façons exactement :
- L'attacher à une mission. Vous choisissez un workflow publié (et sa version) pour une mission — typiquement dans le dialogue d'attache à la création de la mission — et la mission le fait tourner.
- L'invoquer directement. Vous partez du workflow lui-même, et ARDS crée une nouvelle mission autour, parce qu'un run a toujours besoin d'une mission pour exister.
Les deux chemins mènent au même endroit : une mission, faisant tourner un workflow, sur la branche propre de la mission. Il n'existe pas de troisième chemin où un workflow « tournerait tout seul » en arrière-plan.
Les runs proposent ; vous acceptez
Chaque exécution d'un workflow au sein d'une mission est un run. Un run travaille sur sa propre branche et naît Proposed. De là, c'est vous qui choisissez la suite : Accept run (« accepter le run ») fait atterrir ses changements en Accepted ; un run que vous déclinez finit Rejected — écarté par un agent, ou rejeté automatiquement quand un frère concurrent l'emporte. Les états d'un run sont résumés dans la cheatsheet des états.
Accepter un run pose exactement un changement — un delta unique et réversible — sur la branche de la mission. Écarter un run ne pose rien, donc il n'y a rien à défaire. La boucle complète, revert compris, est déroulée dans Runs, acceptation et changements.
Rien n'est automatique par défaut
Les workflows portent des gates : des points où le run se met en pause et attend une décision dans votre file Decisions (« Décisions »). Aucune gate ne s'auto-approuve sauf si cette gate précise a été explicitement configurée pour ça — l'auto-résolution se règle gate par gate, elle est tracée, et désactivée par défaut. Ce n'est jamais un interrupteur global de la plateforme.
Et l'approbation change toujours de mains : vous ne pouvez pas approuver votre propre proposition. Celui qui a proposé un travail — humain ou agent — ne peut pas être celui qui l'approuve. Les gates sont couvertes dans Flux de contrôle ; les règles plus larges vivent dans Gouvernance.
L'acceptation est physique
Quand vous cliquez sur Accept run, la fusion est validée mécaniquement avant que quoi que ce soit n'atterrisse : le système valide la branche du run en exerçant le résultat fusionné — jamais par le verdict d'un LLM — et il refuse plutôt que de laisser passer quand il ne peut pas vérifier. Voyez-y une exigence que la plateforme impose à chaque acceptation, pas un exploit qu'un run en particulier démontrerait : si la vérification mécanique ne peut pas aboutir, l'acceptation refuse, et le bon réflexe est de lancer un nouveau run. Un modèle qui dit « ça a l'air bon » ne vaut jamais acceptation.
Ce qu'il y a dans la boîte
- L'éditeur visuel — là où vous dessinez, câblez, validez et publiez un graphe.
- La palette de nodes — le catalogue des types d'étapes que vous pouvez placer, organisé par catégorie.
- Les templates système — des workflows intégrés que vous clonez et faites vôtres.
- Le visualiseur de run — là où vous regardez un run, node par node, pendant qu'il s'exécute.
Comment lire cette section
Choisissez le chemin qui correspond à votre situation :
- « Je veux construire mon premier workflow. » Terminez les deux premiers titres ci-dessus, puis enchaînez : Créer votre premier workflow → L'éditeur visuel → Flux de contrôle → Cycle de vie d'un workflow.
- « Un workflow a déjà tourné et je veux comprendre ce qui s'est passé. » Enchaînez : Runs, acceptation et changements → Suivre un run → issues d'un run → Gates → Gouvernance.
Créer votre premier workflow
Dans ce tutoriel, vous construisez un workflow de cinq nodes en partant de zéro, vous le publiez, puis vous l'exécutez sur une mission. Comptez une vingtaine de minutes ; le seul prérequis est Ce qu'est un workflow — en version courte : un workflow est un graphe d'étapes sauvegardé qui n'exécute rien par lui-même ; une mission le fait tourner, et vous en acceptez le résultat.
Ce que vous allez construire
Un petit pipeline créer-lire-relire-écrire, cinq nodes en ligne :
- Un node de création workspace ouvre un workspace propre au run et fournit son handle — chaque lecture et écriture ci-dessous a besoin de ce handle câblé.
- Un node de lecture workspace charge un fichier depuis ce workspace.
- Un node llm rédige une proposition d'amélioration, en un seul tour de modèle borné.
- Un gate met le run en pause pour que vous vérifiiez la proposition.
- Un node d'écriture workspace enregistre le texte approuvé.
Le gate est le cœur de l'exercice. Chaque chemin vers une écriture doit passer par un gate. Le validateur applique cette règle — un graphe où du contenu généré peut atteindre une écriture sans point de contrôle humain ne se publie pas.
Créer un brouillon
- Ouvrez la page Workflows et cliquez sur New Workflow (« Nouveau workflow »).
- Nommez-le —
my-first-workflowconvient très bien. - L'éditeur s'ouvre : canvas vide, palette sur le côté.
Le brouillon est le seul état éditable, et un brouillon ne peut pas tourner. Rien de ce que vous faites ici n'exécute quoi que ce soit pour l'instant.
Placer et câbler les nodes
- Depuis la catégorie Workspace de la palette, ajoutez un node de création de workspace. Il produit le handle de workspace dont les nodes de lecture et d'écriture ont besoin.
- Depuis la même catégorie, ajoutez un node de lecture de fichier.
- Ajoutez un node llm. Dans son panneau, dites-lui quoi faire — par exemple : « Propose une amélioration concrète de ce fichier, en texte brut. »
- Depuis la section Structural (« Structurels ») de la palette, ajoutez une Approval Gate (« Porte d'approbation ») — glissez la tuile sur le canvas, ou cliquez dessus pour l'ajouter. Donnez-lui un libellé (« Relire la proposition ») et des instructions pour la personne qui décidera — c'est-à-dire vous, plus tard.
- Ajoutez un node d'écriture de fichier et donnez-lui un chemin cible.
Câblez maintenant le graphe :
- Connectez d'abord l'épine dorsale d'exécution : le pin
outde chaque node vers le pinindu suivant — création → lecture → llm → gate → écriture. C'est elle qui fixe l'ordre d'exécution. - Câblez le handle de workspace : la sortie
workspacedu node de création vers le pinworkspacedu node de lecture et du node d'écriture. Ces pins sont requis — laissez-en un non câblé et le graphe ne se publiera pas. - Connectez les données : le
resultdu node de lecture vers l'entrée du node llm, et leresultdu node llm vers le contenu du node d'écriture.
Notez où se trouve le gate : entre le modèle et l'écriture, pour que rien de ce que le modèle produit ne soit enregistré sans vous.
Publier — et lire la liste des problèmes
Cliquez sur Publish (« Publier »). Dans l'éditeur, publier est l'étape de validation — l'état vide du panneau Problems le dit lui-même : « Aucun problème. Publiez pour valider. » Le validateur vérifie tout le graphe, et si quelque chose ne va pas, la publication refuse et le panneau Problems signale tous les problèmes d'un coup — une liste exhaustive, pas une boucle corrige-et-réessaie. Entrées typiques d'un premier workflow : un pin requis non câblé, une écriture qu'aucun gate ne garde. Traitez la liste de haut en bas, puis publiez à nouveau ; la publication passe une fois la liste vide. (Les agents peuvent lancer la même vérification à la demande, sans tenter de publication, via l'outil workflow_validate_draft.)
Quand la publication réussit, le graphe se fige : la version 1 est désormais immuable, et chaque run de la version 1 — aujourd'hui ou l'an prochain — exécute exactement ce que vous venez de dessiner. Pour changer quoi que ce soit, vous éditez un nouveau brouillon et publiez une version 2. Détails dans le cycle de vie d'un workflow.
L'exécuter sur une mission
Un workflow n'exécute rien par lui-même : donnez-lui donc une mission.
- Ouvrez le tableau de bord Missions et créez une mission.
- Le dialogue de création propose un sélecteur de workflow, réglé par défaut sur (New empty workflow) (« (Nouveau workflow vide) »). Choisissez
my-first-workflowà la place. - Depuis la page mission, démarrez un run.

L'autre sens fonctionne aussi : Invoke (« Lancer ») sur la page du workflow crée une nouvelle mission autour de lui.
Un prérequis : le run a besoin d'un modèle et d'un provider. Si ni le node, ni un preset, ni les défauts configurés de votre tenant n'en désignent un, le run refuse de démarrer.
Le gate se met en pause pour vous
Quand le run atteint votre gate, il s'arrête. Aucun minuteur ne le fait passer outre, et aucun gate ne s'approuve jamais lui-même — l'auto-résolution n'existe que comme opt-in explicite, gate par gate, et vous n'avez pas activé celui-ci.
La pause arrive sous forme de carte dans votre file de Decisions, portant le libellé et les instructions que vous avez écrits, plus la proposition du node llm, figée exactement telle que le run la voit. Lisez la proposition, puis cliquez sur Approve (« Approuver »). Le run reprend et l'écriture s'exécute — dans le workspace isolé du run, pas sur votre dépôt. (Les gates savent aussi capturer des réponses typées, proposer des décisions nommées et expirer — voir les gates.)
Accepter le run
Quand le run se termine, il apparaît sur la page mission en Proposed : travail fait, rien d'atterri. Vous avez deux issues :
- Accept run (« Accepter le run ») — la fusion est validée mécaniquement avant que quoi que ce soit n'atterrisse ; si le système ne peut pas la vérifier, l'acceptation refuse plutôt que de croire qui que ce soit sur parole. En cas de succès, le run devient un changement sur la branche de la mission.
- Ne pas l'accepter — rien n'a atterri, donc rien à défaire. Il n'y a pas de bouton pour décliner : vous pouvez simplement laisser la proposition là où elle est, et les agents peuvent l'écarter explicitement avec l'outil
mission_run_discard. (L'autre bouton du tableau, Close-out…, relève de l'acceptation — il ouvre la checklist des reliquats qui déverrouille Accept run.)
Voilà la boucle complète : le gate a gardé l'écriture à l'intérieur du run, et l'acceptation a gardé votre mission. Runs, acceptation et changements détaille ce que fait vraiment l'acceptation.
Et ensuite
- L'éditeur visuel — tout ce que savent faire le canvas, la palette et les presets.
- Flux de contrôle : gates, branches et boucles — champs typés des gates, branchements, fan-out jusqu'à 1000 éléments, attentes de 1 minute à 28 jours.
- Cycle de vie d'un workflow — versions, déclencheurs, clonage et archivage.
- Runs, acceptation et changements — la pile de changements, le revert, les runs concurrents.
Anatomie d'un workflow
Un workflow est un graphe lisible d'un coup d'œil : des boîtes qui font chacune une chose, des fils qui les relient. Cette page nomme les pièces — exactement à la profondeur qui change ce que vous faites sur le canvas. Si vous n'en avez pas encore construit, commencez par Créer votre premier workflow, puis revenez.
L'ordre d'exécution vient de l'épine dorsale Exec. Tout le reste de cette page découle de ce fait.
Le graphe
Chaque node est une étape : lire un fichier, appeler un modèle, attendre votre approbation, écrire un résultat. Chaque node porte deux pins d'exécution, in et out. Enchaînez out vers in et vous obtenez l'épine dorsale Exec — le fil qu'un run suit du premier node au dernier. Quand vous vous demandez « qu'est-ce qui tourne ensuite ? », suivez l'épine dorsale, pas la mise en page.
La palette propose 138 types de nodes répartis en 17 catégories — voir La palette de nodes pour l'index complet. Les constructions de contrôle — gates, branches, boucles, fan-out — sont des tuiles structurelles qui ont leur propre page : Flux de contrôle.
Les pins transportent des données typées
Autour des pins d'exécution, les nodes portent des pins de données. Chaque pin a un kind, et les fils ne relient que des kinds compatibles — l'éditeur ne vous laissera pas brancher un String dans un Bool.
Six kinds sont en usage :
| Kind | Sens |
|---|---|
Exec | Rien — uniquement l'ordre d'exécution. |
Context | Le contexte de travail de la mission, consommé par les nodes génératifs. |
String | Du texte brut. |
Bool | Vrai ou faux. |
Json | Des données structurées — le cheval de trait. |
Artifact | Un livrable produit (la sortie d'un coder, un rapport compilé), passé par référence. |
Une convention à connaître : 125 des 138 types de nodes exposent un pin de sortie result de kind Json qui porte l'issue du node. Câblez-le vers l'étape suivante quand vous en avez besoin ; le laisser non câblé est parfaitement valide.
Les trois primitives génératives
Exactement trois primitives génératives appellent un modèle pour produire du nouveau :
- llm — un tour borné : entrée, réponse, terminé. Il n'a aucun outil, donc il ne peut que répondre — il ne peut toucher ni votre workspace ni quoi que ce soit d'autre.
- agent — une boucle multi-tours avec un jeu d'outils explicite et un budget obligatoire. Plusieurs flows intégrés
sys-s'appuient désormais dessus — le flow d'onboarding par aspects en dépêche à lui seul dix. Pour vos propres graphes, llm ou coder reste le premier réflexe le plus simple. - coder — une session de code complète dans son propre conteneur, travaillant dans un workspace qui n'existe que le temps du run.
Sur la palette, ces trois primitives correspondent à plus de trois tuiles : le coder existe en tuile synchrone et asynchrone, et les sites d'appel de modèle à saveur métier — décomposition de mission, review — sont des configurations d'un site, jamais de nouvelles primitives.
La règle qui les relie : les primitives proposent, les verbes engagent. Un node génératif n'écrit jamais rien de durable par lui-même. Les écritures passent par des nodes d'action séparés, et chaque chemin vers une écriture traverse une gate — rien de ce qu'un modèle produit n'atterrit sans un point de décision devant.
Les outcome arms
La plupart des nodes ont un seul pin out : ils réussissent et continuent, ou ils échouent. Un node fait exception. Le coder asynchrone se termine de l'une de trois façons — Success, Failure ou Refusal — et chacune est son propre pin d'exécution, un outcome arm (« bras d'issue ») : onSuccess, onFailure, onRefusal. Vous câblez chaque arm vers ce qui doit se passer dans ce cas-là.
Une règle change votre façon de dessiner : les arms ne reconvergent jamais. Les chemins en aval de deux arms restent séparés ; le validateur rejette un câblage qui les refusionne.
En pratique, câblez chaque arm vers une étape explicite — chaque template intégré qui utilise le coder asynchrone route les trois.
Deux nodes portent aujourd'hui des outcome arms — le coder asynchrone et service:mission:integrate ; vous ne rencontrerez pas d'arms sur d'autres tuiles.
Les sous-workflows
Un workflow peut embarquer un autre workflow publié comme un seul node — une tuile FlowRef. Sur le canvas, c'est une seule boîte. Le workflow enfant décide quelles entrées et sorties exposer ; cette petite surface de pins est sa tunnel signature, et vous la câblez comme les pins de n'importe quel autre node.
Un sous-workflow partage le run de son parent et l'acceptation de son parent. C'est de la composition, pas un appel : pas de second run à accepter, pas de seconde branche à surveiller.
Les tuiles sys- de la palette — sys-research-codebase, sys-decompose-propose et consœurs — sont des blocs de construction publiés, conçus exactement pour ça. Voir Templates système.
Params et slots
Deux mécanismes gardent un graphe réutilisable. Les paramètres de run sont déclarés sur le workflow et liés à des valeurs au démarrage d'un run — même graphe, entrées différentes à chaque run.
Un slot est un trou typé que vous déclarez là où la génération a le droit de remplir de la structure. La génération remplit le trou et rien d'autre : elle ne réécrit jamais la topologie autour, et la structure que vous avez déjà posée reste intouchable.
Ce que la publication fige
Quand vous cliquez sur Publish (« Publier ») sur un brouillon, le graphe est figé : une version publiée est immuable et protégée par une somme de contrôle, et personne — ARDS compris — ne peut la modifier en douce. À l'exécution, chaque node reçoit aussi son propre instantané d'exécution figé : rejouer une étape ré-exécute exactement cet instantané au lieu de le renégocier.
Les conséquences au quotidien sont sur la page cycle de vie ; la mécanique complète est dans le chapitre architecture.
L'éditeur visuel
C'est dans l'éditeur que vous dessinez et modifiez le graphe d'un workflow. Tout ici relève de la conception : vous façonnez le plan, une mission l'exécutera plus tard — rien ne s'exécute depuis l'éditeur lui-même.
Seul un draft est modifiable — une version publiée ne change jamais.
Ouvrir l'éditeur
Ouvrez un workflow depuis la liste des workflows. Ce que vous obtenez dépend de ce que vous avez ouvert :
- Un draft s'ouvre entièrement modifiable : la palette est à gauche, chaque node et chaque câble peut changer, et Save Draft (« Enregistrer le brouillon ») et Publish (« Publier ») sont disponibles dans la barre d'outils.
- Une version publiée s'ouvre en lecture seule. Vous pouvez inspecter chaque node, câble et réglage, mais aucune palette n'est rendue — il n'y a rien à ajouter ni à retirer. Pour modifier un workflow publié, vous créez un nouveau draft, généralement par clonage (voir le cycle de vie d'un workflow).
Si vous regardez un graphe et ne trouvez pas la palette, vous êtes dans une vue en lecture seule — vérifiez quelle version vous avez ouverte.
Le canvas
Le canvas, c'est le graphe lui-même : les nodes, les câbles, et la colonne d'exécution qui les traverse.
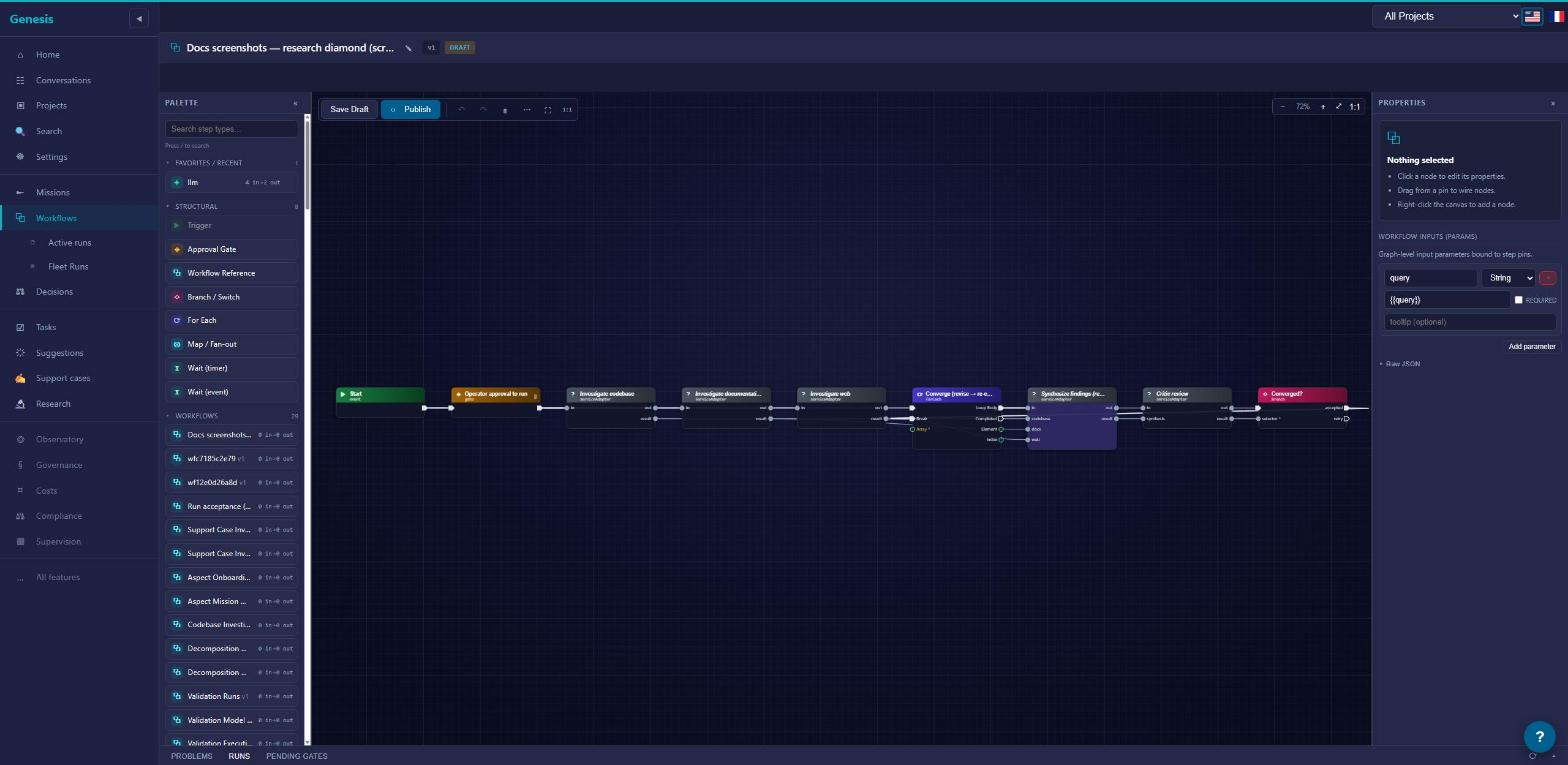
Deux choses à savoir avant de commencer à glisser :
- Direction de mise en page. Une bascule fait passer le canvas de
LR(gauche-droite) àTB(haut-bas). Elle ne change que le dessin du graphe — le graphe reste identique dans les deux cas. Les graphes larges et peu profonds se lisent souvent mieux enTB; les longs pipelines enLR. - Câblage en direct. Tirez depuis n'importe quel pin et le canvas répond pendant le geste : les pins qui peuvent accepter le câble s'allument, ceux qui ne le peuvent pas restent éteints. Relâchez sur un pin allumé pour connecter ; relâchez ailleurs et rien ne se passe.
Cliquez sur un node pour ouvrir son panneau de réglages ; glissez-le pour le repositionner.
La palette
La palette liste tout ce que vous pouvez placer — 138 types de nodes répartis en 17 catégories, plus une section structurelle.
- Les catégories regroupent les nodes par domaine (Missions, Workspace, Git, Review…). Chaque catégorie se replie et se déplie, pour ne garder ouvertes que celles que vous utilisez.
- Favorites / Recent (« Favoris / Récents ») vous laisse épingler en haut de la palette les nodes que vous utilisez sans arrêt.
- Structural (« Structurels ») est la section du flux de contrôle. Ses tuiles ne sont pas des nodes du catalogue mais les formes qui les organisent : Trigger (« Déclencheur »), Approval Gate (« Porte d'approbation »), Workflow Reference (« Référence de workflow »), Branch / Switch (« Branche / Switch »), For Each (« Pour chaque »), Map / Fan-out (« Map / Distribution »), Wait (timer) (« Attente (minuteur) ») et Wait (event) (« Attente (événement) ») — plus Comment (« Commentaire »), un cadre d'annotation titré que vous placez derrière les nodes pour décrire une région du graphe ; purement descriptif, il ne s'exécute jamais.
- Workflows (« Flux de travail ») liste les workflows publiés sous forme de tuiles — déposez-en une sur le canvas pour l'intégrer comme référence de sous-workflow.
- Shortcuts (« Raccourcis ») contient des émetteurs composites, comme le raccourci Research qui dépose une étape de recherche préconfigurée (une étape de service LLM, ou un coder configuré pour analyser).
Pour placer quoi que ce soit, glissez sa tuile sur le canvas — ou cliquez simplement sur la tuile et elle est ajoutée, à vous de la positionner.
Le catalogue complet, catégorie par catégorie, est dans la palette de nodes. Ce que fait chaque tuile structurelle est dans le flux de contrôle.
Câblage et compatibilité des pins
Chaque node expose des pins. La paire in/out est la colonne d'exécution — elle décide de l'ordre. Les autres pins transportent des données typées entre les nodes : Exec, Context, String, Bool, Json, Artifact. La plupart des nodes livrent leur sortie sur un pin Json nommé result.
L'éditeur impose les types pendant le câblage : une sortie String ne se connecte qu'aux entrées qui acceptent un String, et la surbrillance pendant le glisser vous montre exactement lesquelles. Vous ne pouvez pas créer un câble mal typé : un graphe qui se câble est un graphe dont les données, au minimum, s'emboîtent.
Le sens de chaque genre de pin, et le rapport entre la colonne d'exécution et le flux de données, sont couverts dans l'anatomie d'un workflow.
Les presets sur un draft
Les nodes génératifs portent un sélecteur de preset : choisissez un preset et le node est lié à ce lot modèle/fournisseur.
Ce que vous choisissez sur le canvas est le défaut d'auteur, pas le dernier mot. Au dispatch, les liaisons de presets posées à n'importe quelle portée — globale, projet ou client — sont résolues et la plus spécifique gagne — elle bat ce que vous avez posé ici. Si rien n'est lié nulle part, le run retombe sur le défaut intégré plutôt que d'échouer. Les détails sont dans les presets.
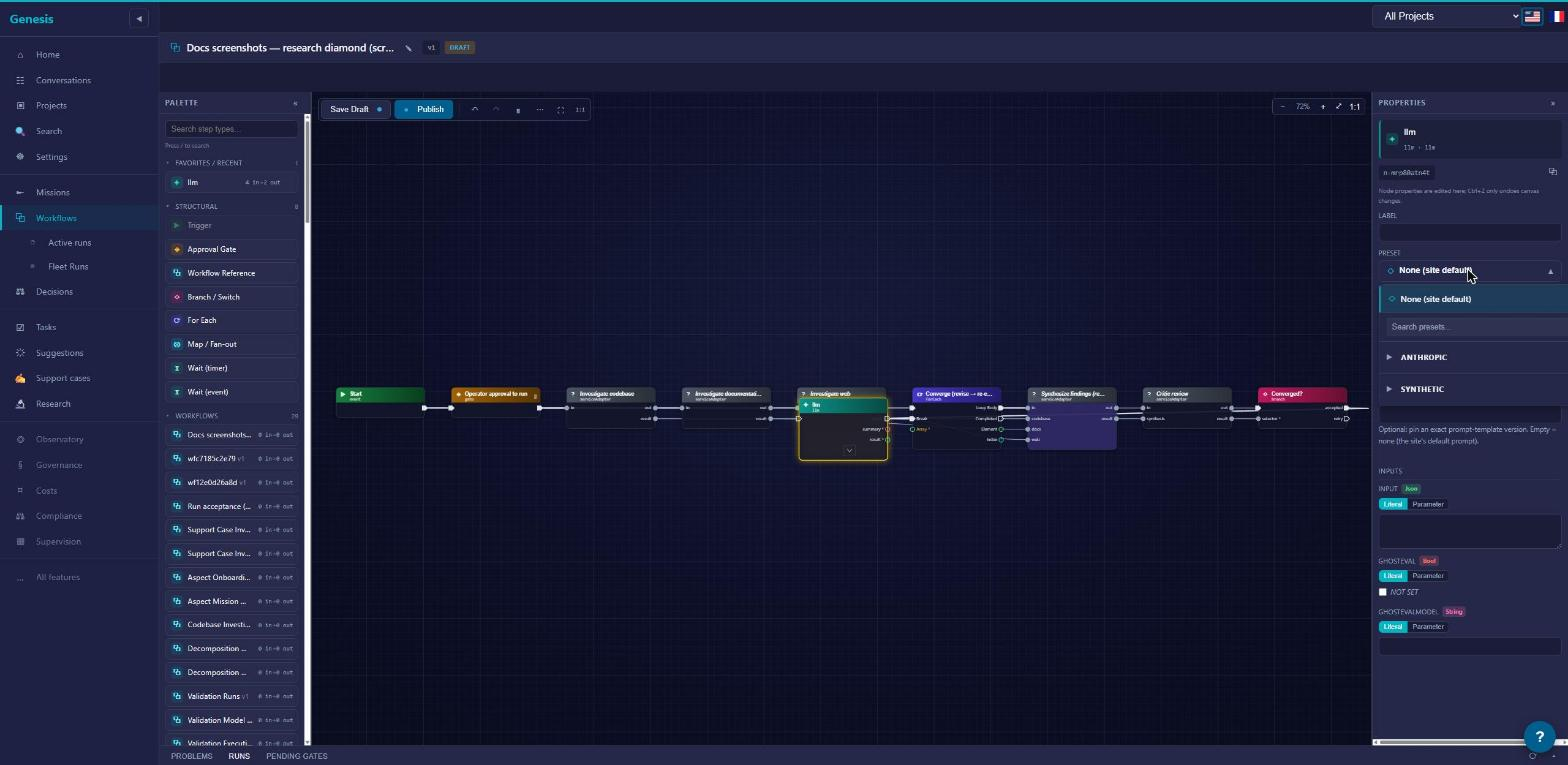
Définir des node instructions
Le texte de tâche d'un node vit dans son champ Instructions : sélectionnez le node et écrivez-le dans le panneau de réglages. Il fait partie du graphe — la publication le fige avec tout le reste.
Les nodes coder et agent peuvent en plus porter une liaison d'instructions — un texte de surcharge qui remplace les instructions rédigées au dispatch, sans toucher au graphe publié. Les liaisons, leurs portées et la précédence (run > project > tenant > global) sont couvertes dans les node instructions.
Publier est l'étape de validation
Il n'y a pas de bouton Valider séparé. Dans l'éditeur, cliquer sur Publish (« Publier ») lance toute la validation — l'état vide du panneau Problems le dit lui-même : « Aucun problème. Publiez pour valider. » Si quelque chose ne va pas, la publication refuse et le panneau rapporte tout ce qu'il trouve d'un coup — une liste de problèmes exhaustive, pas un arrêt à la première erreur. Descendez la liste, corrigez, publiez à nouveau ; la publication passe une fois la liste vide. (Les agents peuvent lancer les mêmes vérifications à blanc, sans tenter de publication, via l'outil MCP workflow_validate_draft.)
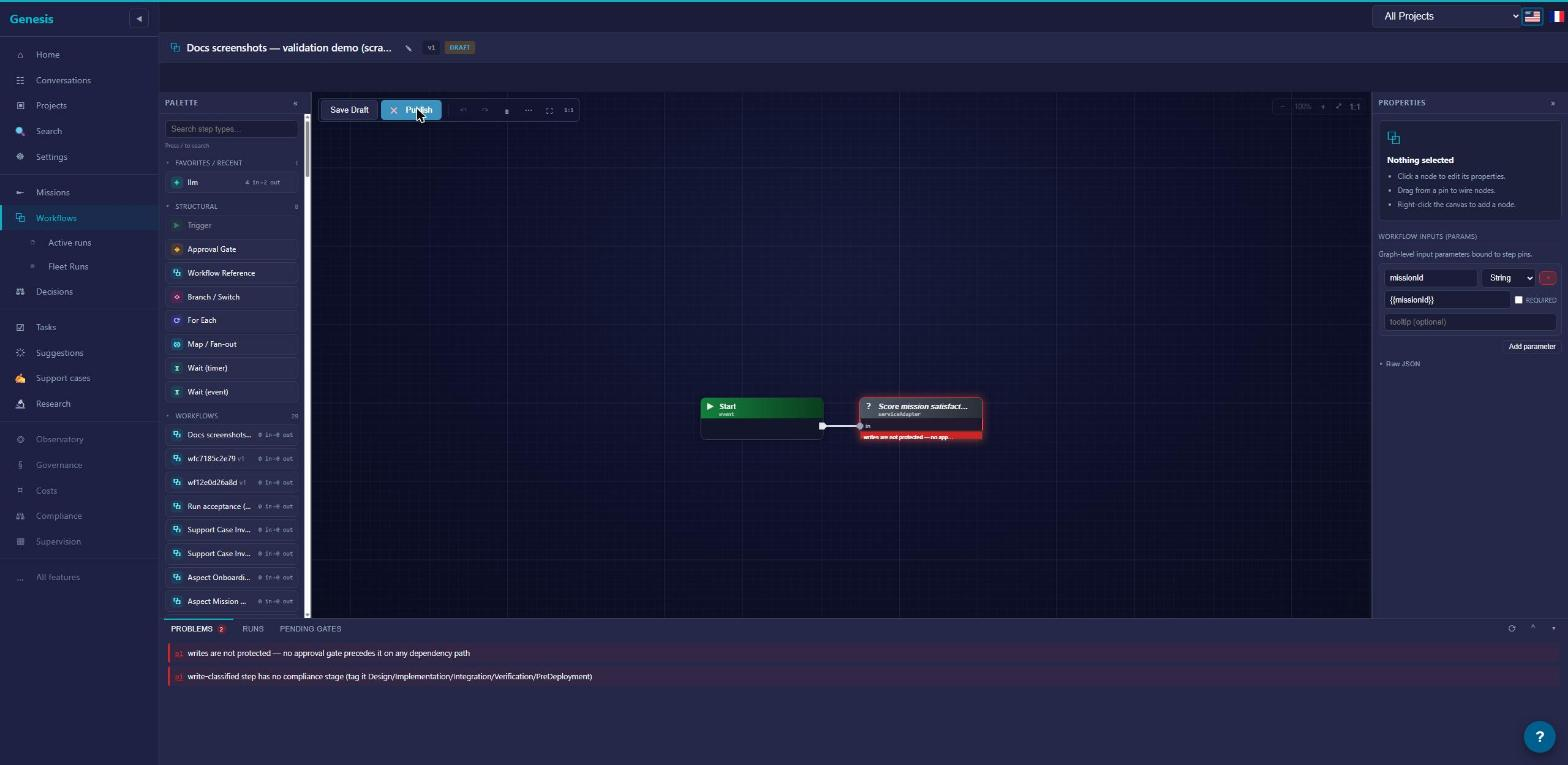
Un Publish réussi fige le draft en une version publiée immuable — à partir de là, le graphe ne change plus jamais (voir le cycle de vie d'un workflow).
Si votre draft est gouverné — il écrit quelque part qui exige des contrôles — publier depuis l'éditeur injecte les nodes de contrôle requis au sein même de la publication : ils atterrissent dans le graphe publié marqués comme injectés (les runs affichent un badge d'origine), plutôt que d'apparaître d'abord sur votre canvas. Pour relire les contrôles injectés avant de publier, passez par le chemin agent : l'outil MCP workflow_materialize les écrit dans le draft, où vous les lisez comme n'importe quel node que vous auriez placé vous-même. Ce qui rend un draft gouverné, et quels contrôles arrivent, c'est dans la gouvernance.
Flux de contrôle : gates, branches et boucles
Les nodes font le travail ; le flux de contrôle décide quels nodes tournent, quand, et sous quelle approbation. Les tuiles que vous insérez vivent dans la section Structural (« Structurels ») de la palette — glissez une tuile sur le canvas, ou cliquez dessus pour l'ajouter (l'éditeur). Les tuiles : Trigger (« Déclencheur »), Approval Gate (« Porte d'approbation »), Workflow Reference (« Référence de workflow »), Branch / Switch (« Branche / Switch »), For Each (« Pour chaque »), Map / Fan-out (« Map / Distribution »), les deux tuiles d'attente — Wait (timer) (« Attente (minuteur) ») et Wait (event) (« Attente (événement) ») — et Comment (« Commentaire »), un cadre d'annotation titré qui décrit une région du graphe et ne s'exécute jamais. Cette page couvre les blocs de décision et de répétition ; Workflow Reference — intégrer un autre workflow — est couvert dans Anatomie, et Trigger relève des déclencheurs, dans le cycle de vie.
Une règle façonne tout le reste ici : tout chemin vers une écriture passe par une gate. Le validateur l'impose — vous ne pouvez pas publier un graphe où un node qui écrit est atteignable sans une décision humaine placée devant lui.
Gates
Une gate met le run en pause et vous demande de décider. Vous donnez à chaque gate un label et des instructions — le texte que lit le décideur quand la gate se déclenche. Pendant qu'elle attend, la gate figure dans votre file de décisions (Décisions).
Une gate peut capturer des données, pas seulement une approbation. Ajoutez des champs typés — String, Number, Bool, Json ou Enum — et les valeurs saisies par le décideur sortent de la gate sur son pin response, disponibles pour tous les nodes en aval.
Pour les décisions d'aiguillage, donnez à la gate des décisions nommées : chacune devient un bras sortant étiqueté en langage humain (« On expédie » / « À retravailler »), et le run continue sur le bras que le décideur choisit.
Une gate peut porter un timeout. Si personne ne décide à temps, la gate fait ce que vous avez choisi à l'écriture : faire échouer l'étape, ou la sauter et continuer. Aucune gate ne s'approuve jamais elle-même — l'auto-résolution est un opt-in par gate que vous configurez délibérément, jamais un défaut (gouvernance).
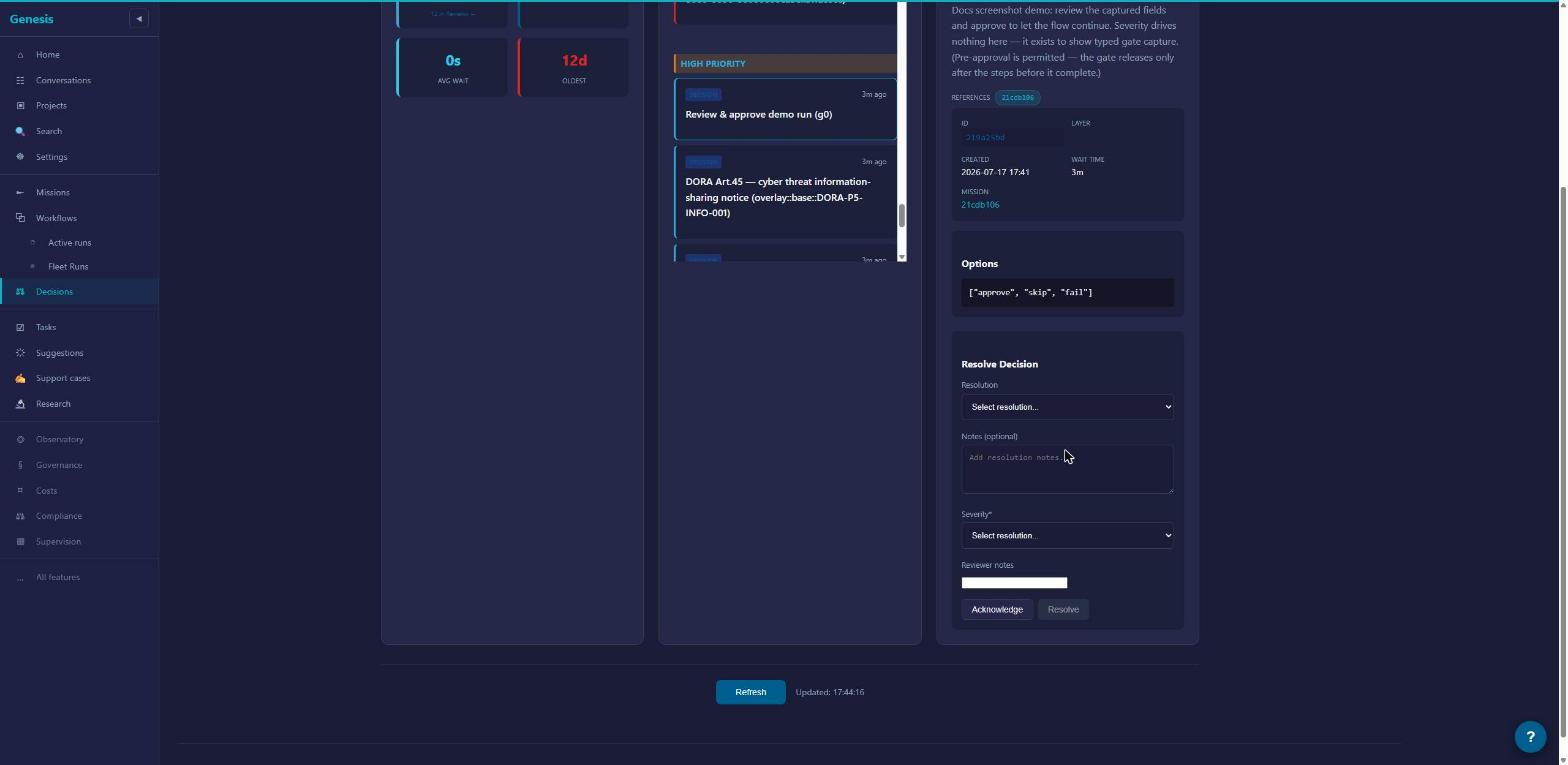
Branch
Branch — la tuile Branch / Switch (« Branche / Switch ») — aiguille sur des données plutôt que sur un humain. Vous écrivez une liste ordonnée de cas ; à l'exécution, le premier cas qui correspond gagne, et le run continue sur le bras de ce cas. Un cas correspond de deux façons : donnez-lui une valeur à comparer au sélecteur câblé, ou donnez-lui une expression — une règle booléenne — et ce cas devient un bras Switch, qui route par règle plutôt que par valeur. Chaque Branch a exactement un bras else pour tout ce qui ne correspond pas. Une fois les bras divergés, ils restent séparés — voir les règles du validateur ci-dessous.
Loop
Loop répète une étape jusqu'à ce que son résultat soit accepté, avec un maximum de 10 tentatives. C'est un bloc hérité : retiré pour les nouvelles créations, vous ne trouverez donc pas de tuile Loop dans la section Structural. Les workflows publiés qui en contiennent un tournent toujours, inchangés. Pour tout ce que vous créez aujourd'hui, prenez ForEach ci-dessous.
Fan-out en parallèle (MapFanOut)
MapFanOut — la tuile Map / Fan-out (« Map / Distribution ») — exécute le même corps une fois par élément d'une liste, en parallèle. Vous le pointez sur un pin source — la sortie amont qui porte la liste —, vous nommez la variable d'élément que lit le corps, et il déploie jusqu'à 1000 éléments.
Le corps est volontairement petit : une seule étape du catalogue, ou un sous-workflow quand une étape ne suffit pas (Anatomie couvre les sous-workflows). La forme naturelle tient en trois nodes : une étape de préparation qui charge la liste, le corps par élément, et une étape de réduction qui agrège les résultats. Les éléments tournent normalement indépendamment ; si certains doivent en attendre d'autres, déclarez des dépendances entre éléments frères et le fan-out s'exécute comme un petit graphe de dépendances plutôt qu'une mêlée.
Fan-out un par un (ForEach)
ForEach — la tuile For Each (« Pour chaque ») — parcourt la même liste un élément à la fois, dans l'ordre, et permet de sortir en avance dès qu'une condition est remplie.
Son corps prend deux formes, mutuellement exclusives :
- Corps intégré — une étape du catalogue (ou un sous-workflow) exécutée une fois par élément, avec une condition d'arrêt optionnelle vérifiée entre les éléments.
- Région Loop Body — câblez le Loop Body de la tuile vers un petit sous-graphe multi-étapes fait d'étapes simples du catalogue, avec un Branch qui pilote le pin Break vivant quand il faut s'arrêter tôt. Vous obtenez un vrai corps multi-étapes sans détacher un sous-workflow ; imbriquer d'autres tuiles structurelles dans la région reste rejeté.
Lequel choisir ? MapFanOut quand les éléments sont indépendants et que vous voulez du débit. ForEach quand l'ordre compte, quand chaque élément doit voir les effets du précédent, ou quand vous voulez vous arrêter dès qu'un élément réussit.
Wait
Deux tuiles, deux comportements :
- Wait (timer) (« Attente (minuteur) ») met le run en pause pour une durée fixe — de 1 minute jusqu'à 28 jours.
- Wait (event) (« Attente (événement) ») met le run en pause jusqu'à ce que quelque chose se produise ailleurs dans la plateforme. Six types d'événements sont actifs :
mission.created,conversation.completed,support-case.created,incident.created,batch.completed,mr.merged.
Finally
Finally sert au nettoyage — libérer un bail, clore un workspace, poster un résumé. Quoi qu'il enveloppe, le nettoyage s'exécute exactement une fois, que le flux environnant réussisse, échoue ou soit annulé. Utilisez-le quand une étape acquiert quelque chose qui ne doit pas fuir.
Une réserve : Finally n'a pas de tuile dans la palette. Aujourd'hui, il se rédige dans le payload du graphe lui-même — le chemin d'authoring agent/MCP — et ne se place pas depuis l'éditeur.
Les règles qu'applique le validateur
Quand vous publiez un draft avec Publish (« Publier ») — ou que vous exécutez les mêmes contrôles à blanc avec l'outil workflow_validate_draft — tout est vérifié d'un coup et chaque problème est signalé ensemble (cycle de vie). Pour le flux de contrôle, trois règles comptent le plus :
- Les bras restent isolés. Les cas d'un Branch, les décisions nommées d'une gate et les bras d'issue (Anatomie) ne reconvergent jamais en aval. Un bras qui ne mène nulle part est une impasse valide, pas une erreur.
- Les corps de fan-out restent plats. Un corps de MapFanOut est une étape du catalogue ou un sous-workflow ; un corps de ForEach est cela — ou une région Loop Body câblée d'étapes simples. Dans tous les cas, impossible d'imbriquer davantage de contrôle structurel dans le corps lui-même. Besoin de plus ? Mettez-le dans un sous-workflow.
- La dominance des gates. Tout chemin de dépendance vers un node qui écrit doit traverser une gate. Si une route contourne la gate et atteint une écriture, la publication est refusée et la liste de problèmes la nomme.
La palette de nodes
La palette est le panneau de l'éditeur visuel depuis lequel vous glissez — ou cliquez — pour ajouter des étapes à un draft. Elle contient 138 types de nodes répartis en 17 catégories. Cette page est l'index : une ligne honnête par node, pour trouver le bon sans avoir à le poser d'abord. Les entrées et sorties exactes ne sont volontairement pas ici — les signatures au niveau des pins appartiennent à la référence agent.
Les primitives proposent, les verbes engagent : les nodes cerveau n'écrivent jamais par eux-mêmes, les nodes de service qui changent l'état sont gardés par un gate sur chaque chemin, et le delta de dépôt du run ne fusionne que lorsque vous acceptez le run.
Quatre conventions couvrent presque tout, énoncées une seule fois :
- Chaque node vit sur la spine Exec. Les fils d'exécution ordonnent les étapes ; les fils de données portent les valeurs. Voir Anatomie d'un workflow.
- Presque chaque node émet un
resultJSON. 125 des 138 se terminent par une sortieresultunique que les nodes en aval consomment. - Quelques-uns vous tendent en plus une poignée typée — un id de run, un id d'incident, un id de lease, ou un workspace — que vous câblez directement dans les nodes qui en ont besoin.
- Les familles viennent par trois pour le fan-out. Beaucoup de familles de services livrent un node prepare (ou load), un node par item fait pour vivre dans un corps de fan-out, et un node reduce qui replie les items ensemble (analyze, aggregate, finalize, score ou submit-report). Les lignes marquées (par item) ci-dessous sont la pièce du milieu.
Une chose que vous ne trouverez pas dans ce catalogue : les blocs de contrôle de flux. La section Structural (« Structurels ») de la palette porte les tuiles — Trigger (« Déclencheur »), Approval Gate (« Porte d'approbation »), Branch / Switch (« Branche / Switch »), For Each (« Pour chaque »), Map / Fan-out (« Map / Distribution »), Wait (timer) (« Attente (minuteur) »), Wait (event) (« Attente (événement) »), Workflow Reference (« Référence de workflow ») et le cadre Comment (« Commentaire ») — et Finally, qui n'a pas de tuile et se rédige dans le payload du graphe. Tous ont leur propre page.
Les nodes cerveau
Six des 138 sont génératifs — ils appellent un modèle. Quatre sont des call-sites câblés avec un rôle fixe :
Missions:Decompositiontransforme l'objectif d'une mission en une proposition de découpage en tâches.Coder:Defaultdispatche une tâche de coder et attend l'artifact résultant.Coder:AsyncDefaultdispatche du travail de coder et route la suite sur des outcome arms (« bras d'issue ») —onSuccess,onFailureouonRefusal. C'est l'un des deux nodes multi-arm de la palette — l'autre estservice:mission:integrate, dans Git ; voir Les outcome arms.ReviewEngine:Defaultrevoit un artifact et produit des constats.
Deux sont génériques :
llmexécute un tour de modèle borné sur son entrée. Il n'a pas d'outils, par construction.agentexécute une boucle d'agent multi-tours avec un toolset explicite et un budget obligatoire. Plusieurs flows intégréssys-l'utilisent désormais — l'un en dépêche dix. Pour vos propres graphes,llmou un coder reste le premier réflexe le plus simple, sauf si vous savez pourquoi il vous le faut.
La discipline est la même pour les six : les primitives proposent, les verbes engagent. Un node cerveau n'écrit jamais nulle part par lui-même. Sa sortie n'atteint le monde qu'à travers des nodes de service explicites en aval — et sur chacun de ces chemins, un gate se dresse avant l'écriture.
Nodes de lecture, d'action et de service
Les 132 autres nodes sont des adaptateurs, en trois genres :
- Lectures — 20 nodes. Elles récupèrent de l'état et ne changent rien : les détails d'une mission, un fichier d'une branche, l'avancement d'onboarding d'un projet. Posables partout sans risque.
- Actions workspace — 2 nodes.
workspace:write_fileetworkspace:createécrivent, oui — mais uniquement dans un workspace sandboxé. Ils ne touchent jamais votre dépôt. - Opérations de service — 110 nodes. Une opération de plateforme chacune : créer un incident, classifier un case de support, lancer un check de conformité, pousser une branche. Celles qui changent l'état de la plateforme sont exactement ce que la règle de dominance des gates garde.
Le genre se lit généralement dans l'id : read: lit, service: opère, et les verbes fichiers vivent sous workspace:.
Index des catégories
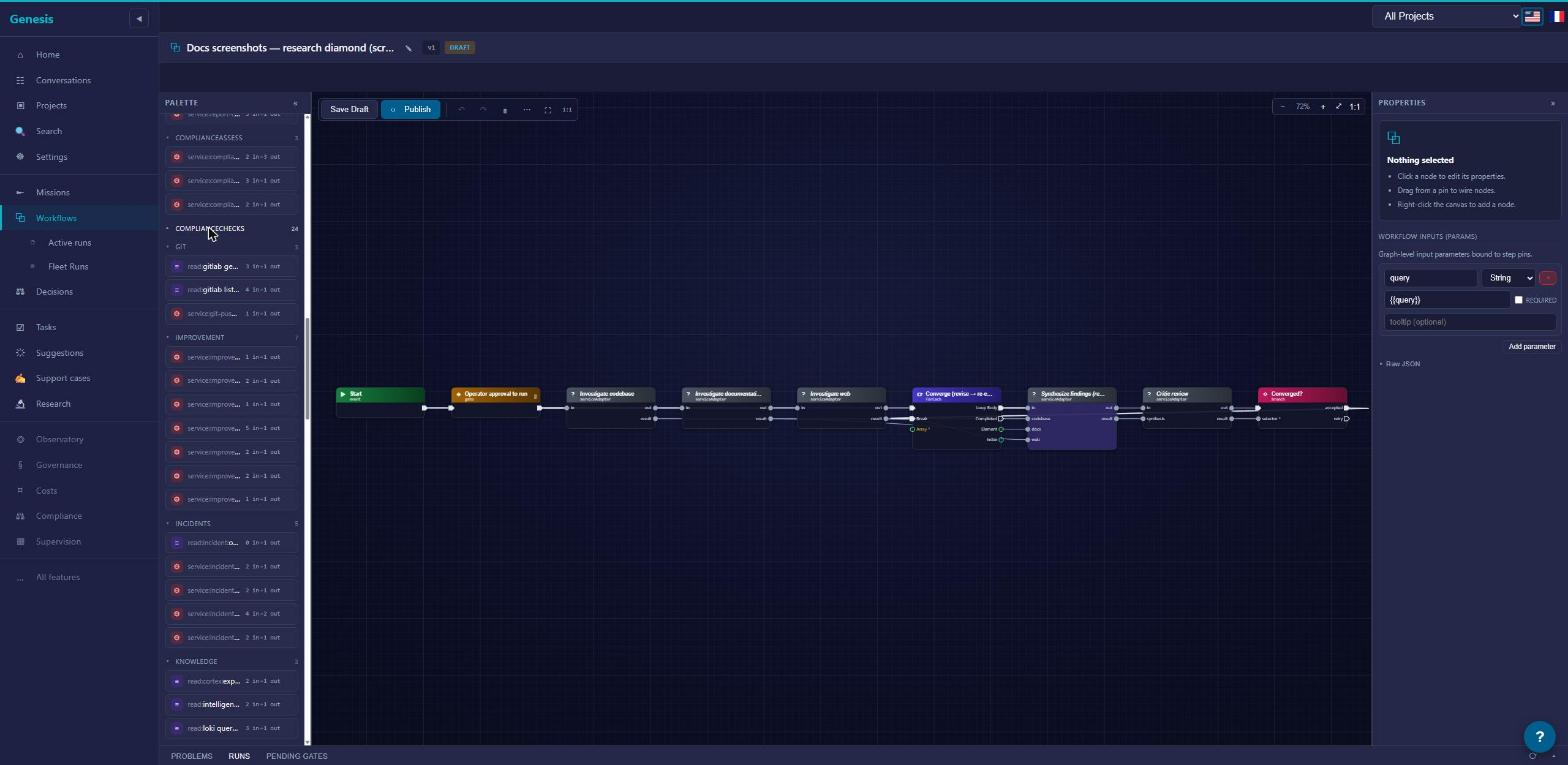
Seize catégories ici, classées selon la fréquence à laquelle un testeur en a besoin — la dix-septième, Legacy, clôt la page. Dépliez un bloc pour voir ses nodes.
Missions — planifier, décomposer et scorer le travail de mission · 12 types de nodes
| Node | Ce qu'il fait |
|---|---|
Missions:Decomposition | Transforme l'objectif d'une mission en une proposition de découpage en tâches (génératif). |
read:mission_get | Lit les détails et l'état d'une mission. |
read:mission:stale | Liste les missions encore ouvertes sans activité récente. |
read:task-deps:resolve | Résout l'ordre des dépendances entre les tâches d'une mission. |
read:boundary:validate | Vérifie qu'un élément enfant proposé reste dans le périmètre de son parent. |
read:task-routing:route | Choisit le bon routage pour une tâche d'après sa description et ses exigences. |
service:satisfaction:score | Score dans quelle mesure le résultat d'une mission satisfait son objectif. |
service:decomposition:propose | Propose une décomposition pour une mission à partir d'un objectif et de constats. |
service:decomposition:coder | Produit une décomposition orientée coder pour une mission. |
service:proposal:record | Enregistre un élément proposé sur une mission. |
service:decomposition:materialize-tasks | Matérialise une décomposition acceptée en vraies tâches. |
service:mission:create | Crée une nouvelle mission — le seul node qui engendre une mission enfant. |
Workspace — lire et écrire dans des workspaces sandboxés · 6 types de nodes
| Node | Ce qu'il fait |
|---|---|
workspace:read_file | Lit un fichier d'un workspace. |
workspace:list_files | Liste les fichiers sous un chemin de workspace. |
workspace:write_file | Écrit un fichier dans un workspace (sandbox uniquement — jamais votre dépôt). |
workspace:create | Crée un workspace neuf et retourne sa poignée. |
workspace:merge | Fusionne plusieurs workspaces en un seul et retourne la poignée fusionnée. |
service:workspace:copy-tree | Copie une arborescence source dans un workspace. |
Git — lire des fichiers de dépôt et pousser du travail · 4 types de nodes
| Node | Ce qu'il fait |
|---|---|
read:gitlab_get_file | Lit un fichier d'une branche de dépôt. |
read:gitlab_list_files | Liste les fichiers sous un chemin de dépôt. |
service:mission:integrate | Intègre la branche d'une tâche de coder dans la branche de la mission, en routant l'issue sur les arms onSuccess / onRefusal / onFailure (multi-arm). |
service:git-push:default | Pousse le travail du run sur une branche. |
Research — enquêter, synthétiser, critiquer · 6 types de nodes
| Node | Ce qu'il fait |
|---|---|
service:research:investigate-codebase | Enquête dans la base de code pour une requête. |
service:research:investigate-docs | Enquête dans la documentation pour une requête. |
service:research:investigate-web | Enquête dans les sources web pour une requête. |
service:research:synthesize | Synthétise les constats codebase, docs et web en une seule réponse. |
service:research:critique | Critique une synthèse au regard de la requête d'origine. |
service:research:record-findings | Enregistre des constats de recherche sur une mission. |
Review — les pipelines de revue de code et UX · 7 types de nodes
| Node | Ce qu'il fait |
|---|---|
ReviewEngine:Default | Revoit un artifact et produit des constats (génératif). |
service:review-engine:discover-targets | Découvre ce qu'un projet offre à revoir dans un domaine donné. |
service:review-engine:review-target | Revoit une cible découverte (par item). |
service:review-engine:submit-report | Soumet le rapport de revue assemblé pour une session. |
service:ux-review:discover-pages | Découvre les pages d'un projet pour la revue UX. |
service:ux-review:review-page | Revoit une page à la recherche de problèmes UX (par item). |
service:ux-review:submit-report | Soumet le rapport de revue UX pour une session. |
Validation — validation physique, pilotage de cibles et runs par lots · 20 types de nodes
| Node | Ce qu'il fait |
|---|---|
service:canary:prepare | Prépare un run canary et ses cas de test. |
service:canary:run-test-case | Exécute un cas de test canary (par item). |
service:canary:analyze | Analyse les résultats du run canary. |
service:run-acceptance:prepare | Prépare les cas de validation pour accepter un run. |
service:run-acceptance:run-built-target | Exerce une cible construite pour un run (par item). |
service:run-acceptance:analyze | Analyse les résultats de la validation d'acceptation. |
service:run-target:lease | Prend un lease sur une cible en marche à piloter ; retourne un id de lease. |
service:run-target:drive-case | Pilote un cas contre la cible sous lease (par item). |
service:run-target:release | Libère le lease de la cible. |
service:llm-preset-validation:load | Charge les cellules de validation de presets à exécuter. |
service:llm-preset-validation:run-cell | Exécute une cellule de validation de preset (par item). |
service:llm-preset-validation:evaluate | Évalue un run de validation de presets. |
service:validation-runs:load | Charge un run de validation de modèles à partir de modèles et de prompts. |
service:validation-runs:run-model-group | Exécute un groupe de modèles (par item). |
service:validation-runs:record-execution | Enregistre la réponse ou l'erreur d'une exécution. |
service:validation-runs:finalize | Finalise un run de validation de modèles. |
read:validation-runs:group-executions | Lit les exécutions enregistrées pour un groupe de modèles. |
service:batch-processing:create-batch | Crée un batch à partir d'un ensemble de chunks. |
service:batch-processing:process-chunk | Traite un chunk du batch (par item). |
service:batch-processing:aggregate | Agrège les chunks traités d'un batch. |
Knowledge — interroger bases de connaissances, experts et logs · 3 types de nodes
| Node | Ce qu'il fait |
|---|---|
read:intelligence_knowledge_query | Interroge la base de connaissances d'un projet. |
read:cortex:expert-query | Pose une question à un expert de domaine. |
read:loki_query_range | Interroge les logs sur une plage de temps. |
Communication — parler et rapporter · 2 types de nodes
| Node | Ce qu'il fait |
|---|---|
service:dialogue:send | Envoie un message dans une conversation. |
service:report-compile:default | Compile un rapport titré et l'émet comme artifact. |
Scaffolding — générer et exécuter le scaffolding d'un projet · 9 types de nodes
| Node | Ce qu'il fait |
|---|---|
service:scaffolding:generate | Génère une proposition de scaffolding pour un projet. |
service:scaffolding:save-plan | Sauvegarde un plan de scaffolding pour un projet. |
service:scaffolding:approve | Marque la proposition de scaffolding approuvée. |
service:scaffolding:reject | Marque la proposition de scaffolding rejetée. |
service:scaffolding:execute | Exécute le plan de scaffolding sauvegardé. |
service:scaffolding:execute-step | Exécute une étape du plan (par item). |
service:scaffolding:finalize | Finalise le run de scaffolding. |
read:project-profile | Lit le profil d'un projet. |
read:scaffolding:plan-steps | Lit les étapes du plan de scaffolding sauvegardé. |
Improvement — le cycle de vie des propositions d'amélioration · 7 types de nodes
| Node | Ce qu'il fait |
|---|---|
service:improvement:propose | Enregistre une nouvelle proposition d'amélioration. |
service:improvement:validate | Valide une amélioration proposée. |
service:improvement:promote | Promeut une amélioration validée. |
service:improvement:reject | Rejette une amélioration, avec une raison. |
service:improvement:complete | Marque une amélioration terminée. |
service:improvement:fail | Marque une amélioration échouée, avec une raison. |
service:improvement:rollback | Annule une amélioration (rollback), avec une raison. |
Support — le cycle de vie des cases de support · 8 types de nodes
| Node | Ce qu'il fait |
|---|---|
read:support:case-context | Lit le contexte complet d'un case de support. |
service:support:classify | Classifie un case de support. |
service:support:investigate | Lance une investigation sur un case de support. |
service:support:apply-verdict | Applique un verdict à un case, y compris les liens de doublon. |
service:support:escalate | Escalade un case. |
service:support:request-verification | Demande une vérification sur un case. |
service:support:resolve | Résout un case vers un état terminal. |
service:support:link-investigation | Lie un case à la mission qui l'investigue. |
Incidents — créer, classifier et clore des incidents · 5 types de nodes
| Node | Ce qu'il fait |
|---|---|
service:incident:create | Crée un incident et retourne son id. |
service:incident:classify | Classifie un incident. |
service:incident:timeline-entry | Ajoute une entrée à la timeline d'un incident. |
service:incident:close | Clôt un incident. |
read:incident:overdue | Liste les incidents en retard. |
Onboarding — onboarding de projets et de charters · 17 types de nodes
| Node | Ce qu'il fait |
|---|---|
service:project-onboarding:start | Démarre l'onboarding d'un projet. |
read:project-onboarding:progress | Lit l'avancement d'onboarding d'un projet. |
read:project-onboarding:design | Lit le design d'onboarding d'un projet. |
service:onboarding:decompose | Décompose une intention d'onboarding en étapes. |
service:onboarding:approve | Marque une décomposition d'onboarding approuvée. |
service:onboarding:deny | Marque une décomposition d'onboarding refusée. |
service:aspect-onboarding:load-charter | Charge les aspects d'un charter pour l'onboarding. |
service:aspect-onboarding:collect-analyses | Rassemble les résultats d'analyse par aspect d'un run en un seul tableau. |
service:aspect-onboarding:complete-matters | Termine chaque matter dont l'aspect est achevé, fait avancer le suivant, et finalise le charter quand tous sont terminés. |
service:onboarding:update-design-concern | Écrit la phase et les notes d'un aspect dans le tracker de design du projet. |
service:aspect-onboarding:run-aspect | Exécute un aspect d'un charter (par item). |
service:aspect-onboarding:advance | Fait avancer l'onboarding par aspects d'un charter. |
service:aspect-onboarding:determine | Dispatche la revue de découverte qui produit une détermination de projet (le résultat arrive plus tard sous forme d'événement). |
service:aspect-onboarding:refresh-summaries | Rafraîchit tous les résumés d'aspects et re-détecte les conflits entre aspects. |
read:project-onboarding:concerns-settled | Lit si les préoccupations d'onboarding d'un projet sont toutes réglées. |
service:project-onboarding:apply-determination | Replie les réponses d'une détermination dans le tracker de design du projet. |
service:aspect-onboarding:reconcile | Termine les matters réglés par les déterminations et finalise le charter quand tous le sont. |
Agents — les primitives génératives · 4 types de nodes
| Node | Ce qu'il fait |
|---|---|
Coder:Default | Dispatche une tâche de coder et attend l'artifact résultant (génératif). |
Coder:AsyncDefault | Dispatche du travail de coder et route l'issue sur les arms onSuccess / onFailure / onRefusal (génératif ; l'un des deux nodes multi-arm). |
llm | Un tour de modèle borné sur son entrée — sans outils (génératif). |
agent | Une boucle d'agent multi-tours avec toolset explicite et budget (génératif ; utilisé par plusieurs flows intégrés sys-). |
ComplianceChecks — checks réglementaires déterministes · 24 types de nodes
Des checks déterministes — la plateforme les évalue mécaniquement ; aucun modèle n'écrit un verdict de conformité. Groupés par famille réglementaire : cra-* (Cyber Resilience Act), pld-* (responsabilité produit), aiact-* (AI Act), nis2-* (NIS2).
| Node | Ce qu'il fait |
|---|---|
service:compliance:sca-check | Vérifie les résultats d'analyse de composition logicielle (dépendances). |
service:compliance:clause-map | Vérifie le mapping des clauses d'un contrat. |
service:compliance:roi-completeness | Vérifie la complétude d'une soumission ROI. |
service:compliance:incident-timeliness | Vérifie la timeline d'un incident contre les délais de déclaration. |
service:compliance:cra-sbom | CRA : vérifie le SBOM soumis. |
service:compliance:cra-sca | CRA : vérifie les composants déclarés (analyse de composition). |
service:compliance:cra-secure-update | CRA : vérifie le canal de mise à jour sécurisé. |
service:compliance:cra-techdoc | CRA : vérifie la documentation technique. |
service:compliance:cra-ce-marking | CRA : vérifie les preuves de marquage CE. |
service:compliance:cra-reporting | CRA : vérifie les obligations de déclaration. |
service:compliance:pld-disclosure-pack | PLD : vérifie le pack de divulgation. |
service:compliance:pld-provenance | PLD : vérifie la provenance des composants. |
service:compliance:pld-update-channel | PLD : vérifie le canal de mise à jour. |
service:compliance:pld-retention | PLD : vérifie les règles de rétention. |
service:compliance:aiact-techdoc | AI Act : vérifie la documentation technique. |
service:compliance:aiact-registration | AI Act : vérifie l'enregistrement. |
service:compliance:aiact-gpai-doc | AI Act : vérifie la documentation GPAI. |
service:compliance:aiact-logging | AI Act : vérifie les obligations de logging. |
service:compliance:aiact-transparency | AI Act : vérifie les obligations de transparence. |
service:compliance:aiact-conformity | AI Act : vérifie les preuves de conformité. |
service:compliance:aiact-retention | AI Act : vérifie les règles de rétention. |
service:compliance:aiact-serious-incident | AI Act : vérifie le traitement des incidents graves. |
service:compliance:nis2-incident-timeliness | NIS2 : vérifie les délais de déclaration d'incident. |
service:compliance:nis2-retention | NIS2 : vérifie les règles de rétention. |
ComplianceAssess — les runs d'évaluation de conformité · 3 types de nodes
| Node | Ce qu'il fait |
|---|---|
service:compliance-assess:prepare | Prépare un run d'évaluation de conformité ; retourne les ids de run et de profil. |
service:compliance-assess:probe | Sonde un élément d'évaluation (par item). |
service:compliance-assess:score | Score un run d'évaluation de conformité. |
Legacy
Legacy — 1 type de node
Un seul node de la palette est legacy : service:research:llm, une étape de recherche des débuts, supplantée par le node générique llm. Le validateur le bloque à la publication dans les nouveaux drafts. Les workflows que vous avez déjà publiés sont des graphes figés : ils continuent de se résoudre tels quels.
Templates système
ARDS embarque deux catalogues de workflows intégrés, et ils jouent des rôles différents. Un template de la galerie est un exemple que vous clonez et qui devient le vôtre ; une brique sys- est un workflow publié que vous embarquez. Tout le reste de cette page découle de cette distinction.
Deux sortes de workflows intégrés
La galerie de templates contient 22 templates en lecture seule. Chacun montre, sous forme de workflow, la forme d'un vrai flux de la plateforme — décomposition, balayages de revue, gestion d'incident. Vous ne pouvez ni exécuter un template directement, ni l'éditer sur place : vous cliquez sur Clone (« Cloner »), ce qui vous donne un Draft éditable qui vous appartient. À partir de là, c'est un workflow ordinaire — à vous de le renommer, le recâbler et le publier.
Ce qu'un template n'est pas : un câblage vivant vers la plateforme. Cloner Mission lifecycle et exécuter votre clone exécute votre graphe — cela n'exécute ni ne remplace le pipeline de mission interne de la plateforme. Les templates enseignent la forme ; ils ne portent pas la machinerie.
Les briques sys- sont différentes : 19 workflows publiés, semés dans chaque tenant. Vous ne les clonez pas pour vous en servir — vous en embarquez une en déposant sa tuile dans votre propre graphe, comme référence de sous-workflow. La brique embarquée s'exécute à l'intérieur de votre run, se met en pause à ses propres gates, et atterrit via votre acceptation ; c'est de la composition, pas une exécution séparée (voir Anatomie d'un workflow).
Quelques noms figurent dans les deux catalogues — sys-run-acceptance est à la fois un template de la galerie et une brique semée. L'endroit où vous le rencontrez dit lequel vous tenez : la galerie se clone, la palette s'embarque.
La galerie de templates
Les 22 templates se répartissent en 9 catégories. Clonez celui que vous voulez et lisez le graphe node par node dans l'éditeur — ils sont là pour ça.
Mission (6)
| Template | Ce qu'il fait |
|---|---|
Mission lifecycle (sys-mission-lifecycle) | Le flux par défaut : décomposer l'objectif, approuver le plan, lancer en éventail un coder par tâche, passer les résultats en revue. |
Decompose (direct) (sys-decompose-direct) | Un gate d'approbation, puis un plan de tâches proposé — la variante sans recherche. |
Decompose (research-first) (sys-decompose-research) | Recherche codebase/docs/web en parallèle, synthèse, puis un plan de tâches informé par la synthèse. |
Decompose (grounded coder) (sys-mission-decompose-grounded) | Un coder avec le dépôt cloné crée directement les tâches de la mission, chaque chemin vérifié contre le clone. |
Research mission (sys-research-mission) | Investigation en lecture seule : recherche en parallèle, puis une boucle de révision bornée jusqu'à l'approbation du critique (max 3 passes). |
Task dispatch (sys-task-dispatch) | La chaîne de décision par tâche : résoudre les dépendances, vérifier les frontières, router vers le meilleur agent, dispatcher le coder. |
Onboarding (4)
| Template | Ce qu'il fait |
|---|---|
First-run onboarding wizard (sys-first-run-onboarding) | Le bootstrap du tenant en cinq actes : providers, workspace, intention, une première mission et une vérification de politique. |
Project onboarding (sys-project-onboarding) | Amorce la charte d'un projet avec ses 12 Matters, puis relit l'avancement de la charte. |
Aspect onboarding (sys-aspect-onboarding) | Lance en éventail une mission par aspect de la charte, dans l'ordre de la charte, chacune portant le contexte de l'aspect précédent. |
Intelligence scaffolding (sys-intelligence-scaffolding) | Génère un plan de scaffolding du projet, puis un gate de décision : approuver l'exécute, rejeter le met de côté. |
Ops (3)
| Template | Ce qu'il fait |
|---|---|
Batch processing (sys-batch-processing) | Crée un batch, lance en éventail un traitement par tronçon, attend l'événement de complétion, agrège les résultats. |
Canary (sys-canary) | Lance en éventail un run par cas de test, analyse le verdict agrégé et conditionne la promotion en production. |
Run acceptance (physical) (sys-run-acceptance) | Pilote physiquement la cible construite du run pour chaque cas de validation — fail-closed — et conditionne le merge au verdict. |
Compliance (2)
| Template | Ce qu'il fait |
|---|---|
Compliance assessment (sys-compliance-assess) | Lance en éventail une sonde d'infrastructure par contrôle de framework, puis calcule les scores — piloté par sondes, sans LLM. |
Incident pipeline (sys-incident-pipeline) | Enregistre un incident, le classifie via des formulaires de gate typés, suit le calendrier réglementaire et clôt sur la cause racine. |
Review (2)
| Template | Ce qu'il fait |
|---|---|
Review engine sweep (sys-review-engine) | Découvre les cibles de revue, lance en éventail une revue par cible, soumet un rapport consolidé. |
UX review (sys-ux-review) | Découvre les pages, lance en éventail une revue d'utilisabilité par page, soumet un rapport consolidé. |
Validation (2)
| Template | Ce qu'il fait |
|---|---|
LLM preset validation (sys-llm-preset-validation) | Résout la grille preset × site, lance en éventail un run par cellule, évalue le verdict agrégé. |
Validation runs (sys-validation-runs) | Exécute les combinaisons prompt × modèle en parallèle par groupe de modèles, puis finalise les compteurs agrégés. |
Evaluation (1)
| Template | Ce qu'il fait |
|---|---|
Satisfaction scoring (sys-satisfaction-scoring) | Calcule et persiste un score de qualité pour une mission terminée. |
Improvement (1)
| Template | Ce qu'il fait |
|---|---|
Improvement cycle (sys-improvement-cycle) | Enregistre une amélioration, la valide, puis soit implémente le correctif via un coder, soit la rejette tôt. |
Support (1)
| Template | Ce qu'il fait |
|---|---|
Support-case triage (sys-support-case-triage) | Investigue et classifie un cas signalé, puis branche sur le verdict : gate puis correctif pour un bug, résolution anticipée pour le reste. |
Cloner un template
- Ouvrez la galerie de templates depuis la liste des workflows.
- Choisissez un template et cliquez sur Clone. Vous obtenez un
Draftqui vous appartient — le template, lui, reste intact. - Rename (« Renommer ») le draft pour qu'il se lise comme le vôtre, pas comme un flux système.
- Ouvrez-le dans l'éditeur visuel et appropriez-vous-le : remplacez des nodes, changez les instructions des gates, recâblez les arms.
- Validate (« Valider »), puis Publish (« Publier »). La publication gèle le graphe exactement comme pour un workflow construit de zéro — voir le cycle de vie d'un workflow.
Un clone est une copie, pas un abonnement : si le template de la galerie change dans une version ultérieure, votre clone ne bouge pas. Vous pouvez aussi cloner dans l'autre sens — depuis une mission qui a déjà tourné — ce que couvre Cycle de vie d'un workflow.
Les briques sys-
Les 19 workflows sys- semés sont publiés et versionnés comme n'importe quel workflow à vous ; ils apparaissent comme des tuiles prêtes à l'emploi que vous déposez dans un draft. En embarquer une signifie que votre workflow l'appelle comme sous-workflow : elle apporte ses étapes à votre run, et sa sortie atterrit via votre acceptation, comme tout le reste du graphe.
Deux briques que vous utiliserez probablement :
sys-research-codebase— une investigation de codebase en lecture seule ; une bonne étape d'ancrage avant tout ce qui est génératif.sys-decompose-propose— la proposition agentique de plan de tâches ; embarquez-la quand votre workflow doit proposer un plan de tâches ordonné comme le fait la plateforme.
La plupart des 19 existent pour servir les flux semés de la plateforme elle-même. Libre à vous d'en embarquer n'importe laquelle, mais vous n'en avez jamais besoin — un workflow construit uniquement avec les nodes de la palette est tout aussi légitime.
Cycle de vie d'un workflow
Un workflow est un objet versionné : une identité stable qui possède une série de versions numérotées, chacune traversant les trois mêmes états. Une version publiée ne change jamais — évoluer, c'est toujours publier une nouvelle version. Tout le reste de cette page découle de cette règle.
Trois états, deux transitions
| État | Sens |
|---|---|
Draft | La copie de travail. Le seul état qui accepte des modifications — changez le graphe aussi souvent que nécessaire. |
Published | Figée et exécutable. Ne peut plus jamais être modifiée ; son seul mouvement restant est vers Archived. |
Archived | Retirée. Plus exécutable, conservée pour la provenance. |
Les deux seules transitions légales sont Draft → Published et Published → Archived. Il n'y a pas de retour en arrière : vous ne pouvez ni dé-publier, ni désarchiver.
Delete (« Supprimer ») n'existe que pour les drafts, et c'est définitif. Une version publiée ne peut jamais être supprimée — si vous voulez l'écarter, vous l'archivez.
Les versions
Les numéros de version montent — 1, 2, 3 — et ne sont jamais réutilisés ni remis en arrière. Pour faire évoluer un workflow publié, vous ouvrez un nouveau draft ; sa publication crée la version suivante.
Plusieurs versions publiées du même workflow peuvent coexister, et chacune reste exécutable. En exécuter une est toujours un choix de version explicite : rien ne substitue silencieusement « la dernière » à la version que vous avez demandée. (Les triggers sont le seul endroit où une politique « dernière version » existe, et là encore c'est un choix que vous déclarez explicitement — voir plus bas.)
La validation se joue à la publication
Il n'y a pas d'étape Valider séparée dans l'éditeur : cliquer sur Publish (« Publier ») exécute les contrôles, et si quelque chose ne va pas, la publication refuse et signale tout d'un coup — erreurs de câblage, pins requis manquants, écritures sans gate en amont — dans une seule liste, pour corriger en une passe au lieu de resoumettre et découvrir le problème suivant. La liste est exhaustive : une fois vide, la publication passe. La liste de problèmes vit dans l'éditeur. Les agents peuvent exécuter les mêmes contrôles en véritable essai à blanc — sans tenter de publication, sans rien figer — via l'outil workflow_validate_draft.
La publication fige le graphe
Publish (« Publier ») valide une dernière fois, puis fige le draft. À partir de là, le graphe est immuable et scellé par un checksum ; chaque run enregistre exactement quel graphe figé il a exécuté — ce que vous avez relu est prouvablement ce qui a tourné.
Une seule chose vit hors du gel : le nom d'affichage. Renommer avec Rename (« Renommer ») touche toutes les versions du workflow et ne modifie jamais un graphe — un renommage est toujours sans risque, même sur des versions publiées.
Pour la mécanique complète du gel, voir le chapitre d'architecture sur les workflows.
Comment un workflow démarre
Un workflow n'exécute rien par lui-même ; chaque démarrage devient une mission. Trois portes :
- Attacher à la création de la mission. Vous créez une mission et choisissez un workflow comme plan. Les runs se déroulent ensuite sur cette mission — voir Runs, acceptation et changements.
- Invoke (« Invoquer »). Vous exécutez le workflow directement avec Invoke ; ARDS crée une nouvelle mission pour lui. Même boucle ensuite.
- Les triggers. Un planning, un webhook ou un événement de la plateforme démarre le workflow automatiquement. Vous les configurez depuis la liste des workflows : Manage triggers (« Gérer les déclencheurs ») ouvre le dialogue où vous choisissez Schedule (« Planification »), Webhook ou Event (« Événement ») et nommez le fournisseur et le modèle, obligatoires. Chaque trigger se lie soit à une version épinglée, soit à la dernière version publiée — vous le déclarez à la création du trigger — et nomme son modèle et son provider d'avance (il n'y a pas de repli silencieux). Un trigger ne contourne jamais un gate : un démarrage automatique s'arrête à chaque approbation où un démarrage manuel se serait arrêté.
Cloner
Cloner produit toujours un nouveau draft qui vous appartient — jamais une version publiée.
- Depuis un template. Les templates système se clonent en un draft éditable ; modifiez-le et publiez-le comme n'importe quel autre.
- Depuis une mission. « Sauvegarder ce run comme workflow. » Si la mission est elle-même née d'un workflow, le graphe source est re-drafté à l'identique. Si c'était une mission organique, décomposée par le planificateur, ARDS reconstruit un graphe à partir de ce qui a réellement tourné — et joint une liste de notes recensant chaque réparation faite en chemin, pour que vous puissiez juger la reconstruction avant de lui faire confiance.
Changer une référence de sous-workflow
Un workflow peut en embarquer un autre par référence (voir Anatomie d'un workflow). Vous pouvez re-lier cette référence — la pointer vers un autre workflow, ou une autre version — mais re-lier invalide toute ratification de gate donnée sur l'ancienne cible. Rien ne se reporte silencieusement : le draft re-lié repasse par votre approbation avant de pouvoir être publié.
Archiver
Archive (« Archiver ») retire une version publiée pour de bon. Elle cesse d'être exécutable, mais elle est conservée pour toujours : les runs passés pointent encore vers elle, et la provenance ne s'évapore jamais.
Un garde-fou : vous ne pouvez pas archiver une version tant qu'un workflow parent publié la référence encore comme sous-workflow. Re-liez ou archivez d'abord le parent. Et comme l'archivage est terminal, le « retour » passe toujours par l'avant — publiez une nouvelle version.
Runs, acceptation et changements
Un workflow ne fait jamais rien atterrir tout seul. Le travail se fait dans un run, et un run ne produit jamais qu'une proposition. Un run propose ; rien n'atterrit sans votre acceptation.
La boucle en un coup d'œil
Vous attachez un workflow à une mission — ou vous en invoquez un, ce qui crée sa mission pour vous. Vous démarrez un run ; le run exécute le graphe sur sa propre branche, à l'écart du travail déjà accumulé par la mission. Quand il termine, il reste en Proposed, ses changements prêts pour vous. Vous inspectez le résultat et décidez : Accept run (« accepter le run » — les libellés du tableau s'affichent en anglais dans l'interface) fait atterrir le travail sur la mission sous forme d'un changement ; une proposition que vous n'acceptez pas ne fait rien atterrir, et la mission reste exactement comme elle était (décliner n'est pas un bouton).
Démarrer un run
Les runs se démarrent depuis la page mission. Le tableau Runs & acceptance liste tous les runs de cette mission, passés et présents — l'étiquette live de son en-tête signifie qu'il se rafraîchit au rythme de la mission — et chaque nouveau run part de l'état courant de la mission.
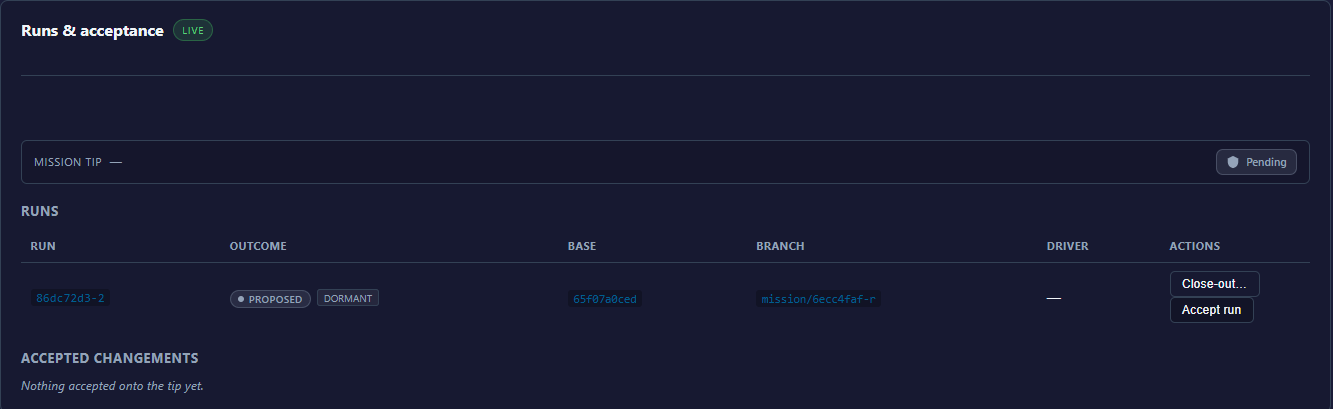
Chaque ligne de run montre son issue et, quand ils s'appliquent, deux petits badges : dormant — le run n'a pas encore de cible provisionnée, rien n'a tourné contre lui — et stale — la base du run est derrière la pointe de la mission, donc une acceptation refuserait tant qu'un run frais n'est pas démarré.
Un run peut refuser de démarrer. Les raisons que vous rencontrerez vraiment :
- Un run est déjà ouvert. Un run à la fois par mission — attendez-le, ou acceptez-le / écartez-le d'abord.
- La mission n'est pas encore planifiée. Son plan n'est pas en place ; laissez-la y arriver d'abord.
- La mission est terminée. Une mission terminée ou annulée ne prend plus de nouveaux runs.
Tout ce qui est plus exotique relève des refus côté agent ; la liste complète vit sur les pages agent.
Pendant le run
Pendant qu'un run s'exécute, ses gates se mettent en pause dans votre file de Decisions : le run attend au gate jusqu'à votre réponse (ou, si le gate a été conçu avec un timeout, jusqu'à son expiration), puis reprend. Tout le reste d'un run en cours — la vue graphe, le statut par node, le panneau de session coder — se trouve dans la visionneuse de run ; voir Suivre un run.
Un run propose des changements
Un run naît Proposed et y reste jusqu'à ce que vous décidiez.
| Issue | Sens |
|---|---|
Proposed | Les changements du run existent sur sa propre branche et attendent votre décision. |
Accepted | Vous avez accepté ; les changements ont atterri sur la mission sous forme d'un changement. |
Rejected | Le run a été décliné — écarté par le verbe agent, ou un frère concurrent a été accepté à sa place. Rien n'a atterri, et la branche du run disparaît. |
Superseded | Le run a été remplacé par un autre run et n'est plus en jeu. |
La cheatsheet complète est sous issues d'un run.
Accepter
Accept run fait trois choses, dans l'ordre — et refuse plutôt que d'en faire une à moitié :
- Contrôle de fraîcheur. Le run est parti d'un état précis de la mission. Si la mission a bougé depuis, l'acceptation refuse.
- Validation physique. Le résultat fusionné doit être vérifié mécaniquement avant d'atterrir. C'est fail-closed : si le système ne peut pas vérifier mécaniquement la fusion, il refuse — il ne fait jamais atterrir du travail sur parole, pas même la sienne.
- Fusion. Les changements atterrissent sur la branche de la mission, et un changement est créé pour les consigner comme une unité réversible.
Sur le tableau, un run proposé porte deux boutons : Accept run — il affiche Accepting… pendant qu'il travaille — et Close-out…, qui ouvre la checklist de clôture du run. Tout ce que le run a laissé ouvert — une tâche restante, un gate ouvert, un node en échec — doit y recevoir une note de disposition datée avant que l'acceptation ne se déverrouille ; un run propre répond « No leftovers — every node landed terminal and clean. » (« aucun reste — chaque node a terminé proprement », affiché en anglais).
Pourquoi une acceptation peut refuser :
- Le sol a bougé. La mission a avancé depuis le départ du run. Démarrez un run frais.
- Conflit de fusion. Les changements du run ne s'appliquent plus proprement. Démarrez un run frais depuis l'état courant.
- Un autre run a déjà gagné. Si des runs étaient en compétition (ci-dessous), un seul est accepté.
Une acceptation refusée ne fait rien atterrir et ne casse rien — la mission reste intacte.
Décliner une proposition
Il n'y a pas de bouton d'écart sur le tableau des runs : un run proposé est soit accepté, soit laissé tel quel. Le laisser est sans danger — rien n'est arrivé à la mission, il n'y a donc rien à défaire — mais la mission ne prend pas de nouveau run tant qu'une proposition reste ouverte.
Une proposition non voulue se règle de deux façons. Accepter une proposition rejette automatiquement les autres runs proposés de son groupe concurrent, et leurs branches sont supprimées — c'est la réponse à « que deviennent les autres ? » pour les runs concurrents. Et les agents peuvent écarter un run explicitement avec le verbe MCP mission_run_discard (référence agent) : le run est marqué rejeté et sa branche supprimée. Dans les deux cas, c'est la façon peu coûteuse de dire « pas celui-ci » — rien n'a jamais atterri.
La pile de changements
Sur le tableau, c'est la pile Accepted changements (« changements acceptés ») — vide, elle affiche « Nothing accepted onto the tip yet. » (« rien d'accepté sur la pointe pour l'instant », en anglais dans l'interface). Chaque run accepté devient exactement un changement, et les changements s'empilent dans l'ordre sur la branche de la mission. La merge request de la mission est cette pile composée — pas un tas de commits bruts, mais une séquence de deltas acceptés et validés. Comme chaque acceptation est validée avant de fusionner, la pointe de la mission est toujours un état qui a passé la validation.
Le revert
N'importe quel changement peut être annulé par un revert — son bouton Revert… montre un aperçu avant que quoi que ce soit ne soit défait. L'aperçu montre la cascade : les changements ultérieurs qui touchent les mêmes fichiers dépendent de celui que vous annulez, et ils sont annulés avec lui, en ordre inverse. Si un revert entraînait un conflit, ARDS refuse plutôt que de deviner une résolution. Et rien ne s'évapore : le changement annulé et le revert lui-même restent dans l'historique de la mission, datés et attribués.
Runs concurrents
Avancé, mais bon à savoir : vous pouvez démarrer plusieurs runs depuis le même point de départ — workflows différents, paramètres différents, instructions différentes — en un groupe concurrent. Inspectez-les côte à côte et acceptez celui que vous préférez ; les perdants sont rejetés et leurs branches supprimées. C'est de l'A/B testing où le juge, c'est vous, sur des résultats réels et validés.
Gouvernance : presets, instructions et plancher de publication
Les workflows décrivent le travail ; la gouvernance décide qui le valide, quel modèle l'exécute, et ce qu'un graphe doit contenir avant de pouvoir être publié. Cette page couvre les quatre leviers que vous toucherez vraiment : les gates comme décisions, les presets, les instructions de node et le plancher de publication.
Rien ne s'approuve tout seul : aucune gate ne s'auto-résout sans un opt-in explicite pour cette gate précise — et le plancher de séparation des devoirs ne le peut jamais.
Les gates sont des décisions
Chaque gate qu'un workflow en cours atteint devient une carte dans votre file Decisions (« Décisions »). Le run se met en pause ; la carte porte le libellé de la gate, ses instructions et les champs typés que l'auteur vous demande de remplir. Vous la résolvez avec l'un des trois verbes :
- Approve (« approuver ») — l'étape gardée reprend une fois que toutes les étapes précédentes sont terminées.
- Skip (« passer ») — annule l'étape gardée ; le run continue sans elle.
- Fail (« mettre en échec ») — fait échouer l'étape, et le routage d'échec du workflow prend le relais.
Ou vous ne faites rien : une gate non résolue attend, tout simplement. Rien ne bouge tant que personne ne décide.
Une règle domine les trois : vous n'approuvez jamais votre propre proposition. L'identité qui résout une gate doit être différente de celle qui a proposé le travail, et une gate levée par un agent exige toujours un humain. Si ARDS ne peut pas attribuer le résolveur, il refuse la résolution plutôt que de deviner.
Jamais automatique par défaut
Aucune gate ne s'auto-approuve d'origine. L'auto-résolution est un opt-in par gate : vous l'accordez explicitement, pour cette gate-là, et chaque résolution automatique est journalisée. L'accord est aussi lié au contenu exact pour lequel il a été donné — si ce que la gate garde change, la gate revient et redemande à un humain.
Même avec des opt-ins, un plancher ne bouge jamais : la gate de séparation des devoirs qui se dresse entre le travail accepté d'une mission et votre projet ne peut jamais être rendue automatique — ni par configuration, ni par waiver. Les runs sont acceptés par vous ; la promotion au-delà de ce point se décide par vous aussi.
Les presets
Un preset est un ensemble nommé de choix de modèle et de fournisseur (plus le transport d'outils qui va avec) utilisé par les nodes génératifs d'un workflow. Plutôt que de figer un modèle sur chaque node, vous liez un preset et gérez le choix à un seul endroit.
Les presets portent une portée — global, project ou customer — et la plus spécifique gagne : une liaison au niveau projet bat une liaison à l'échelle du client, qui bat une liaison globale.
Deux faits comptent en pratique :
- Les presets se résolvent au dispatch, pas à la publication — quand un run démarre, le preset lié à ce moment-là gagne, même sur ce qui a été écrit sur le canvas. La publication a gelé le graphe, pas le choix de modèle.
- La résolution suit une chaîne — un preset lié au dispatch gagne ; sinon le preset écrit (épinglé) sur le node s'applique ; sinon le preset par défaut du site prend le relais. Si rien ne nomme un modèle nulle part, le run refuse de démarrer plutôt que de deviner.
Vous liez un preset sur un draft avec le sélecteur de l'éditeur. Les profils de flotte sont un tout autre levier — dimensionnement des conteneurs et concurrence, pas choix de modèle ; voir le réglage de la flotte.
Instructions de node
Les nodes coder et agent d'un workflow peuvent porter des node instructions — une liaison d'instructions qui remplace les instructions rédigées du node au prochain dispatch (pour un coder, les inputs et le contrat de sortie sont recomposés à l'identique ; pour un agent, la liaison remplace son texte de tâche), sans toucher au graphe publié ni à son checksum. Une seule liaison s'applique — la plus spécifique : run bat project, qui bat tenant, qui bat global.
Aujourd'hui, vous définissez les instructions de node à la main, depuis l'éditeur ou par run au moment d'en démarrer un. Qu'ARDS propose lui-même un meilleur prompt n'est pas dans la v1 ; si cela arrive un jour, la proposition se présentera comme une décision que vous approuvez ou rejetez — rien ne s'appliquera jamais tout seul.
Le plancher de publication
Un workflow compte comme gouverné quand le catalogue de contrôles de votre organisation s'y applique — en pratique, dès que son graphe écrit quelque part qui compte. Pour un graphe gouverné, deux choses se produisent avant la publication :
- Chaque écriture exige un stage (« étape de développement ») — l'un de
Design,Implementation,Integration,Verification,PreDeployment. Le stage dit au plancher quels contrôles cette écriture requiert. - Les contrôles requis sont injectés au sein même de la publication — les gates et revues que le catalogue exige atterrissent dans le graphe publié comme de vrais nodes, marqués visuellement comme injectés. Publier depuis l'éditeur les injecte pendant la publication elle-même ; pour les relire sur le draft avant de publier, les agents lancent l'outil
workflow_materialize, qui les écrit dans le draft exactement comme des nodes que vous auriez placés vous-même. La publication est refusée tant que le graphe n'est pas complet.
La vérification est déterministe : le même graphe plus le même catalogue de contrôles produit toujours les mêmes contrôles — le LLM ne synthétise jamais la conformité. Et le plancher ne fait qu'ajouter : la gouvernance peut relever la barre au-dessus de ce que vous avez écrit, jamais l'abaisser en silence. La publication elle-même est couverte dans le cycle de vie d'un workflow.
Les waivers
Quand un contrôle requis ne s'applique vraiment pas, vous ne le supprimez pas — les contrôles injectés ne sont pas négociables sur le canvas. La soupape, c'est le waiver (une dérogation) : explicite, lié à un seul contrôle, porteur d'une raison écrite, et journalisé de façon permanente. Un contrôle sous waiver reste visible comme tel — pas absent.
Certains contrôles ne peuvent pas être levés du tout. La règle de rétention de 25 ans en est un : aucune raison, si bonne soit-elle, ne la retire.
Suivre un run
Un run est une proposition, et vous ne devriez jamais avoir à accepter une proposition que vous ne pouvez pas inspecter. Le run viewer vous montre ce qu'un run a réellement fait — chaque node, chaque prompt, chaque fichier touché — pendant qu'il s'exécute et après qu'il a terminé. Quand le run viewer ne connaît pas une valeur, il n'affiche rien plutôt que de deviner. Un champ vide signifie « non enregistré », jamais « inventé ».
Le run viewer
Chaque run appartient à une mission. Ouvrez la mission, trouvez le run sur son tableau des runs, puis cliquez dessus — le run viewer s'ouvre sur le graphe même que vous avez publié, désormais peint avec l'état d'exécution. D'un coup d'œil, vous voyez quels nodes ont terminé, lesquels ont échoué, et lequel retient le run à une gate.
L'URL du run se partage : la personne qui la reçoit arrive sur le même run. Et partout où un node est référencé ailleurs dans l'interface, cette référence ouvre directement le viewer avec la fiche du node déjà ouverte. Ce lien profond est le moyen le plus rapide de dire « regarde cette étape » dans un rapport de bug.
Le viewer couvre un run dans tous ses états — encore en cours, en pause à une gate, ou terminé et en attente en Proposed. La suite — accepter la proposition, ou la laisser — est couverte dans Runs, acceptation et changements.
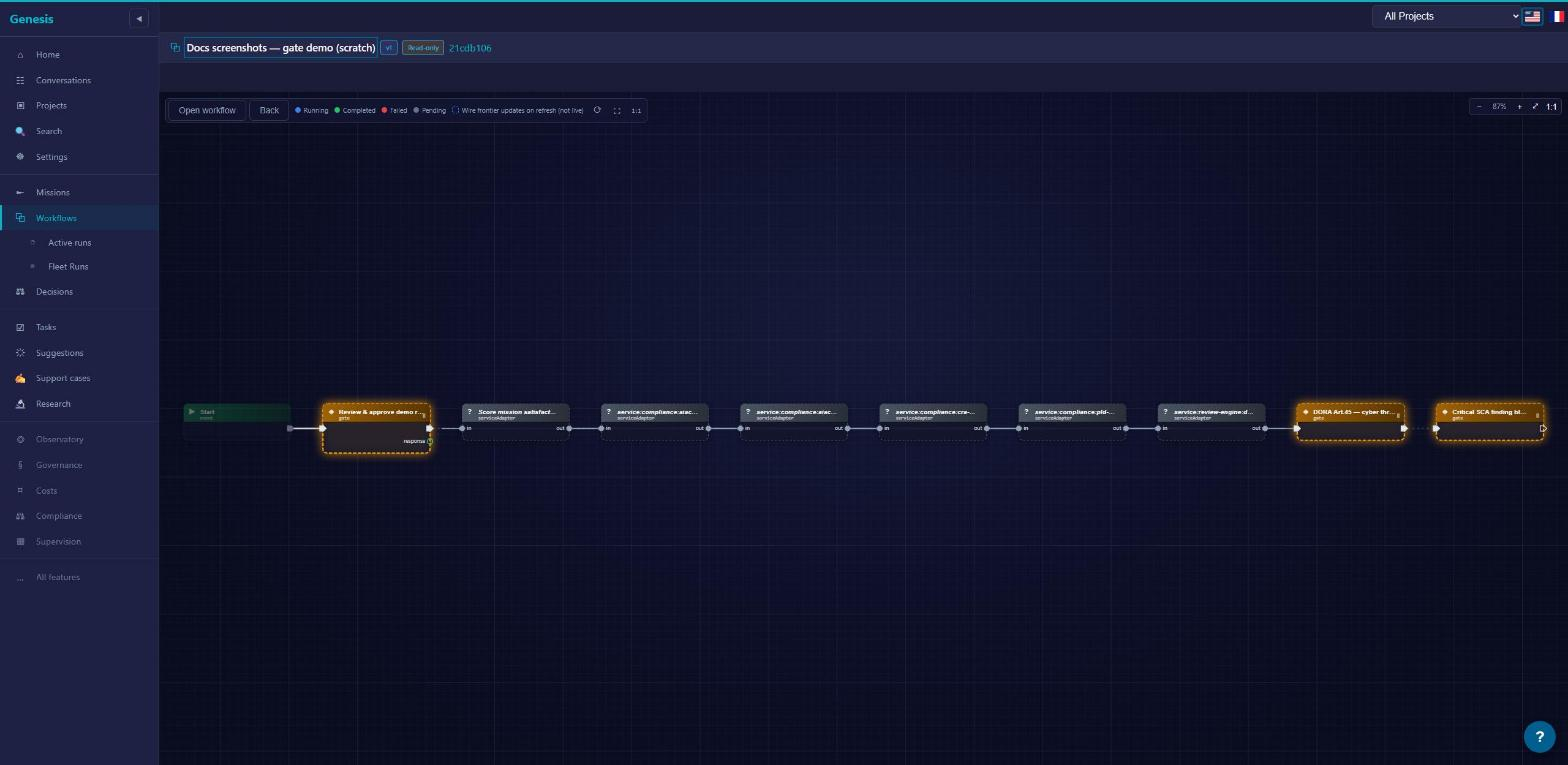
La fiche de node
Cliquez sur un node : sa fiche s'ouvre — statut, raison d'échec s'il a échoué, heure de départ et durée, nombre de tentatives, tokens consommés. Si l'une de ces valeurs n'a pas été enregistrée, la ligne est simplement absente — la fiche ne comble jamais un trou avec un chiffre plausible.
La fiche pointe aussi vers l'extérieur. Un node qui a dispatché un coder pointe vers la tâche du coder. Un node qui a levé une gate pointe vers cette décision. Un node multi-bras — le coder asynchrone ou service:mission:integrate — montre quel bras le run a réellement pris (les bras d'issue).
Enfin, la fiche signale les nodes qui ne viennent pas de la main de l'auteur — generated, injected ou amended ; un node que vous avez écrit vous-même ne porte aucun badge d'origine. La provenance compte quand vous décidez du crédit à accorder à une étape — un contrôle que vous avez placé vous-même ne se lit pas comme un contrôle ajouté par la gouvernance.
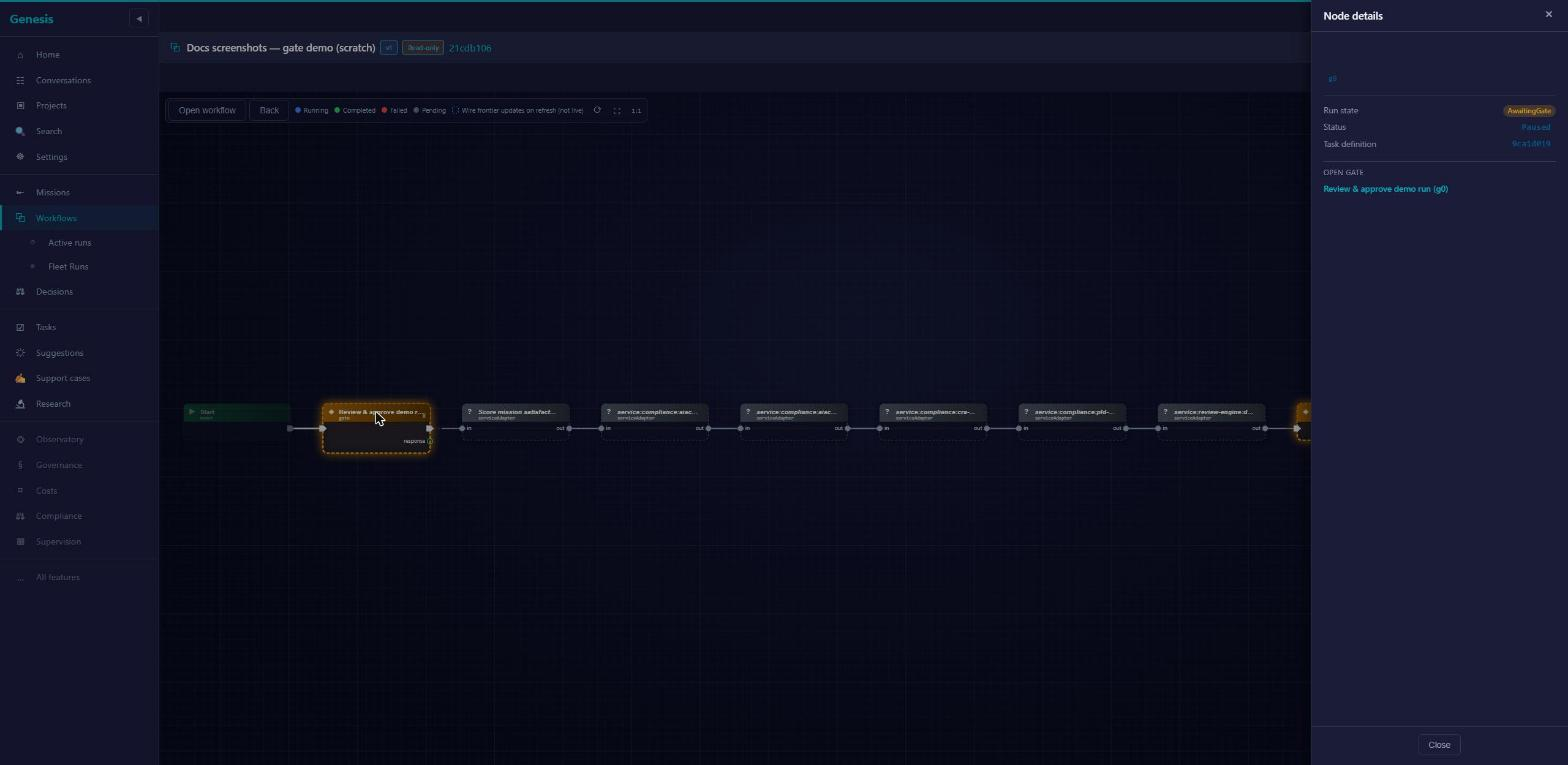
Les fiches de gate
Quand un run se met en pause à une gate, la gate arrive dans votre file de Decisions, et sa fiche montre l'instantané exact des variables que le run portait au moment de lever la gate. Cet instantané est figé : ce que vous approuvez est ce que vous avez vu, pas ce que les valeurs deviendront plus tard.
Une gate peut porter des champs de saisie typés (String, Number, Bool, Json, Enum) et des décisions nommées — les mêmes formes que décrit Gates. Remplissez-les sur la fiche ; vos réponses repartent dans le run.
Les contrôles injectés se distinguent visuellement des gates écrites par l'auteur. Si la pause que vous regardez a été exigée par le plancher de publication plutôt que placée par l'auteur du workflow, la fiche le dit — voir Gouvernance pour comprendre pourquoi ces contrôles existent et pourquoi ils ne se négocient pas à l'exécution.
Le panneau Coder Session
Quand un node a dispatché un coder, sa fiche inclut un panneau Coder Session (« session du coder ») — l'enregistrement complet de ce qui a été dit à ce coder et de ce qu'il a fait :
- Le prompt effectif, exactement tel que dispatché. Dépliable jusqu'au texte intégral. C'est ce que le coder a réellement reçu — pas un résumé, pas une reconstruction.
- Les fichiers touchés. Chaque fichier modifié par la session, listé.
- Le diff à la demande. Cliquez sur Load changes (« Charger les modifications ») pour afficher le diff complet — nombre de fichiers, ajouts et suppressions, vrais hunks.
- Les téléchargements. Chaque fichier individuellement, ou tout en un seul zip.
Ce panneau est votre moyen d'auditer un coder sans quitter le run. Pour ce que sont les coders et comment ils travaillent, voir Coders.
Du run à la mission, et retour
Le run viewer est à un saut de tout ce qu'il touche. Le fil d'Ariane vous ramène à la mission, où le tableau des runs montre ce run à côté de ses voisins. La fiche de node vous emmène à la tâche du coder ou à la décision levée. Et les références au run ailleurs dans l'interface — sur une carte de décision, sur la page mission — ramènent directement ici.
Quand vous en avez vu assez, la décision se prend sur la page mission, pas dans le viewer : Accept le run — ou déclinez-le. Le travail du viewer s'arrête là où le vôtre commence — il montre ; vous décidez.
Référence agent : outils workflow & run
Cette page est la surface de référence des 33 outils MCP qui créent, exécutent et acceptent les workflows : 23 outils workflow_*, 3 outils workflow_node_instructions_* et 7 outils mission-run/changement, en huit groupes. Pour les procédures pas à pas, utilisez les recettes ; quand un appel refuse, la page des refus associe chaque token à sa récupération.
À qui s'adresse cette page
Vous êtes un agent connecté en MCP — ou l'opérateur qui le pilote. Chaque outil de cette page renvoie la même enveloppe : { success, data } en cas de succès, { success: false, error, code } en cas de refus. Tous ces outils exigent des droits tenant-admin ; si un appel échoue à l'autorisation, c'est un problème de permissions, pas un problème de workflow.
Cette page dit ce que fait chaque outil et ce qu'il renvoie. Pour la mécanique sous-jacente — compilation, branches, seals — lisez le chapitre d'architecture des workflows.
Les deux surfaces d'entrée légales
Un workflow publié ne s'exécute que par deux surfaces : workflow_invoke et mission_run_start — tout le reste de cette page crée, inspecte ou accepte.
workflow_invoke— workflow d'abord. Compile une version publiée en une mission neuve qu'il crée pour vous. À utiliser quand le travail n'a pas encore de mission.mission_run_start— un run sur une mission existante. Le run reçoit sa propre branche à partir du tip de la mission et entre dans la boucle d'acceptation : néProposed, puis vous l'acceptez ou l'écartez. À utiliser quand le travail appartient à une mission que vous avez déjà.
Le parcours côté humain de cette boucle est Runs, acceptation et changements.
Création et cycle de vie (9 outils)
Ces outils mènent un graphe du draft vide à la version publiée gelée. Les drafts sont le seul état éditable ; publier gèle le graphe — voir Cycle de vie d'un workflow.
| Outil | Rôle | Entrées clés | Retour | Codes de refus |
|---|---|---|---|---|
workflow_create_draft | Créer une nouvelle version draft à partir d'un payload de graphe. Omettez workflowId pour une identité neuve en version 1 ; fournissez-le pour ouvrir la version suivante. | graphJson ; optionnels workflowId, tunnelsJson | { id, workflowId, version, status } | — |
workflow_update_draft | Remplacer le graphe et les tunnels d'un draft. Drafts uniquement. | id, graphJson ; optionnel tunnelsJson | { id, workflowId, version, status } | NOT_FOUND · CONFLICT (pas un draft) |
workflow_materialize | Injecter dans un draft les contrôles de gouvernance requis, de façon déterministe, depuis le catalogue de contrôles actif. À lancer avant publish sur les graphes gouvernés ; idempotent. | id | { id, workflowId, version, status } | NOT_FOUND |
workflow_waive_control | Enregistrer une dérogation explicite, motivée et auditée pour un contrôle requis manquant. Certains contrôles ne sont pas dérogeables et refusent. | id, controlId, reason | { id, workflowId, version, status } | NOT_FOUND ; contrôle non dérogeable |
workflow_validate_draft | Validation à blanc — le même validateur que publish, qui agrège tous les problèmes en une seule passe. Ne change rien. | id | la liste complète des problèmes | — (les problèmes sont renvoyés, pas levés) |
workflow_publish | Valider, puis geler le draft en une version publiée immuable et sommée. | id | { id, workflowId, version, status, checksum, publishedAt } | VALIDATION_ERROR (tous les problèmes listés d'un coup) |
workflow_rename | Définir le nom d'affichage, partagé par toutes les versions. Le nom vit hors du checksum : renommer un workflow publié est donc permis. | workflowId, name | { workflowId, name, updatedVersions } | NOT_FOUND |
workflow_archive | Archiver une version publiée — terminal, conservé pour la provenance. | id | { id, workflowId, version, status } | CONFLICT (pas Published, ou un workflow publié la référence encore — vérifiez d'abord workflow_referenced_by) |
workflow_delete_draft | Supprimer définitivement une version draft. Destructif. | id | { id } | CONFLICT (pas Draft) |
Composition (3 outils)
Les workflows se composent par référence : un node FlowRef intègre un autre workflow publié comme sous-workflow.
| Outil | Rôle | Entrées clés | Retour | Codes de refus |
|---|---|---|---|---|
workflow_tile_catalog | Lister les tiles publiés que vous pouvez intégrer comme sous-workflows — y compris les briques sys- — chacun avec la surface de pins qu'il projette. | — | la liste des tiles | — |
workflow_rebind_flowref | Repointer un FlowRef d'un draft vers un autre workflow ou une autre version cible. Repointer invalide la ratification des gates : les approbations données sur l'ancien lien doivent être redonnées. | id du draft, le node FlowRef, la nouvelle cible | le draft mis à jour | NOT_FOUND · CONFLICT (pas un draft) |
workflow_referenced_by | Lister les workflows publiés qui référencent celui-ci. À appeler avant d'archiver : l'archivage refuse tant que cette liste n'est pas vide. | workflowId | la liste des consommateurs | — |
Découverte et observation (6 outils)
| Outil | Rôle | Entrées clés | Retour |
|---|---|---|---|
workflow_catalog | La palette des types de nodes : les 138 types répartis en 17 catégories, chacun avec ses pins d'entrée/sortie typés. lifecycle vaut Standard ou Legacy ; placer un node Legacy dans un nouveau draft bloque le publish. À lire avant de créer, pour câbler des pins compatibles. | — | le catalogue avec les pins par type |
workflow_list | Toutes les versions d'un workflow, de la plus récente à la plus ancienne. | workflowId | les versions avec status, checksum, dates |
workflow_list_all | La dernière version de chaque workflow du tenant. | — | une ligne par workflow |
workflow_get | Une version avec son payload de graphe complet. version=0 (ou omis) signifie la dernière version publiée. | workflowId ; optionnel version | la version complète, y compris graphJson |
workflow_runs | Les runs lancés depuis un workflow, du plus récent au plus ancien. | workflowId ; filtre de version optionnel | la liste des runs |
workflow_run_nodes | Le statut par node d'un run — fait correspondre les tâches du run aux ids de nodes du graphe d'origine. | l'id de mission du run | les statuts par node (voir États des nodes d'un run) |
Exécution (1 outil)
workflow_invoke — exécuter une version publiée, workflow d'abord.
- Entrées :
workflowId,version(doit être ≥ 1 — exécuter « la dernière, quelle qu'elle soit » n'est jamais implicite), optionnelsobjective,model,provider,paramsJson,projectId,presetId(+forceOnAllCallSites),agentBudgetJson(+forceBudgetOnAllAgentSites). - Les paramètres se lient à la compilation. Les valeurs de
paramsJsonsont liées quand le graphe est compilé en plan de la nouvelle mission ; rien ne se relie en cours de run. - La résolution du modèle est explicite.
modeletprovidersont requis sauf si les défauts du tenant les résolvent — il n'y a pas de repli silencieux de modèle. - Les presets sont le levier à préférer.
presetIdexécute cette invocation avec un preset nommé plutôt qu'unmodelbrut ; un preset inconnu refuse avecNOT_FOUNDau lieu de se replier. Par défaut, il ne remplace que le preset par défaut du workflow — un step qui a épinglé son propre preset à l'édition le garde — sauf si vous passez aussiforceOnAllCallSites. - Budgets d'agent par run.
agentBudgetJsonajuste les budgets d'agent pour ce run uniquement, axe par axe. Par défaut, un axe indiqué ne se substitue qu'au défaut moteur — il ne comble que les axes que le budget rédigé par le step laisse non renseignés, et un step qui a rédigé cet axe garde sa propre valeur — sauf si vous passez aussiforceBudgetOnAllAgentSites, qui impose les axes indiqués à chaque site agent, au-dessus de ce que le step a rédigé. Une surcharge malformée refuse avecVALIDATION_ERRORavant toute création de mission. - Le ciblage de projet est explicite et échoue bruyamment.
projectId(id ou slug) dirige les écritures du run vers un projet : une cible inconnue refuse avecNOT_FOUNDet un projet non-Active avecCONFLICT, dans les deux cas avant toute création de mission. Omettez-le et le run atterrit dans le projet par défaut du tenant — enregistré comme tel dans la provenance de la mission. - Retour : le nouveau
missionIdavec les comptes de steps, de gates et de contrôles. Chaque gate naît en pause derrière une décision en attente. - Suites :
mission_getpour suivre la mission,decision_listpour trouver les gates en attente,workflow_run_nodespour le statut par node.
Clonage (2 outils)
| Outil | Rôle | Entrées clés | Retour |
|---|---|---|---|
workflow_clone_from_mission | « Sauvegarder ce run comme workflow. » Clone une mission en un nouveau draft — ne publie jamais. Une mission née d'un workflow est re-draftée à l'identique depuis sa source ; une mission organique est reconstruite depuis ses tâches, et notes liste chaque réparation faite en chemin. | l'id de la mission | { id, workflowId, version, status, source, notes } ; source = workflow-born | organic |
workflow_clone_from_system | Cloner un template système en un draft neuf que votre tenant possède. | la clé du template | { id, workflowId, version, status } |
Templates système (2 outils)
| Outil | Rôle | Entrées clés | Retour |
|---|---|---|---|
workflow_system_list | Lister les 22 templates de la galerie, en lecture seule. | — | les résumés des templates |
workflow_system_get | Un template avec son graphe complet, pour l'inspecter avant de le cloner. | workflowKey | le template, y compris graphJson |
Les templates sont représentatifs : le clonage vous donne un graphe à posséder et éditer, pas un branchement sur les flux internes de la plateforme. L'énumération complète des 22 se trouve sur Templates système.
Instructions de node (3 outils)
Les nodes coder et agent peuvent porter une liaison d'instructions — un texte de surcharge qui remplace les instructions rédigées du node au prochain dispatch, sans toucher au graphe publié ni à son checksum. Une seule liaison s'applique — la plus spécifique gagne : run > project > tenant > global.
| Outil | Rôle | Entrées clés | Retour |
|---|---|---|---|
workflow_node_instructions_get | Lire le texte rédigé d'un node, la liaison gagnante (s'il y en a une) et le texte effectif que le dispatch utiliserait. | la référence du node ; portée optionnelle | rédigé, liaison, effectif |
workflow_node_instructions_set | Définir le texte d'instruction manuel à une portée donnée. | la référence du node, la portée, le texte | le slot mis à jour |
workflow_node_instructions_clear | Retirer l'instruction manuelle à une portée donnée. | la référence du node, la portée | le slot vidé |
Seuls les slots définis manuellement sont modifiables par ces outils ; un slot détenu par la machinerie de prompt-engineering de la plateforme refuse avec CONFLICT. ARDS ne propose pas encore lui-même d'améliorations de prompts en v1 ; si cela arrive, les propositions arriveront comme des décisions que vous approuvez — rien ne s'appliquera jamais tout seul. Voir Gouvernance pour la vue côté humain.
Runs de mission et changements (7 outils)
La boucle d'acceptation sur une mission existante. Strict-séquentiel par défaut : un seul run non décidé à la fois, chaque run accepté atterrissant comme un changement sur la branche de la mission. Passez le même groupId à plusieurs démarrages pour ouvrir une compétition à la place — un gagnant, les autres rejetés.
| Outil | Rôle | Entrées clés | Retour | Statuts |
|---|---|---|---|---|
mission_run_start | Démarrer un run d'une version publiée sur une mission existante. Le run se branche depuis le tip de la mission et naît Proposed. | l'id de la mission, workflowId, version ; optionnel groupId | l'id du run + un token de statut | les 11 statuts de démarrage de run |
mission_run_get | Un run avec son récapitulatif par node, son changement une fois accepté, et ses ancres de seal. isAnchored n'est vrai qu'une fois le run accepté, son changement appliqué et son seal passé. | l'id du run | le détail du run | — |
mission_run_accept | L'unité d'acceptation : revérifie la base du run contre le tip de la mission, exécute le plancher de validation physique (fail-closed), fusionne et enregistre exactement un changement. | l'id du run | le changement en cas de succès | les 7 statuts d'acceptation de run |
mission_run_discard | Écarter un run non accepté : le marque Rejected et supprime sa branche. Rien n'a atterri, donc rien à défaire. | l'id du run | confirmation | — |
mission_changement_stack | Les changements de la mission en ordre ordinal, chacun avec ses fichiers touchés et les changements antérieurs dont il dépend. | l'id de la mission | la pile | — |
mission_revert_preview | Prévisualiser un revert : le changement plus la fermeture transitive de ses dépendants, dans l'ordre inverse où ils seraient annulés. Ne change rien. | l'id de la mission, le changement | la cascade | — |
mission_revert | Exécuter la cascade prévisualisée, du plus récent au plus ancien, fail-closed : un conflit interrompt proprement et nomme le membre fautif — rien de partiel n'atterrit. | l'id de la mission, le changement | la liste des annulés | — |
Le parcours côté humain — accepter, écarter, revert, compétition — est Runs, acceptation et changements.
Contexte mission
Quatre outils voisins que vous croiserez dans chaque session workflow ; la surface mission complète est documentée dans Missions & tasks.
mission_propose rédige une mission et la route vers approbation au lieu de la créer directement — la proposition arrive comme une décision qu'un humain accepte ou rejette. Vous n'approuvez jamais votre propre proposition.
mission_create crée une mission directement. Attachez un workflow à la création, ou démarrez des runs dessus plus tard avec mission_run_start.
mission_decompose demande au planificateur de découper en tâches une mission née d'une conversation. Les missions qui portent un workflow sautent cette étape : le graphe est déjà le plan.
decision_respond est l'unique verbe de résolution de gate. Ses résolutions s'appliquent à une gate en pause ainsi : approve libère la gate une fois les steps précédents terminés ; skip annule le step gardé ; fail le fait échouer. Laisser la décision sans réponse maintient le run en pause. Les gates en attente sont listées par decision_list et apparaissent dans la file Decisions (« Décisions »).
Vocabulaires de statuts
Tables de tokens normatives. Les tokens sont renvoyés tels quels ; comparez-les exactement. Le détail de récupération par token vit dans Refus et modes d'échec.
Statuts de démarrage de run
Renvoyés par mission_run_start. Un token de succès, dix refus.
| Token | Sens | Que faire |
|---|---|---|
Started | Le run a été créé sur sa propre branche depuis le tip de la mission, né Proposed. | Suivez-le avec mission_run_get ; résolvez les gates via decision_respond. |
FeatureDisabled | Workflows:MissionRuns:StartEnabled est désactivé dans cet environnement. | Demandez à votre opérateur de l'activer — voir Refus et modes d'échec. |
AgenticMissionUnsupported | Le type de cette mission ne peut pas héberger de runs de workflow. | Utilisez une mission standard, ou créez-en une avec workflow_invoke. |
MissionTerminal | La mission est déjà Completed, Failed ou Cancelled. | Démarrez le run sur une mission vivante, ou invoquez-en une neuve. |
MissionNotPlanned | La mission n'a pas encore atteint un état planifié. | Attendez la fin de la planification, puis réessayez. |
ChildSpawnerDisallowed | Le graphe contient un node qui engendre des missions filles — interdit dans un run de mission. | Exécutez ce workflow via workflow_invoke à la place. |
RunAlreadyOpen | Strict-séquentiel : un run non décidé est déjà ouvert sur cette mission. | Acceptez ou écartez d'abord le run ouvert — ou entrez en compétition avec le même groupId. |
TipUnavailable | Le tip de la mission n'a pas pu être résolu. | Réessayez ; si cela persiste, voir Refus et modes d'échec. |
WorkflowNotFound | Aucun workflow ne correspond à ce workflowId et cette version. | Vérifiez avec workflow_list. |
NotInvocable | Cette version n'est pas Published. | Publiez le draft, ou choisissez une version publiée. |
MaterializationFailed | La compilation du graphe en tâches du run a échoué. | Lisez l'erreur renvoyée ; les causes sont cataloguées dans Refus et modes d'échec. |
Statuts d'acceptation de run
Renvoyés par mission_run_accept. Un token de succès, six refus.
| Token | Sens | Que faire |
|---|---|---|
Accepted | Validé et fusionné ; exactement un changement enregistré ; le tip de la mission a avancé et reste vert. | Lisez la pile avec mission_changement_stack. |
StaleRefused | Le tip de la mission a bougé depuis que le run s'est branché. | Démarrez un run neuf depuis le nouveau tip — ne forcez jamais. |
MergeConflict | La branche du run ne fusionne plus proprement sur le tip. | Écartez-le et démarrez un run neuf depuis le tip courant. |
GroupAlreadyWon | Un autre run de ce groupe de compétition a déjà été accepté. | Rien — le groupe est décidé ; les branches perdantes sont supprimées. |
ValidationRefused | L'acceptation est physique, et le contrôle est fail-closed : si la validation ne passe pas — ou qu'aucun backend de validation n'est joignable dans votre environnement — l'accept est refusé plutôt que laissé passer. Le run reste Proposed ; rien ne fusionne. | Confirmez qu'un backend de validation est disponible (demandez à votre opérateur), puis réessayez — voir Refus et modes d'échec. |
NotProposed | Le run n'est pas en Proposed — il a déjà été accepté ou écarté. | Vérifiez avec mission_run_get. |
TipUnavailable | Le tip de la mission n'a pas pu être résolu. | Réessayez ; si cela persiste, voir Refus et modes d'échec. |
Issues d'un run
Le cycle de vie du run lui-même — les mêmes tokens que la cheatsheet des états.
| Token | Sens | Que faire |
|---|---|---|
Proposed | État de naissance : les changements du run existent sur sa branche et nulle part ailleurs. | Inspectez-le, puis acceptez ou écartez. |
Accepted | La fusion a passé la validation physique ; un changement a atterri. | — |
Rejected | Décliné — écarté via discard, ou rejeté automatiquement quand un frère concurrent a été accepté ; la branche est supprimée ; rien n'a atterri. | — |
Superseded | Remplacé par un autre run ; n'est plus en jeu. | — |
Statuts de version
Les seules transitions légales sont Draft → Published → Archived.
| Token | Sens | Que faire |
|---|---|---|
Draft | Éditable — le seul état qu'acceptent workflow_update_draft et workflow_delete_draft. | Itérez, validez, publiez. |
Published | Gelé et sommé ; exécutable ; jamais muté en silence. | Pour le changer, ouvrez une nouvelle version draft. |
Archived | Terminal ; conservé pour la provenance ; plus de nouveaux runs. | — |
États des nodes d'un run
Les statuts par node tels que rapportés par workflow_run_nodes et le récapitulatif de mission_run_get.
| Token | Sens | Que faire |
|---|---|---|
Pending | Les steps en amont ne sont pas finis ; le node n'est pas encore éligible. | Rien — normal. |
Ready | Éligible, en attente de dispatch. | Rien — normal. |
Dispatched | Remis à son exécuteur, pas encore de progression rapportée. | Rien — normal. |
InProgress | En cours d'exécution. | Suivez via workflow_run_nodes. |
Completed | Terminé avec succès. | — |
Failed | Terminé en échec ; le récapitulatif porte la raison de l'échec. | Voir Refus et modes d'échec. |
Cancelled | Arrêté par la mission ou un opérateur. | — |
Paused | En attente d'une décision humaine ou d'un événement. | Pour les gates : decision_list, puis decision_respond. |
AwaitingGate | Dérivé de Paused : cette pause précise est une gate en attente de décision. | Résolvez-la avec decision_respond. |
Recettes agent : séquences canoniques
Cette page s'adresse à un agent connecté en MCP (ou à l'opérateur qui le pilote) qui connaît déjà les outils un par un et cherche l'ordre éprouvé pour les appeler. Chaque appel renvoie l'enveloppe { success, data } décrite dans la référence agent ; les séquences 1 et 2 ci-dessous sont les deux surfaces d'entrée légales. Chaque séquence donne ses préconditions, les appels numérotés avec leurs paramètres clés, ce que vous devez observer, et où regarder quand un appel refuse.
Aucune séquence de ce livre de recettes ne fait atterrir quoi que ce soit toute seule : chaque chemin se termine sur un gate ou une acceptation, et un proposeur n'approuve jamais sa propre proposition.
Créer, publier, invoquer
La boucle d'authoring complète : d'un draft vide à une mission neuve qui exécute votre graphe.
Préconditions — accès MCP tenant-admin ; un modèle et un provider que vous avez le droit de lier (aucun fallback silencieux à l'invocation).
Étapes
workflow_catalog— lisez d'abord la palette : 138 types de nodes répartis en 17 catégories, chacun avec ses pins. Ne câblez que des connexions compatibles pin à pin ; les types de nodes au cycle de vieLegacysont bloqués à la publication dans les nouveaux drafts.workflow_create_draft— passez votre payload de graphe engraphJson(un squelette minimal suffit) ; vous recevez unidet unworkflowIdà l'étatDraft, le seul état éditable. Il n'y a pas de paramètre de nom ici — définissez le nom d'affichage à part, avecworkflow_rename.workflow_update_draft— envoyez les nodes et les câblages ; répétez autant que nécessaire tant que la version est un draft.- Graphes gouvernés uniquement :
workflow_materializeinjecte les nodes de contrôle requis dans votre draft — de façon déterministe, avant la publication — relisez-les donc comme n'importe quel node que vous avez écrit. Utilisezworkflow_waive_controlavec une raison écrite pour un contrôle qui peut être levé ; certains contrôles ne peuvent pas l'être. Voir Gouvernance. workflow_validate_draft— un essai à blanc du même validateur que la publication. Il agrège tous les problèmes dans une seule réponse : corrigez tout, puis revalidez — ne corrigez pas un problème à la fois en réessayant.workflow_publish— fige le graphe en une version immuable et checksummée (SHA-256). Un renommage ultérieur reste hors du checksum. Voir ce que la publication fige.workflow_invoke— passez uneversionexplicite (≥ 1 : une version publiée, jamais un draft), vos paramètres de run (liés à la compilation), etmodel+provider(requis sauf si les défauts du tenant les résolvent) — ou liez un preset nommé avecpresetIdà la place, le levier que cet écosystème préfère à un modèle brut (référence agent). L'invocation crée une mission neuve autour du run.- Observez :
mission_getpour l'état de la mission,workflow_run_nodespour l'avancement node par node,decision_listpour les gates en attente d'une décision.
Sorties attendues — un workflowId ; un numéro de version publiée ; un id de mission neuf issu de l'invocation ; des gates qui arrivent comme décisions pendant l'exécution.
En cas de refus — les problèmes de validation (dominance des gates, reconvergence de branches, un node Legacy, …) arrivent tous d'un coup sous VALIDATION_ERROR ; toute édition d'une version non-draft renvoie CONFLICT ; l'invocation refuse quand le workflow n'est pas invocable. Causes et remèdes : Refus et modes d'échec.
Lancer un run sur une mission existante
La boucle d'acceptation : démarrez un run sur une mission qui existe déjà, résolvez ses gates, puis acceptez ou écartez ce qu'il propose.
Préconditions — une mission existante, planifiée et non terminale ; un workflowId et une version publiés ; aucun run déjà ouvert sur la mission — sauf compétition délibérée via un groupId partagé.
Étapes
mission_run_start—missionId,workflowId,version, paramètres ;groupIdoptionnel. OmettezgroupIdpour le comportement strictement séquentiel. SeulStartedsignifie qu'un run existe — traitez les 11 statuts de démarrage.- Interrogez
mission_run_getjusqu'à ce que le run atteigneProposed. Pendant l'exécution, les gates se parquent en décisions : listez-les avecdecision_list, résolvez-les avecdecision_respond—approvereprend l'étape,skipl'annule,failla fait échouer. Vous n'approuvez jamais une proposition que vous avez vous-même levée. - Décidez.
mission_run_accept: surAccepted, exactement un changement atterrit sur la branche de la mission, etmission_run_getporte désormais les ancres de seal etisAnchored. L'acceptation est physique et fail-closed : si aucun backend de validation n'est joignable dans votre environnement, l'accept renvoieValidationRefusedet rien ne merge — le run resteProposed. SurStaleRefused, le tip a bougé entre-temps : démarrez un run neuf depuis le nouveau tip ; ne réessayez jamais en boucle. Oumission_run_discard: rien n'a atterri, rien à défaire. Les 7 jetons : statuts d'acceptation. mission_changement_stack— la pile ordonnée de tout ce qui a été accepté jusqu'ici ; la MR de la mission est cette pile composée. Voir changements.- Pour défaire un run accepté :
mission_revert_previewd'abord — il montre la cascade transitive des dépendants — puismission_revert, qui revert en ordre ordinal inverse et échoue fermé en cas de conflit : la cascade s'interrompt proprement et nomme le membre fautif ; rien de partiel n'atterrit.
Variante compétition — démarrez plusieurs runs avec le même groupId depuis le même tip (workflows, paramètres ou instructions de node différents). Acceptez celui que vous gardez ; les autres sont rejetés et leurs branches supprimées ; un accept ultérieur dans le groupe renvoie GroupAlreadyWon.
Sorties attendues — un id de run ; l'issue Proposed → Accepted ou Rejected (issues de run) ; un ordinal de changement par run accepté.
En cas de refus — 10 jetons de démarrage non-Started et 6 jetons d'acceptation non-Accepted, chacun avec son remède : Refus et modes d'échec.
Cloner un template système
Préconditions — rien au-delà de l'accès MCP ; vous clonez dans votre propre tenant.
Étapes
workflow_system_list— les 22 templates intégrés.workflow_system_get— inspectez le graphe avant de cloner ; moins coûteux que cloner juste pour regarder.workflow_clone_from_system— vous recevez un draft neuf qui vous appartient. Le clonage ne publie jamais.- Continuez comme dans la séquence 1, étapes 3 à 6 : éditer, valider, publier.
Les templates sont représentationnels : le clonage vous donne le graphe pour en faire le vôtre, pas un branchement sur le flux que la plateforme exécute en interne. Voir Templates système.
Sorties attendues — un nouveau workflowId à l'état Draft, entièrement éditable.
En cas de refus — le clonage lui-même refuse rarement ; les problèmes hérités remontent à workflow_validate_draft, tous d'un coup — Refus et modes d'échec.
Composer par référence
Préconditions — un draft ouvert en édition ; le sous-workflow à embarquer possède une version Published — seules les versions publiées se résolvent.
Étapes
workflow_tile_catalog— les tiles publiées que vous pouvez embarquer, y compris les blocssys-.- Placez un node FlowRef via
workflow_update_draft. Les pins tunnel de l'enfant se projettent sur la tile ; l'enfant partage votre run et votre acceptation — de la composition, jamais une surface d'invocation séparée. - Avant d'archiver un workflow que d'autres embarquent peut-être :
workflow_referenced_by. L'archivage est refusé tant que la liste n'est pas vide. workflow_rebind_flowref— déplacez un consommateur vers une autre cible. Le rebinding invalide la ratification des gates : les gates concernés doivent être ré-approuvés.
Sorties attendues — un draft dont le FlowRef se résout à la validation ; workflow_referenced_by renvoyant les consommateurs vivants de tout flux publié.
En cas de refus — archiver avec des consommateurs vivants renvoie CONFLICT ; un FlowRef pointant vers une cible non publiée remonte à la validation. Refus et modes d'échec.
Démarrer depuis un trigger
Préconditions — une version publiée, et un moyen de sortir de la surface MCP : il n'existe pas d'outil MCP de trigger de workflow, l'enregistrement passe donc par le dashboard ou par l'API REST de la plateforme. Les triggers ne déclenchent jamais des drafts.
Étapes
- Publiez, comme dans la séquence 1.
- Enregistrez le trigger hors MCP — soit un humain utilise Manage triggers (« Gérer les déclencheurs ») sur le workflow dans la liste des workflows du dashboard, soit vous appelez l'endpoint REST des triggers. Choisissez l'un des trois genres : Schedule (« Planification » — une expression cron), Webhook (l'endpoint porte un secret en écriture seule — stockez-le à la création, vous ne pourrez pas le relire), ou Event (« Événement » — l'un des six seams actifs :
mission.created,conversation.completed,support-case.created,incident.created,batch.completed,mr.merged). - Choisissez la politique de version :
LatestPublishedsuit la dernière version publiée ;Pinnedreste sur celle que vous nommez.selectedModeletselectedProvidersont obligatoires sur le trigger. - Vérifiez un déclenchement :
workflow_runspour les runs du workflow, puismission_getetdecision_listsur la mission créée par chaque déclenchement.
Chaque déclenchement se comporte comme un workflow_invoke : une mission neuve, le même graphe, les mêmes gates. Les triggers ne contournent jamais les gates — un run déclenché se met en pause aux mêmes décisions qu'un run manuel.
Sorties attendues — une nouvelle mission par déclenchement ; les runs visibles via workflow_runs.
En cas de refus — un trigger pointant vers un workflow archivé ou jamais publié ne peut pas se déclencher ; l'omission du modèle ou du provider refuse à l'enregistrement. Refus et modes d'échec.
Refus et modes d'échec
Cette page est la surface de diagnostic des outils workflow et run : quand un appel est refusé, cherchez ici le token ou le code. Chaque entrée donne le token verbatim, l'outil qui le lève, la cause et la récupération. Les tables normatives de tokens vivent dans la référence agent ; les séquences d'appel canoniques dans les recettes agent.
Chaque refus de cette page est fail-closed : Genesis refuse et laisse l'état intact plutôt que de deviner — rien de partiel n'atterrit jamais.
Comment lire cette page
Les refus arrivent sous deux formes :
- un token de statut dans la réponse —
mission_run_startetmission_run_acceptrépondent par un token, et tout token autre queStarted/Acceptedsignifie que l'opération n'a pas eu lieu ; - une enveloppe d'erreur portant un
code— les outils d'authoring et de cycle de vie refusent avecVALIDATION_ERRORouCONFLICT.
Un appel refusé n'exige jamais de nettoyage : corrigez la cause et retentez. Pour l'architecture derrière ces règles, voir le chapitre workflows.
Échecs de publication et de validation
Levés par workflow_validate_draft et workflow_publish, code VALIDATION_ERROR. Le validateur agrège : il signale tous les problèmes du graphe d'un coup ; traitez donc la liste entière avant de revalider — aucune file cachée de problèmes ne se trouve derrière le premier.
| Problème | Ce que le validateur a vu | Correctif |
|---|---|---|
| Dominance de gate | Un chemin de dépendance atteint un node classé écriture sans traverser de gate. | Ajoutez une gate qui domine l'écriture — chaque chemin vers l'écriture doit en traverser une. Voir les gates. |
| Site llm non gouverné | Un node llm générique est lié à un site qui n'est pas un site deny-all enregistré. | Liez le node à un site deny-all enregistré. Les nodes llm génériques ne portent aucun outil, par construction. |
| Toolset d'agent hors politique | Le toolset d'un node agent n'est pas un sous-ensemble de la politique d'outils effective de son site. | Réduisez le toolset à la politique du site. Tout outil déclaré — écriture ou lecture — reclasse aussi le node en écriture à la publication (fail-closed ; seul un toolset vide garde un node classé lecture) — la dominance de gate s'applique alors à lui. |
| Stage manquant sur une écriture | Le graphe est gouverné et un node d'écriture ne porte aucun stage de développement. | Étiquetez le node avec l'un de Design, Implementation, Integration, Verification, PreDeployment. Voir le plancher de publication. |
| Node Legacy dans un nouveau draft | Le draft place un node dont le cycle de vie est Legacy — aujourd'hui exactement un : service:research:llm. Les nodes Legacy sont bloqués à la publication dans les nouveaux drafts. | Remplacez-le par le node Standard courant que le catalogue propose pour le même travail. |
| Reconvergence de bras | Des cas de branch, des décisions de gate ou des bras d'issue reconvergent vers un même node aval. Les bras ne reconvergent jamais. | Gardez la suite de chaque bras séparée. Un bras non routé est une impasse valide. |
| Forme du corps de fan-out | Un corps de fan-out enfreint ses règles de forme : un corps de MapFanOut avec plus d'une étape du catalogue ou d'une référence de sous-workflow, ou une région Loop Body de ForEach portant des nodes structurels. | Déplacez un corps multi-étapes dans son propre workflow et référencez-le — ou, pour ForEach uniquement, câblez-le en région Loop Body d'étapes simples du catalogue. Les nodes structurels ne s'imbriquent jamais dans un corps de fan-out. |
| Segment d'id réservé | Un id de node utilise un segment réservé (__ ou #). | Renommez le node. |
| Contrôle non dérogeable | Une dérogation a été demandée sur un contrôle qui ne peut pas être levé. | Il n'existe aucun chemin de contournement — publiez avec le contrôle injecté en place. Voir les dérogations. |
Conflits de cycle de vie
Code CONFLICT. Ces refus protègent le cycle de vie à trois états — Draft → Published → Archived, dans cet ordre uniquement.
| Conflit | Levé par | Sens | Que faire |
|---|---|---|---|
Édition hors Draft | workflow_update_draft, workflow_delete_draft | La version visée est Published ou Archived. Seul un draft peut être édité ou supprimé. | Créez un nouveau draft — les graphes publiés sont immuables, un changement atterrit donc toujours comme nouvelle version. |
| Archivage d'une version non publiée | workflow_archive | Seules les versions Published s'archivent. Un draft se supprime, il ne s'archive jamais. | Utilisez workflow_delete_draft sur les drafts. |
| Archivage bloqué par des références vivantes | workflow_archive | Un workflow publié embarque encore celui-ci comme sous-workflow. | Listez les consommateurs avec workflow_referenced_by, déplacez-les avec workflow_rebind_flowref (le rebinding invalide la ratification des gates — ils ré-approuvent), puis archivez. |
Refus au démarrage d'un run
Levés par mission_run_start. Tout token autre que Started signifie qu'aucun run n'a été créé. Le vocabulaire complet des 11 tokens est dans la référence agent ; la séquence qui les traite est attacher et lancer.
| Token | Sens | Que faire |
|---|---|---|
RunAlreadyOpen | La mission a déjà un run ouvert, et les runs sont strictement séquentiels par défaut. | Acceptez ou écartez d'abord le run ouvert — ou utilisez la compétition par groupId dès le départ quand vous voulez des candidats en parallèle. |
ChildSpawnerDisallowed | Le graphe contient un node qui engendre des missions enfants ; ces nodes ne peuvent pas tourner dans un run de mission. | Retirez ou remplacez le node en question, republiez, puis retentez. |
FeatureDisabled | Workflows:MissionRuns:StartEnabled est désactivé dans cet environnement. | Demandez à votre opérateur de l'activer ; aucun paramètre d'appel ne contourne un flag désactivé. |
MissionNotPlanned | La mission n'a pas encore de plan approuvé. | Laissez la planification se terminer et faites approuver le plan, puis retentez. |
MissionTerminal | La mission est finie — terminée, échouée ou annulée. | Démarrez une nouvelle mission, ou créez-en une directement avec workflow_invoke. |
AgenticMissionUnsupported | Le type de cette mission ne peut pas accueillir de runs de workflow. | Utilisez une mission qui le peut, ou créez-en une neuve avec workflow_invoke. |
TipUnavailable | Le tip de la branche de mission n'a pas pu être résolu pour l'instant. | Retentez. Si ça persiste, demandez à votre opérateur. |
WorkflowNotFound | L'id de workflow et la version ne résolvent vers aucun workflow connu. | Vérifiez l'id avec workflow_list et la version avec workflow_get. |
NotInvocable | La version existe mais n'est pas exécutable — c'est un draft, ou elle est archivée. | Publiez d'abord ; un run démarre toujours d'une version publiée explicite. |
MaterializationFailed | La construction de l'instantané d'exécution figé pour ce run a échoué. | Validez le workflow et ses liaisons de paramètres, puis retentez. Si ça persiste, demandez à votre opérateur. |
Refus à l'acceptation
Levés par mission_run_accept. Tout token autre que Accepted signifie que rien n'a fusionné : aucun changement n'a été créé et le tip de la mission n'a pas bougé. Le vocabulaire complet est dans la référence agent.
| Token | Sens | Que faire |
|---|---|---|
StaleRefused | Le tip de la mission a bougé après le démarrage de ce run ; sa base est périmée. | Démarrez un run neuf depuis le nouveau tip. Ne tentez jamais de forcer un accept périmé. |
MergeConflict | La branche du run ne fusionne plus proprement sur le tip de la mission. | Démarrez un run neuf depuis le tip courant et laissez-le proposer à nouveau la modification. |
GroupAlreadyWon | Un autre run du même groupe de compétition a déjà été accepté. Les runs perdants sont rejetés et leurs branches supprimées. | Rien à récupérer — le groupe a son gagnant. Démarrez un nouveau run s'il vous faut encore la modification. |
NotProposed | Le run n'est pas en Proposed — il s'exécute encore, ou a déjà été accepté ou écarté. | Interrogez mission_run_get jusqu'à ce qu'il atteigne Proposed, en résolvant les gates en attente avec decision_respond. |
TipUnavailable | Le tip de la branche de mission n'a pas pu être résolu pour l'instant. | Retentez. Si ça persiste, demandez à votre opérateur. |
Le dernier token mérite sa propre entrée, parce qu'il découle de la doctrine d'acceptation et non de l'état du run :
ValidationRefused— L'acceptation est physique : avant qu'un run ne fusionne, Genesis valide la branche du run en l'exerçant — jamais par un verdict de LLM. Le contrôle est fail-closed : si aucun backend de validation n'est joignable dans votre environnement, l'acceptation est refusée plutôt que laissée passer. Le run reste intact enProposed; rien ne fusionne. Récupération : confirmez qu'un backend de validation est disponible (demandez à votre opérateur), puis retentez l'acceptation.
Le revert refuse sur conflit
Levé par mission_revert. Un revert défait les changements en ordre inverse, en cascadant sur les dépendants. Il est fail-closed sur conflit : si un changement de la cascade ne peut pas être défait proprement, toute la cascade s'interrompt et le refus nomme le membre fautif. Rien de partiel n'atterrit — la branche de mission est exactement comme avant l'appel.
Récupération :
- Lancez d'abord
mission_revert_preview— il montre la cascade complète de dépendants avant que vous ne vous engagiez. - Inspectez le changement nommé dans la pile (
mission_changement_stack) et résolvez ce qui le fait entrer en conflit. - Retentez. Un revert refusé n'a rien changé ; retenter est donc toujours sûr.
Voir la pile de changements pour la façon dont les changements se composent sur la branche de mission.
L'orchestrateur
Cette page existe pour que vous ne soyez pas surpris en voyant le mot. L'orchestrateur est de la plomberie interne ; vous n'avez pas besoin de le connaître pour un usage normal.
L'orchestrateur en un paragraphe
L'orchestrateur est la couche interne de recherche et de connaissance d'ARDS. Quand il a besoin de prendre une décision qui n'est pas un simple appel d'outil — choisir quelle variante de coder assigner, décider de couper une tâche en deux, comparer deux pistes d'implémentation — sa couche de raisonnement déclenche une petite mission de recherche. Elle mène une enquête en parallèle (codebase, docs, web), synthétise une réponse et la rend à l'orchestrateur.
Le tableau de bord Orchestrator
La page Orchestrateur n'est pas dans la barre latérale — ouvrez l'index Toutes les fonctionnalités (l'entrée « … » en bas de la barre latérale) et cherchez Orchestrateur. Le tableau de bord montre une vue d'ensemble — statut des experts, requêtes traitées, vagues de maintenance récentes — et une rangée Explorer de surfaces voisines :
- Compositions d'équipes — historique des compositions d'équipes et recommandations.
- Expansions d'intentions — historique des expansions d'intentions et règles d'implication.
- Diagrammes vivants — diagrammes système auto-générés avec suivi des différences.
- État du système — analyse de l'harmonie système et métriques d'équilibre.
- Exécuteur de scénarios — scénarios de validation système et exécution de tests.
- Banc de validation — tester des prompts sur plusieurs LLMs et comparer les réponses.
- Canal courriel — notifications sortantes et traitement des courriels entrants.
- Tableau de bord migration — planification de migration système et cartographie du contexte.
- Traces des experts — déboguer le routage des experts, les consultations et la qualité des réponses.
Ce sont des surfaces de recherche, et les parcourir ne risque rien — mais tout n'y est pas en lecture seule. Déclencher la maintenance sur le tableau de bord se trouve derrière une boîte de confirmation ; l'Exécuteur de scénarios a de vrais boutons Lancer et Tout lancer qui exécutent réellement les scénarios de validation ; et le Banc de validation a un panneau Nouvelle exécution qui envoie des prompts de test à plusieurs LLMs (vrais appels, vraie dépense), plus un Annuler sur les exécutions en cours. Laissez ces contrôles tranquilles sauf demande d'un opérateur ; tout le reste s'explore librement sans rien casser.
Quand vous verrez l'orchestrateur dans l'interface
- Dans la décomposition de mission : une longue mission peut afficher « Investigating… » pendant la planification. C'est normal. Les missions qui exécutent un workflow sautent en grande partie ce raisonnement au moment de la décomposition — le graphe est déjà le plan — donc le comportement « Investigating… » concerne les missions nées d'une conversation.
- Dans Costs : il y a une ligne de point d'appel Orchestrator aux côtés de Planning, Coder, Review Engine. Généralement une petite fraction de la dépense totale.
- Dans les résultats de Search : les sorties de missions de recherche sont recherchables comme les conversations.
Ce que les testeurs peuvent faire avec l'orchestrateur
Rien d'obligatoire en v1. Pas de bouton « lancer une recherche » exposé aux testeurs ; l'orchestrateur la déclenche au besoin. (Le seul contrôle actif de son tableau de bord, Déclencher la maintenance, est pour les opérateurs.)
Si vous voulez une réponse de style recherche d'ARDS — « passe la codebase en revue et dis-moi ce qu'il y a » — le bon chemin est de démarrer une conversation et de demander ça. Le planificateur la routera via l'orchestrateur sous le capot.
Review Engine
Le Review Engine est le revueur automatique — mais pas des diffs. Il balaye les surfaces d'un projet (pages, code, config, données, pipelines) et produit des findings sur des domaines de qualité, à la demande comme sur planning. Les revues des diffs produits par les coders se passent sur la page Revues ; c'est un mécanisme séparé.
Ce qu'il couvre
Les findings viennent de domaines — chacun est un onglet du tableau de bord. L'ensemble intégré :
- Security, Architecture, Code Quality, Functional, Data Integrity
- Design Coherence, Discovery, Pipeline Health
- Regulatory Compliance, Third-Party Risk, UI/UX
Chaque domaine produit des findings avec une sévérité — Info / Low / Medium / High / Critical — et un résumé d'une ligne.
Ce qu'il passe en revue
Les sessions de revue tournent sur des cibles inventoriées par projet : pages de l'application, projets de code, fichiers de config, tables de base de données, outils MCP, dépôts. Chaque onglet de domaine a un Inventaire des cibles listant ce qu'il connaît. Toute la page est cadrée sur le projet sélectionné dans la barre du haut.
Comment il tourne
- Sur planning — un pulse quotidien (vérifications automatiques légères) et une revue hebdomadaire approfondie tournent par projet, donc des sessions et des findings apparaissent sans aucune action de votre part. Le panneau Planification de maintenance du tableau de bord montre le dernier pulse quotidien, la dernière revue hebdomadaire approfondie, le dernier commit révisé, et les seuils de conversation : quand un balayage produit assez de findings au niveau de sévérité configuré ou au-dessus, le moteur ouvre une conversation à leur sujet, et les findings High/Critical lèvent des demandes d'attention.
- Manuellement — cochez les domaines voulus dans le panneau de sélection et cliquez Réviser les domaines sélectionnés (une boîte de dialogue demande avec quel preset LLM tourner). Sur l'onglet d'un domaine, vous avez Réviser domaine et, pour les domaines qui le supportent, Déclencher la maintenance.
Les cases à cocher des domaines ne cadrent que le run que vous démarrez — il n'y a pas d'interrupteur marche/arrêt par domaine sur cette page, et rien ici ne bloque de merge : le moteur n'a aucun mode de blocage de merge.
Lire les findings
Un finding a un domaine, une sévérité, un statut, une catégorie, un titre et une description, la cible où il a été repéré, et généralement une recommandation. Cliquez un finding pour ouvrir le panneau de détail ; de là vous pouvez ajouter une note et agir : Accuser réception, Ouvrir un Dossier, Ne sera pas corrigé, Résoudre.
États des findings :
- Open — frais, pas trié.
- Investigating — marqué en cours d'examen.
- Resolved — réglé.
- Dismissed — vous avez décidé que ce n'était pas un vrai problème. Reste en historique.
- Deferred — repoussé à plus tard.
Quand les findings ont tort
Le Review Engine utilise des règles et des jugements LLM. Il signale parfois des choses qui n'en sont pas. Marquer un finding Ne sera pas corrigé (avec une note qui dit pourquoi) est une issue parfaitement valable — les findings rejetés restent en historique et recherchables.
Ce que le Review Engine n'est pas
- Pas un scanner de sécurité sur lequel parier votre vie. Ne le substituez pas à un SAST/DAST.
- Pas un compilateur. Certaines erreurs « évidentes » peuvent passer si elles n'apparaissent qu'avec une certaine configuration de build.
- Pas un substitut à la revue du travail des coders. Les diffs de vos missions se relisent sur la page Revues — les findings du moteur vivent ici, sur son propre tableau de bord.
Quand utiliser la page Review Engine
- Vérifier ce que les balayages planifiés ont trouvé — les onglets de domaine portent des badges de findings ouverts, et les cartes de domaine du tableau de bord montrent les comptes open/critical et la date de dernière revue de chaque domaine.
- Démarrer une revue ciblée après un gros changement dans un projet.
- Parcourir l'inventaire des cibles et les règles de chaque domaine.
- Trier les findings — accuser réception, résoudre, ou ouvrir un dossier depuis les bons.
La page se trouve sur l'index Toutes les fonctionnalités (l'entrée « … » en bas de la barre latérale), sous Moteur de revue.
Ghost Evaluation
Ghost Evaluation est la machinerie « un autre modèle aurait-il fait aussi bien ? » d'ARDS. Utile quand vous décidez quel modèle épingler à un point d'appel et que vous voulez des preuves, pas des intuitions.
Ce qu'il fait
Ghost rejoue des appels LLM contre un ou plusieurs modèles fantômes et compare la réponse de chaque fantôme avec la réponse que le produit a réellement utilisée (la réponse de référence). Deux choses l'alimentent :
- Les évaluations fantômes, automatiques. Des appels réels issus des points d'appel de la plateforme — dialogue, research, critic, decomposition, classification, coder — sont rejoués en arrière-plan contre les modèles fantômes configurés. Vous ne les lancez pas ; elles s'accumulent toutes seules.
- Les évaluations à la demande. Vous pouvez en mettre une en file vous-même depuis le tableau de bord (voir plus bas).
Les runs Ghost sont fantômes : ils ne changent jamais l'état produit. La conversation d'origine est intacte ; les résultats vivent sur le tableau de bord Évaluations fantômes, scorés et comparables. Chaque évaluation compare un modèle fantôme côte à côte avec la réponse de référence — il n'y a pas de matrice à N modèles.
Quand c'est utile
- « Un modèle moins cher tiendrait-il le point d'appel de planification ? Le classement porte des semaines de preuves. »
- « Un modèle open-weight répond-il au dialogue aussi bien que le défaut, pour une fraction du coût ? »
- « Nous avons changé le modèle par défaut — le caractère des réponses a-t-il vraiment bougé ? »
Le tableau de bord
Deux onglets principaux :
- Statistiques — filtrez par type de source, lisez les compteurs (Total / Terminé / Échoué / Délai dépassé) et le Classement des modèles : par modèle fantôme, ses évaluations terminées, la concordance moyenne, le score du juge, la latence, les tokens et les échecs. Les lignes surlignées en vert sont les candidats à la promotion — modèles avec ≥ 90 % de concordance sur ≥ 50 évaluations.
- Evaluations — les runs individuels, filtrables par source, statut et modèle. Cliquez une ligne pour ouvrir le détail : la décomposition de la concordance, les scores du juge quand il est activé, une comparaison latence et tokens, et une Comparaison côte à côte de la réponse fantôme et de la réponse de référence. Un bouton Relancer remet le même prompt en file.
En lancer une vous-même
Cliquez Nouvelle évaluation sur le tableau de bord :
- Sur l'onglet Manual, tapez un prompt (plus un system prompt optionnel) — ou passez sur From History et choisissez un seul message d'une conversation passée (avec options pour inclure son contexte et son system prompt).
- Cochez éventuellement Activer le scoring par juge LLM.
- Cliquez Lancer l'évaluation. Le prompt est mis en file contre chaque modèle fantôme configuré.
Vous ne choisissez pas les modèles dans la boîte de dialogue. Quels modèles fantômes tournent — et quel modèle juge — relève de la configuration du tenant, résolue côté serveur depuis la Config LLM (le point d'appel des modèles fantômes prend une liste de modèles séparés par des virgules).
Scoring
Chaque évaluation terminée reçoit un score de concordance calculé sans LLM : ratio de longueur, recouvrement de mots-clés et similarité structurelle par rapport à la réponse de référence.
Si le juge est activé, un modèle juge compare aussi les deux réponses sur des dimensions fixes — similarité sémantique, exactitude factuelle, complétude — plus un score global et un court raisonnement écrit. Les dimensions sont fixes ; il n'y a pas de grille par run ni de mode multi-juges. (Les instructions du juge peuvent être surchargées au niveau du tenant sur l'onglet Invites de Config LLM, comme les autres prompts système.) Le juge est lui-même un appel LLM avec ses propres biais — lisez le raisonnement, pas seulement le chiffre.
Considérations de coût
Chaque prompt évalué tourne une fois par modèle fantôme configuré, et le juge ajoute un appel LLM de plus par évaluation. La dépense Ghost croît avec la taille de la liste de modèles fantômes — gardez-la courte. Il n'y a pas d'affichage de coût projeté ; surveillez le tableau de bord Costs si vous doutez de ce que Ghost dépense.
Ce que Ghost ne fait pas
- Ne rejoue pas les appels d'outils. Quand le travail d'origine impliquait des éditions de fichiers et des commandes, Ghost ne peut pas ré-exécuter les effets de bord. Il ne rejoue que l'échange au niveau LLM.
- Ne change rien en production. Même quand un modèle fantôme surclasse le modèle de référence, rien ne bascule automatiquement. Servez-vous des preuves pour mettre à jour la Config LLM, puis lancez du nouveau travail.
Réglage de la flotte
La flotte de coders est le pool de conteneurs qu'ARDS lance pour exécuter les tâches. En v1, vous n'avez presque jamais besoin de la régler — les défauts sont dimensionnés pour la charge typique d'un testeur. Cette page existe pour que vous puissiez le faire si vous voulez.
Où regarder
- Config LLM → onglet Outils — la maison de la flotte depuis la consolidation des surfaces. On y trouve les paramètres par défaut de la flotte (outil, variante, modèle, concurrence, budget de tours), la configuration par outil avec le compte en direct des instances actives, les limites de ressources par variante, et les registres de conteneurs. L'ancienne page Fleet Resources atterrit ici automatiquement. Config LLM se trouve sur l'index Toutes les fonctionnalités (l'entrée « … » en bas de la barre latérale).
- Page Fleet Profiles — des jeux de configuration nommés, posés par-dessus les défauts système. Elle n'a pas d'entrée dans la barre latérale ; ouvrez
/fleet/profilesdirectement. - Page Flotte Coder — l'exploitation en direct, pas la configuration : un onglet Moniteur Coder (coders qui tournent) et un onglet Tableau de bord des files (ce qui attend). Lecture diagnostique uniquement.
Ce que vous pouvez régler
Sur l'onglet Outils de Config LLM :
- Paramètres par défaut — Outil par défaut, Variante par défaut, Modèle par défaut, Max. concurrent (défaut 3) et Max. tours (défaut 30). Augmentez la concurrence si vous avez une grosse mission avec des tâches parallélisables ; diminuez pour brider la dépense (chaque coder consomme des tokens indépendamment).
- Configuration des outils — une carte par outil coder, avec activation et clé API. Chaque carte affiche combien d'instances sont actives en ce moment.
- Limites de ressources, par variante (
standard/browser/android) — mémoire, CPU, mémoire partagée (SHM) et Max Instances. N'augmentez la mémoire que si une page tâche montre des OOM kills dans les logs ; les variantes browser et Android ont besoin de l'allocation SHM.
Les chaînes de fallback de modèles ne sont pas un réglage de flotte — elles vivent dans la configuration LLM. Pour les runs de workflow, les liaisons de preset résolues au dispatch priment — voir les presets.
Profils
La page Fleet Profiles gère des jeux de configuration nommés avec des surcouches parcimonieuses : un profil ne stocke que les champs qui diffèrent de son parent ; tout le reste s'hérite. Un seul profil est livré d'origine — System defaults (marqué d'un badge S ; non supprimable). Il n'existe pas d'autres presets intégrés.
- Boutons : New Profile, Clone, Delete, Save Profile, Preview Resolved.
- Champs d'un profil : une description, un Parent Profile optionnel, les défauts (Default Tool —
claude,copilot,codex,gemini,aider,octofriend,junieoucustom; Default Variant —standard,browser,android; Default Model ; Max Concurrent ; Max Turns), des variables d'environnement au niveau du profil, et une vue en lecture seule des overrides par outil. - La résolution suit défauts système → profil parent → profil → overrides par projet ; des badges de provenance à côté de chaque champ montrent d'où vient la valeur résolue, et Preview Resolved affiche la configuration finale fusionnée.
Les profils s'appliquent par projet, et lier un profil à un projet passe pour l'instant uniquement par l'API — il n'y a pas de bouton dans l'interface pour ça. Tant qu'aucune liaison n'est faite, chaque projet tourne sur les défauts système.
Profils de flotte vs presets de workflow
Les noms se ressemblent ; les métiers, non. Un profil de flotte configure comment les coders tournent pour un projet : quel outil coder et quelle variante, le modèle par défaut, combien tournent en même temps, le budget de tours. Un preset de workflow est un lot de choix de modèle et de provider lié à un workflow, résolu au dispatch — le scope le plus spécifique gagne, et il l'emporte sur le modèle saisi sur le canvas. Réglez les coders ici ; réglez ce que les nodes d'un workflow utilisent dans les presets.
Quand s'inquiéter de la flotte
- Les tâches font la queue éternellement avant de démarrer → Max. concurrent (paramètres par défaut) ou le Max Instances de la variante est trop bas pour votre charge. Augmentez-le sur l'onglet Outils.
- Les tâches meurent en « out of memory » → montez la limite mémoire de la variante sur l'onglet Outils.
- La dépense a doublé pendant la nuit → vérifiez le Modèle par défaut des paramètres de flotte, et souvenez-vous que plus de concurrence = plus de dépense de tokens en parallèle.
Quand laisser tranquille
Si vous faites 1 à 3 missions par semaine de portée modérée, les défauts livrés sont correctement dimensionnés. Aller plus loin ne paie en général pas.
L'onglet Outils expose aussi quelques contrôles à grain opérateur (registres Docker, découverte d'images). N'y touchez pas sauf indication d'un opérateur — c'est pour l'équipe plateforme, pas pour les testeurs.
Comment fonctionne Genesis
Genesis est un orchestrateur multi-agent de livraison logicielle. Vous décrivez un résultat attendu en langage courant ; Genesis planifie le travail, le découpe en tasks, dépêche des agents de codage IA pour l'exécuter, applique les gates de gouvernance et de review, suit chaque dollar dépensé en modèles et expose l'ensemble du pipeline aux humains via un tableau de bord, une API REST et un large catalogue d'outils MCP. Il est multi-tenant : un même déploiement héberge de nombreux Tenants clients isolés, chacun avec ses propres projects, missions, agents, conversations, coûts et posture de compliance.
Cette page est la carte. Elle explique les grandes pièces et la façon dont elles s'articulent, puis renvoie vers une page dédiée à chaque sous-système. Chaque page de sous-système est écrite sous deux angles : la surface opérateur / produit (ce qu'il fait et comment vous le pilotez — outils MCP, contrôleurs REST, pages du tableau de bord) et l'architecture interne (les services, le modèle de données et les rouages d'exécution).
La forme du système
Genesis est organisé en une hiérarchie d'intention qui se resserre de la stratégie vers l'exécution :
- Tenant — la frontière d'isolation de plus haut niveau (un client). La control-plane database contient le registre des Tenants, les environnements et tous les catalogues partagés (fournisseurs LLM / presets / routage, workflows système, le catalogue des exigences/contrôles de compliance, les règles constitutionnelles, les profiles de fleet). Chaque Tenant dispose ensuite de ses propres données opérationnelles (missions, tasks, agents, conversations, coûts, reviews, connaissances) dans une tenant database. La ténance est implicite via la base de données par Tenant — il n'y a pas de colonne
TenantId(ADR-008). - Project — une unité de travail à l'intérieur d'un Tenant, généralement liée à un ou plusieurs dépôts Git. Les projects regroupent les missions, portent une arborescence de fichiers/modules enregistrée, appliquent une politique de frontière et constituent la portée pour les coûts, les connaissances et la configuration de fleet.
- Charter → Matter → Mission → Task — la hiérarchie de travail. Un Charter est une initiative stratégique (il porte une Vision et des critères d'acceptation). Un Matter est un épic stratégique sous un Charter. Une Mission est un élément concret de travail livrable qui se décompose en Tasks, les unités atomiques que les agents exécutent réellement.
- Track — chaque mission et chaque conversation s'exécute dans l'une de quatre tracks qui cadrent le type de travail : Governance (politique), Research (stratégie / investigation), Planning (commande / décomposition) et Build (exécution). (Du code plus ancien persiste cette information sous un nom de champ hérité ; elle désigne toujours la Track.)
Les deux pierres angulaires
Deux sous-systèmes sont le cœur de Genesis et disposent de leurs propres guides détaillés.
- Agents — les travailleurs autonomes. Un Strategic Orchestration Agent natif (et un Compliance agent permanent) s'exécutent sur un cœur événementiel (
agent_instances+agent_event_queue) et sont auto-cadencés : unAgentDispatcheren arrière-plan fait avancer chaque instanceActive, l'agent lit son journal d'événements, planifie via un appel LLM à provenance enregistrée, puis entreprend des actions typées et gouvernées. Les agents de type mission (Feature, Research, Review, onboarding, etc.) enveloppent ce cœur pour mener une mission spécifique jusqu'à son terme. Le travail de codage est délégué aux coders — des outils CLI conteneurisés (Claude, Copilot, Codex, Gemini, Aider, Octofriend) instanciés par task. Consultez le guide Agents pour le cycle de vie complet, le modèle d'événements, les budgets et les rouages de dispatch. - Workflows — un graphe réutilisable et versionné d'étapes typées (stocké sous forme de
GraphJson, avec un cycle de vie Draft → Published et une somme de contrôle de contenu). Invoquer un workflow publié compile le graphe en une mission dont les tasks portent le câblage des étapes ; les étapes de type gate deviennent des décisions d'approbation en attente que des humains résolvent, et la mission enregistreworkflowId@version+ la somme de contrôle comme provenance de compliance. Les workflows peuvent embarquer des contrôles de compliance issus d'un catalogue versionné (avec des dérogations par exécution). Consultez le guide Workflows pour le modèle de nœuds/pins, le compilateur, les gates, les contrôles, les déclencheurs et les rouages d'exécution.
Les couches transversales
Trois couches s'exécutent sous tout ce qui précède :
- Dialogue — des conversations stratégiques avec le modèle qui peuvent proposer des missions à l'approbation humaine (la principale rampe d'accès de l'idée au travail).
- La couche de routage LLM — chaque appel de modèle est attribué à un call site nommé (p. ex.
Missions:Decomposition,ReviewEngine:Architecture). Un preset rattaché à ce site résout, au moment du dispatch, le fournisseur, le modèle, la chaîne de routage (avec ses fallbacks), la politique d'outils, l'échantillonnage / les limites et l'overlay de prompt. Les Modes appliquent atomiquement tout un lot de rattachements de sites. Consultez LLM Configuration & Prompt Overlays. - Coûts & gouvernance — chaque appel écrit un enregistrement de coût (tokens, cache, tarification batch, USD estimés) attribué à sa mission / task / project ; les budgets, quotas, règles constitutionnelles et gates de compliance contraignent ce que les agents ont le droit de faire. Consultez Costs & Budgets.
Guide des sous-systèmes
| Page | Ce qu'elle couvre |
|---|---|
| Workflows | Graphes d'étapes réutilisables et versionnés ; compilation en mission ; gates, contrôles, déclencheurs, observabilité des exécutions. |
| Agents | Agents permanents et de mission ; le dispatcher, l'ordonnancement des ticks, les budgets par tick, le pipeline d'appel LLM, le rail de gouvernance. |
| Missions & Tasks | La colonne vertébrale d'exécution — cycle de vie des missions, décomposition, tasks et gates de décision humaine. |
| Charters & Matters | La couche stratégique au-dessus des missions — initiatives et épics. |
| Dialogue | Des conversations stratégiques qui proposent des missions à l'approbation. |
| Compliance | Posture réglementaire continue, évaluations, incidents, SBOM, dossiers. |
| Support Cases | Le service de support assisté par agents et ses playbooks. |
| Intelligence & Knowledge | Profilage de la base de code, corpus de connaissances, prisms, aspects, scaffolding. |
| LLM Configuration & Prompt Overlays | Presets, call sites, modes, fournisseurs, identifiants, overlays. |
| Costs & Budgets | Comptage des dépenses, attribution, quotas et garde-fous budgétaires. |
| Projects & Workspaces | Enregistrement des bases de code et workspaces de travail éphémères des agents. |
| Atlassian : Jira & Confluence | Le Jira/Confluence du client, le chemin d'écriture soumis à approbation, et les sites de portée produit. |
| Reviews & Ghost Evaluation | Gates d'approbation, le moteur de review automatisé et les tests A/B hors ligne de prompts/modèles. |
| Fleet & Profiles | Configuration en couches qui se résout en une configuration effective de coder-fleet par project. |
| Fonctionnalités activables | Le catalogue complet et généré des fonctionnalités activables : niveau déploiement (valeurs de release) × niveau locataire (Paramètres → Fonctionnalités), valeurs par défaut, et comment basculer chacune. |
Workflows
Un Workflow est une automatisation réutilisable et versionnée qu'un opérateur rédige une fois et exécute de nombreuses fois. Il s'agit d'un graphe orienté d'étapes typées — LLM call sites, lectures système, actions d'écriture inline, opérations de service, approval gates (portes d'approbation) humaines et constructions de contrôle de flux (branche / boucle / fan-out dynamique) — reliées entre elles par des pins. Lorsque vous exécutez un workflow, Genesis compile le graphe en une mission dont les tasks s'exécutent sur le moteur de mission existant, chaque gate étant mise en pause derrière une décision humaine et le workflowId@version d'origine + checksum étant épinglés sur le run comme provenance de compliance.
Les workflows sont des artefacts d'authoring propres à chaque tenant : chaque tool et endpoint est protégé par la politique tenant-admin, et la tenancy est implicite via la base de données par tenant (pas de colonne TenantId — ADR-008), exactement comme pour les missions et les tasks.
Cette page couvre les deux surfaces :
- Opérateur / produit — ce qu'est un workflow, son cycle de vie, la surface d'outils MCP, l'API REST et les pages du dashboard.
- Architecture — le modèle de données, l'IR du graphe et le modèle de pins, le catalogue d'étapes, les mécanismes internes materialize → publish → invoke → run, les workflows système vs tenant, les triggers, la gouvernance de compliance, la couche d'acceptation des mission runs (runs → changements) et la relation entre workflows, missions et agents.
1. Guide de l'opérateur
1.1 Ce qu'est un workflow
| Concept | Signification |
|---|---|
| Workflow | Une identité logique stable (workflowId, ex. wf3f9ac21b04) qui possède une série ordonnée de versions immuables. |
| Version | Une révision monotone (1, 2, 3, …) d'un workflow. Une version est une charge utile de graphe plus un status de cycle de vie. |
| Graphe | Un objet JSON { irVersion, nodes, edges, params } décrivant les étapes et la manière dont leurs pins se connectent. |
| Étape (node) | Une unité de travail : un LLM call site, une lecture, une action d'écriture, une opération de service, une gate ou une construction de contrôle de flux. |
| Pin | Un point de connexion typé sur une étape. Les pins Exec (in/out) ordonnent l'exécution ; les pins data (Json/String/Number/Bool/Document/Artifact/Context) transportent des valeurs typées. |
| Gate | Une étape d'approbation humaine. Toute étape capable d'écriture doit se situer derrière une gate (imposé au publish). |
| Run | Une mission lancée depuis une version publiée. Il n'existe pas de table « run » distincte — un run est une mission estampillée avec la provenance du workflow. |
| Tunnel | La signature de pins d'entrée/sortie propre à un workflow, utilisée lorsqu'il est intégré comme étape à l'intérieur d'un autre workflow (composition FlowRef). |
1.2 Le cycle de vie
                 update_draft / materialize / waive_control / validate_draft
                 ┌───────────────────────────┐
                 ▼                            │
  create_draft ───►  DRAFT  ──── publish ───►  PUBLISHED  ──── archive ───►  ARCHIVED
       │              │  (validate + freeze)        │
       │              │                             │
       │          delete_draft                   invoke ───► RUN (a mission)
       │         (permanent)                         │
       └─ clone_from_mission / clone_from_system ────┘ (always lands a new DRAFT)
Les seules transitions de status légales sont Draft → Published et Published → Archived :
- Draft — la version de travail mutable ; le seul état qui accepte les éditions de graphe. Le premier draft d'un nouveau workflow est la version 1 ; versionner un workflow existant ajoute
max(version)+1. - Update — remplacer la charge utile graphe/tunnels du draft autant de fois que nécessaire.
- Materialize (optionnel, workflows gouvernés) — injecter les étapes gate/review de compliance requises depuis le catalogue de contrôles actif avant le publish, afin que l'opérateur les examine sur le canvas.
- Publish — valider, puis figer. La validation signale tous les problèmes d'un coup (vérifications catalogue/site, compatibilité de pins, pins requis, cycles, dominance de gate, plancher de compliance). En cas de succès, la version devient immuable, reçoit un checksum SHA-256, estampille
PublishedAtet devient invocable. À tout moment avant cela,workflow_validate_draftexécute la validation identique en dry run — la même liste agrégée de problèmes, sans figer, sans changement de status. - Invoke — exécuter une version publiée comme une nouvelle mission. Plusieurs versions publiées du même workflow peuvent coexister ; vous choisissez laquelle exécuter.
- Runs — observer les missions lancées par workflow, par version et par node.
- Archive — retirer une version publiée (terminal ; plus invocable, conservée pour la provenance). Le Delete n'est autorisé que sur les drafts ; les versions publiées sont immuables et doivent être archivées à la place.
1.3 La surface d'outils MCP
Tous les outils résident dans WorkflowMcpTools (noms différés workflow_*), sont protégés par TenantAdminPolicy et appellent les mêmes services que les contrôleurs REST via une portée in-process (Core est le service — pas de saut HTTP). Chaque outil renvoie une enveloppe { success, data } (ou { success:false, error, code }).
Authoring
| Tool | Objet | Entrées clés | Retourne |
|---|---|---|---|
workflow_create_draft | Créer une nouvelle version draft à partir d'une charge utile de graphe. | graphJson ; optionnels workflowId (omis = nouvelle identité, version 1 ; fourni = version suivante), tunnelsJson | { id, workflowId, version, status } |
workflow_update_draft | Remplacer le graphe/tunnels d'un draft. Drafts uniquement. | id (GUID), graphJson, optionnel tunnelsJson | { id, workflowId, version, status }. Erreurs : NOT_FOUND, CONFLICT (pas un draft) |
workflow_materialize | Injecter les contrôles de compliance requis (nodes human-gate + regulatory-review) dans un draft depuis le catalogue de contrôles actif, en s'appuyant sur les stades de développement dont les nodes sont taggés. S'exécute avant le publish ; déterministe + idempotent. | id | { id, workflowId, version, status } |
workflow_waive_control | Enregistrer une dérogation explicite et auditée autorisant le publish malgré un contrôle requis manquant. | id, controlId (ex. DORA-P1-PROT-004), reason | { id, workflowId, version, status } |
workflow_validate_draft | Exécuter en dry run la validation complète de publish sur un draft sans le figer — le même validateur composite que celui du publish, chaque problème signalé d'un coup ; le draft conserve son status. | id | La liste agrégée de problèmes (vide quand le draft publierait proprement) |
workflow_publish | Valider + figer un draft. | id | { id, workflowId, version, status, checksum, publishedAt }. Erreur : VALIDATION_ERROR (liste chaque problème) |
workflow_rename | Définir le nom d'affichage du workflow (partagé par toutes les versions ; hors du checksum, donc renommer un workflow publié est autorisé). | workflowId, name | { workflowId, name, updatedVersions } |
workflow_archive | Archiver une version publiée (terminal). Gardé : refusé tant qu'un consommateur FlowRef publié et vivant référence encore le workflow — vérifiez workflow_referenced_by d'abord. | id | { id, workflowId, version, status }. Erreur : CONFLICT (pas Published) |
workflow_delete_draft | Supprimer définitivement une version draft. | id | { id }. Erreur : CONFLICT (pas Draft). Marqué destructif. |
Discovery / lectures
| Tool | Objet | Retourne |
|---|---|---|
workflow_catalog | Lister la palette de types d'étapes — chaque type de node que vous pouvez placer, avec ses pins d'entrée/sortie typés. À utiliser avant l'authoring pour câbler des pins compatibles. category est la famille de taxonomie de la palette (p. ex. Missions/Research/Validation) ; tags est un axe de sous-familles réservé — vide sur chaque node aujourd'hui ; lifecycle vaut Standard ou Legacy (placer un node Legacy dans un nouveau brouillon est bloqué à la publication). | { catalog: [{ nodeTypeId, kind, siteId, category, tags, lifecycle, inputs:[{name,kind,required,defaultValue,variadic}], outputs:[…] }] } |
workflow_list | Lister toutes les versions d'un workflow, les plus récentes d'abord. | { versions: [{ id, workflowId, version, status, checksum, createdBy, createdAt, publishedAt }] } |
workflow_list_all | Lister la dernière version de chaque workflow du tenant. | { workflows: [{ id, workflowId, name, version, status, … }] } |
workflow_get | Une version avec sa charge utile de graphe complète. version=0 (ou omis) = dernière publiée. | { id, workflowId, version, status, checksum, graphJson, tunnelsJson, … } |
workflow_runs | Missions lancées depuis un workflow (ses runs), les plus récentes d'abord ; filtre de version optionnel. | { runs: [{ missionId, title, status, version, createdAt }] } |
workflow_run_nodes | Status par étape d'un run : mappe les tasks de la mission vers les ids de node d'authoring (la vue run-debugger). | { nodes: [{ nodeId, taskDefId, status, resultSummary }] } |
Composition
| Tool | Objet | Retourne |
|---|---|---|
workflow_tile_catalog | Lister les workflows publiés disponibles comme tuiles FlowRef intégrables (y compris les compositions sys- seedées), chacune avec la signature de tunnel contre laquelle vous câblez. À utiliser avant de placer une étape FlowRef. | La liste de tuiles (identité de workflow, version, nom, pins de tunnel) |
workflow_rebind_flowref | Repointer l'étape FlowRef d'un draft vers un autre workflow/version cible (déplacer un consommateur hors d'un ancien sous-workflow). Le rebinding invalide la ratification antérieure des gates — elles doivent être ré-approuvées. | L'enveloppe du draft mis à jour |
workflow_referenced_by | Lister les workflows publiés dont les étapes FlowRef référencent un workflow donné — la garde d'archive : à vérifier avant workflow_archive. | La liste des consommateurs (vide = archivage sûr) |
Execution
workflow_invoke — exécuter une version publiée.
- Entrées :
workflowId,version(doit être ≥ 1 — il n'y a pas de raccourciversion=0ici ; exécuter « la plus récente quelle qu'elle soit » doit être un choix explicite), optionnelsobjective,model,provider,paramsJson(un objet JSON de valeurs de paramètres de run) etprojectId(project cible optionnel dans lequel le coder du run écrit — GUID ou slug ; inconnu → 404, non Active → 409, omis → project par défaut du tenant, consigné dans la provenance commeprojectScope). - Comportement : compile le graphe en une mission dont les tasks portent le câblage des étapes ; chaque étape gate est mise en pause derrière une décision d'approbation en attente (résolue avec
decision_respond:approvelibère la gate une fois les étapes antérieures terminées,skipl'annule,failla fait échouer).model+providersont requis sauf si les valeurs par défaut du tenant les résolvent — il n'y a pas de repli silencieux de modèle. - Retourne :
{ missionId, workflowId, version, checksum, stepCount, gateCount, controlCount }. - Suites :
mission_getpour observer le run ;decision_listpour trouver les approbations de gate en attente ;workflow_run_nodespour le status par étape.
Cloning (sauvegarder un run, ou forker un template)
| Tool | Objet | Retourne |
|---|---|---|
workflow_clone_from_mission | « Sauvegarder ce run comme workflow. » Clone une mission dans un nouveau draft (ne publie jamais). Les missions nées d'un workflow sont re-draftées à l'identique depuis leur source ; les autres missions sont reconstruites à partir de leurs lignes de task, en ajoutant un trigger et (uniquement si nécessaire) une seule gate pour que le résultat soit publiable. | { id, workflowId, version, status, source, notes, suggestedInvoke }. source = workflow-born | organic ; notes liste chaque réparation |
workflow_clone_from_system | Cloner un template de system-workflow de la plateforme dans un nouveau draft éditable détenu par votre tenant. | { id, workflowId, version, status } |
Templates de system-workflow
| Tool | Objet | Retourne |
|---|---|---|
workflow_system_list | Lister les templates de system-workflow en lecture seule de la plateforme (les flux d'orchestration intégrés : cycle de vie de mission, research, onboarding, support, review, …). | { workflows: [{ workflowKey, name, description, category, checksum, isSystemSeed }] } |
workflow_system_get | Un template avec sa charge utile de graphe complète, pour inspecter le flux avant de cloner. | { workflowKey, name, description, category, checksum, graphJson, tunnelsJson } |
Node instructions
Chaque node de workflow peut porter des node instructions — du texte supplémentaire superposé au prompt du node au dispatch. Les instructions vivent dans des slots à portée, avec la précédence run > project > tenant > global (le slot le plus spécifique gagne). Trois outils les gèrent, protégés par la même politique tenant-admin que le reste de la surface :
| Tool | Objet |
|---|---|
workflow_node_instructions_get | Lire les slots d'instructions d'un node à travers les portées. |
workflow_node_instructions_set | Écrire une instruction à une portée. Seuls les slots de source MANUAL sont inscriptibles — un slot détenu par le chemin PromptEngineer renvoie CONFLICT. |
workflow_node_instructions_clear | Retirer un slot d'instruction. Même règle MANUAL-only. |
Aujourd'hui, chaque slot vivant est défini à la main ; le chemin de proposition PromptEngineer (ARDS proposant lui-même des améliorations de prompt) n'est pas actif en v1 — la garde CONFLICT réserve ses slots.
1.4 API REST
Route de base api/v1/workflows (tenant-admin). Reflète la surface MCP pour le composeur du dashboard :
GET /workflows— une ligne par identité de workflow (dernière version).GET /workflows/catalog— la palette de types d'étapes.GET /workflows/{workflowId}/versions— toutes les versions, les plus récentes d'abord.GET /workflows/{workflowId}/{version}— une version avec la charge utile complète.POST /workflows— créer un draft (corps :graphJson, optionnelsworkflowId/tunnelsJson/name).PUT /workflows/{id}— remplacer la charge utile d'un draft.POST /workflows/{workflowId}/rename— définir le nom d'affichage sur toutes les versions.POST /workflows/{id}/materialize·POST /workflows/{id}/waive— overlay de compliance + dérogation.POST /workflows/{id}/publish— valider + figer. Note : une validation menée à terme est toujours un HTTP 200 avec une enveloppe{ success, workflow, problems[] }(success:false+ une liste de problèmes structurés{ nodeId, pin, message, raw }en cas d'échec) — le dashboard mappe tout non-2xx vers « request failed », donc un échec de validation doit rester une enveloppe 200. Les 404/409 restent pour les lignes manquantes/non-draft.POST /workflows/{id}/archive·DELETE /workflows/{id}— archiver (publié) / supprimer (draft).POST /workflows/{workflowId}/{version}/invoke— exécuter.POST /workflows/clone-from-mission— cloner une mission vers un draft.GET/POST /workflows/system[...]— lister/récupérer/cloner les templates système.GET /workflows/{workflowId}/runset/runs/{missionId}/nodesetGET /workflows/runs(fleet) — observabilité des runs (§2.10).
Le CRUD des triggers réside sous api/v1/workflows/{workflowId}/triggers (§2.9) ; la surface de lecture centrée run dispose aussi de api/v1/workflow-runs/{missionId}/graph-status et GET /workflow-runs (runs en cours).
1.5 Pages du dashboard
Le composeur Blazor (Genesis.UI) fournit :
| Route | Page | Ce qu'elle fait |
|---|---|---|
/workflows | WorkflowsDashboard | Lister tous les workflows ; créer, ouvrir, cloner. |
/workflows/{WorkflowId}/{Version} | WorkflowEditorPage | L'éditeur de graphe / canvas : placer des étapes depuis le catalogue, câbler des pins, materialize, waive, publish, rename, gérer les triggers (WorkflowTriggersDialog). |
/workflows/system/{Key} | SystemWorkflowPreviewPage | Prévisualiser un template système avant de cloner. |
/workflows/runs/{MissionId} | WorkflowRunViewerPage | Vue live du run par node (le run debugger), avec WorkflowGateReviewPanel pour résoudre les gates. |
/workflows/active | WorkflowActiveRunsPage | Liste inter-workflows des runs en cours. |
2. Architecture
2.1 Modèle de données
Les workflows persistent à trois endroits. Point crucial : les runs ne sont pas une table de workflow — un run est un Mission + ses lignes TaskDefinition, estampillé avec la provenance du workflow dans Mission.Metadata["workflow"].
workflow_records (tenant DB — WorkflowRecord) : une ligne par (workflowId, version).
| Colonne | Type | Notes |
|---|---|---|
id | guid (PK) | |
workflow_id | varchar(64) | identité logique stable (wf + 10 hex) ; partagée par toutes les versions |
version | int | monotone, base 1 ; index unique (workflow_id, version) |
name | varchar(200) null | nom d'affichage, logique par workflow id, hors du checksum |
status | varchar(50) | Draft / Published / Archived (enum→chaîne) ; indexé |
graph_json | jsonb | la charge utile de l'IR du graphe ; le schéma est versionné à l'intérieur (irVersion) |
tunnels_json | jsonb null | la signature de pins du workflow pour la composition FlowRef |
checksum | varchar(64) | SHA-256 hex en minuscules de graph_json, calculé au publish ; vide tant qu'en Draft |
created_by, created_at, published_at | created_at indexé | |
compliance_catalog_version | int null | la version du catalogue de contrôles épinglée au publish (provenance) |
compliance_waivers | jsonb null | dérogations enregistrées [{controlId, reason, grantedBy, grantedAt}] |
workflow_triggers (tenant DB — WorkflowTrigger) : liaisons de trigger automatiques, non intégrées au graphe (elles survivent donc au re-versioning). Colonnes : id, workflow_id, version_policy (LatestPublished/Pinned), pinned_version, trigger_type (Schedule/Webhook/Event), config_json (jsonb), webhook_secret (write-only), selected_model, selected_provider (les deux requis — invoke n'a pas de repli), objective, params_json, target_project_id, is_active, last_run_at, next_run_at, colonnes d'audit. Indexé (workflow_id, is_active) et (trigger_type, is_active, next_run_at).
system_workflows (control-plane DB — SystemWorkflowRecord) : templates de plateforme exposés en lecture seule à chaque tenant. Colonnes : id, workflow_key (unique), name, description, category, scope (Tenant/Platform), is_system_seed, status, graph_json, tunnels_json, checksum, horodatages. Réconciliés depuis le catalogue de code au démarrage ; les tenants peuvent cloner mais pas éditer.
Le catalogue de contrôles de compliance (lignes workflow_control_catalog, control-plane + tenant) alimente les vérifications materialize/plancher ; il est documenté sous Compliance.
2.2 L'IR du graphe et le modèle node/pin
WorkflowRecord.GraphJson se parse (via WorkflowIrSerializer) en un record WorkflowIr :
WorkflowIr { int IrVersion, IrNode[] Nodes, WorkflowEdge[] Edges, WorkflowParam[]? Params }
WorkflowEdge { PinRef From, PinRef To }   PinRef { string NodeId, string Pin }
Genres de node (IrNodeKind) — 16 genres :
| Genre | Authorable ? | Rôle |
|---|---|---|
Event | oui | Le trigger. Au plus un par graphe ; pas de pins d'entrée ; ses successeurs exec sont les étapes d'entrée. Ne s'abaisse en rien. |
CallSite | oui | Un LLM call site latent issu du catalogue organisé. Classé écriture (il dispatche des coders). |
Read | oui | Une lecture système pure, sans effet de bord. Jamais classée écriture, jamais gatée. |
Action | oui | Une écriture workspace:* exécutée inline (W4). Classée écriture ; s'exécute inline, ne dispatche jamais de coder. |
ServiceAdapter | oui | Une opération de service C# exécutée inline (W5). Classée écriture ; s'exécute inline. |
Gate | oui | Une gate d'approbation humaine. S'abaisse sur le trio Paused / AttentionRequest / DecisionResolution. Porte des decisions[] nommées (arms à libellé humain), des fields[] de capture typés exposés sur le pin data response, et un timeout optionnel résolu en fail ou skip. |
Branch | oui | Routage first-match sur une valeur de sélecteur ; cas ordonnés + un else. Abaissée en étapes Control par cas. |
Loop | oui | Retry-until-acceptance sur un workflow de corps publié (flowId@version). Déroulée en N itérations. |
MapFanOut | oui | Fan-out dynamique : à l'exécution, lit un tableau JSON depuis un résultat amont et crée une task de corps par élément (nombre inconnu au moment de la compilation). Config : sourcePin (le tableau amont), itemVar, un corps qui est soit une seule étape du catalogue (bodyTemplate) soit un sous-workflow (flowRef), maxItems (1..1000), et des dépendances entre éléments frères via itemDependsOnPath (les éléments forment un DAG, pas seulement un lot plat). |
FlowRef | oui | Une étape composite référençant un autre workflow par flowId@version ; inlinée à la compilation. |
ForEach | oui | Fan-out séquentiel : itère un tableau JSON un élément à la fois, dans l'ordre, avec prise en charge de break (une condition de break satisfaite saute les éléments restants). Retire Loop pour le nouvel authoring ; les graphes Loop existants continuent de tourner. |
Wait | oui | Gare le run sur un timer (durationMinutes, 1..40320 — d'une minute à 28 jours) ou sur un event (l'une des six coutures d'événement vivantes — §2.9) ; exactement un des deux modes par node. |
Llm | oui | L'étape LLM générique à tour unique borné : un appel, pas de tools. Son siteId de config doit nommer un site deny-all enregistré (vérifié au publish). |
Agent | oui | L'étape agent générique multi-tour in-process avec un toolset explicite + budget ; le toolset doit être ⊆ de la politique effective du site. Bi-classe : classée lecture ou écriture selon son toolset (tout tool d'écriture ⇒ classée écriture, dominée par une gate). Disponible mais récent — aucun flux intégré ne l'utilise encore. |
Finally | oui | Une région de nettoyage qui s'exécute exactement une fois, que la région gardée réussisse, échoue ou soit annulée. |
Control | non | Routage synthétisé par le compilateur (cas de branche, continue/exit de boucle, arm de skip de gate, arms de décision, arms d'outcome, materializer/join de map). Son authoring est rejeté. |
Un LLM site latent qui déclenche exactement un outcome terminal (onSuccess/onFailure/onRefusal) est un call site asynchrone ; son descripteur expose des pins d'outcome au lieu d'un unique out, et le runtime déclenche exactement un arm (OutcomeRole).
Pins (PinKind) : Exec (séquencement seul, ne transporte jamais de données, ne s'élargit jamais), Context, Document, Artifact, Json (peut porter un raffinement JSON-Schema), String, Number, Bool. Le câblage est légal lorsque les genres correspondent (plus les élargissements scalaire→Json) ; lorsque les deux côtés d'un edge Json déclarent un schéma, la compatibilité de sous-ensemble structurel est imposée au publish. Un PinDescriptor porte Name, Schema (genre + schéma optionnel), Required, une DefaultValue optionnelle réservée à l'éditeur et Variadic (un pin data qui accepte >1 edge entrant — un fan-in N-vers-1 collecté en tableau à l'exécution).
Params (WorkflowParam { Name, JsonSchema?, Required, default? }) : paramètres d'invocation au niveau du graphe. Les valeurs passées à workflow_invoke(paramsJson) sont résolues à la compilation en littéraux des pins liés — il n'y a pas de plomberie de paramètre à l'exécution. Un param lié à un pin requis doit lui-même être requis ou porter une valeur par défaut (vérifié au publish), de sorte qu'un workflow publié ne peut jamais se compiler en une task à laquelle manquerait une entrée requise.
Note de vocabulaire / format de fil : l'IR persiste le track d'un node sous un nom de champ hérité, maintenu stable pour que les checksums publiés restent octet-identiques. Dans toute la prose, l'UI et l'outillage, ce champ est le Track de l'étape (Governance / Research / Planning / Build) ; le compilateur lui donne par défaut la valeur Build.
2.3 Le catalogue d'étapes (palette)
WorkflowNodeCatalog.All est la palette organisée et définie en code de 128 types d'étapes (recensement vivant épinglé). Chaque entrée est un WorkflowNodeDescriptor { NodeTypeId, Kind (LlmSite/ReadAdapter/ActionAdapter/ServiceAdapter), SiteId, Inputs[], Outputs[], Outcomes?, ConfigFields? }. Le descripteur attache des pins typés à côté du registre de call-site existant — il ne modifie jamais LlmCallSite dans Genesis.Contracts ; un site non annoté n'est simplement pas éligible à la palette. Entrées représentatives :
- LLM call sites :
Missions:Decomposition,Coder:Default(sync) etCoder:AsyncDefault(arms d'outcome),ReviewEngine:Default. Chaque LLM site porte aussi deux pins optionnels de ghost-evaluation (ghostEval,ghostEvalModel). Les sites Coder exposent desConfigFields(Task Type, Track, Coder Variant, id de Preset épinglé) que le panneau Properties affiche et que le compilateur/validateur lisent. - Read adapters (purs, jamais gatés) :
read:mission_get,read:gitlab_get_file,read:intelligence_knowledge_query,read:loki_query_range,read:task-deps:resolve,read:boundary:validate,read:task-routing:route,workspace:read_file,workspace:list_files. - Action adapters (écritures workspace inline, dominées par une gate) :
workspace:write_file,workspace:create. - Service adapters (opérations C# inline, dominées par une gate) :
workspace:merge,service:decomposition:propose, la familleservice:research:*(investigate-codebase/docs/web, synthesize, critique, llm), lesservice:review-engine:*,service:ux-review:*,service:canary:*,service:improvement:*,service:support:*,service:onboarding:*,service:aspect-onboarding:*,service:validation-runs:*,service:batch-processing:*,service:satisfaction:score,service:git-push:default, et les évaluateursservice:compliance:*(SCA, clause-map, complétude ROI, ponctualité d'incident, et les familles CRA / PLD).
Les schémas de result des read adapters proviennent des fichiers DTO d'adaptateur (source unique de vérité). La librairie Genesis.Missions reste libre de la dépendance Contracts — le validateur de publish Genesis.Core recroise chaque SiteId contre le LlmSiteRegistry vivant.
Le recensement par famille de taxonomie (17 familles) : ComplianceChecks 24 · Validation 20 · Missions 11 · Scaffolding 9 · Onboarding 9 · Support 8 · Review 7 · Improvement 7 · Workspace 6 · Research 6 · Incidents 5 · Agents 4 · Git 3 · Knowledge 3 · ComplianceAssess 3 · Communication 2 · Legacy 1. Par genre de descripteur : ServiceAdapter 102, ReadAdapter 18, LlmSite 4, ActionAdapter 2 (workspace:write_file, workspace:create), plus les entrées génériques Llm et Agent (une chacune). Exactement un node est Legacy — service:research:llm, supplanté par le node llm générique et bloqué à la publication dans les nouveaux drafts.
Conventions à l'échelle du catalogue : chaque node suit l'épine Exec (in/out) — la seule exception est Coder:AsyncDefault, l'unique node multi-arm, dont les sorties exec sont ses arms d'outcome ; 122 des 128 émettent une sortie result:Json requise ; les six brain nodes (Missions:Decomposition, Coder:Default, Coder:AsyncDefault, ReviewEngine:Default, llm, agent) sont les seuls à porter le pin context:Context, et les quatre LLM sites câblés parmi eux (Missions:Decomposition, Coder:Default, Coder:AsyncDefault, ReviewEngine:Default) sont ceux où la paire de pins ghost-evaluation (ghostEval/ghostEvalModel) est vivante ; les familles de fan-out suivent une triade prepare → per-item → reduce (la première entrée du node de corps per-item est item:Json, requise) ; et quelques nodes émettent des handles typés à côté de — ou à la place de — result : runId (service:compliance-assess:prepare), incidentId (service:incident:create), leaseId (service:run-target:lease), workspace (workspace:create/workspace:merge).
2.4 Authoring et l'overlay de compliance (materialize)
materialize (ComplianceOverlayService.MaterializeDraftAsync) s'exécute avant le publish pour que l'opérateur examine les contrôles injectés sur le canvas. Il :
- Parse l'IR du draft.
- Lit le plancher — le catalogue de contrôles actif (
IWorkflowControlCatalog.GetActiveAsync) — plus les augmentations de gouvernance additives uniquement (IOverlayGovernanceAugmenter; par défaut ne lit rien, la couture permet à un project d'ajouter des contrôles, jamais de retirer un contrôle du plancher — la conception à cliquet). - Exécute le
ComplianceOverlayMaterializerdéterministe, qui injecte les nodes human-gate et regulatory-review/service:compliance:*requis en s'appuyant sur les stades de développement dont les nodes du graphe sont taggés (Design/Implementation/Integration/Verification/PreDeployment), plus les contrôles de base toujours requis. Les nodes injectés portent une provenance d'overlay ({ controlId, catalogVersion }). - Idempotent : si le JSON canonique est inchangé, il renvoie le draft intact (pas de churn de checksum). Sinon il persiste la forme de fil compatible-parse draft→draft.
waive_control ajoute une dérogation auditée { controlId, reason, grantedBy, grantedAt } au draft pour que le plancher de publish considère ce contrôle comme satisfait — sauf si le contrôle est non-waivable, auquel cas la présence d'une dérogation est elle-même une violation de publish.
2.5 Publish et validation
IWorkflowRepository.PublishAsync exécute un unique IWorkflowPublishValidator injecté — un CompositeWorkflowPublishValidator qui exécute chaque validateur enregistré et agrège tous les problèmes (pas de court-circuit), de sorte que les problèmes structurels, de registre et de plancher de compliance surgissent ensemble. Les trois validateurs :
- Structurel —
WorkflowIrValidator(pur ; pas de DB/registre). Il s'exécute comme le fera le compilateur : expansion FlowRef →Validate(Authored)→ expansion contrôle-de-flux →Validate(Final). Il vérifie : ids bien formés (uniques, pas de segments réservés__/#), au plus un Event, modèles de pins par genre, compatibilité genre/schéma des edges, edge-unique-par-pin-data (assoupli pour variadic), connectivité des pins requis, règles de liaison littéral/param, configuration de branche/boucle/fan-out, isolation de reconvergence des arms de branche et d'outcome, acyclicité (avec un chemin de cycle explicite) et — la pierre angulaire — la dominance de gate. - Registre —
LlmSiteRegistryWorkflowPublishValidator(Genesis.Core) : ré-exécute la chaîne structurelle sur le graphe expansé FlowRef, recroise leSiteIdde chaque call site contreLlmSiteRegistry.GetAll(), valide la signature de tunnel du draft (noms/genres/liaisons), et valide que tout id de LLM preset épinglé à un node est connu et éligible. - Plancher de compliance —
ComplianceFloorPublishValidator(Genesis.Core, fail-closed). Un graphe est gouverné ssi un node porte un tagstageou un node injecté par overlay. Les graphes non gouvernés se publient inchangés. Pour un graphe gouverné : chaque node classé écriture doit porter un stage ; un contrôle requis n'est satisfait que par un node correspondant à son control id et à son genre de node ; un contrôle manquant ne passe qu'avec une dérogation explicite (et seulement si le contrôle est waivable). En cas de succès, il épingle la version de catalogue active sur le record.
Dominance de gate. Le wave executor n'exécute une task que lorsque toutes ses dépendances sont terminées. Ainsi une étape classée écriture (
CallSite/Action/ServiceAdapter) est bloquée en exécution par une gate ssi un nodeGateest un ancêtre dans le graphe de dépendances de l'union (exec + data). Le validateur impose exactement cela : chaque chemin de dépendance vers une écriture doit traverser une Gate. Les étapesReadne sont jamais classées écriture ni gatées. La seule exemption est une vérificationservice:compliance:*injectée par overlay — c'est le mécanisme de protection (délibérément placé avant la gate de stage pour qu'une vérification échouée annule en cascade la gate→push), pas une écriture d'auteur.
L'échec de publish est signalé comme VALIDATION_ERROR en MCP et comme une enveloppe 200 { success:false, problems:[…] } en REST ; le contrôleur parse chaque message de validateur en un { nodeId, pin, message, raw } structuré pour la mise en évidence sur le canvas.
2.6 Invocation : compiler un graphe en une mission
WorkflowInvocationService.InvokeAsync est compile-first pour qu'un graphe qui ne compile plus (ex. un sous-flux référencé a été dépublié) ne laisse jamais une mission orpheline :
- Chargement + intégrité. Récupérer
(workflowId, version); exigerPublished; recalculer le SHA-256 degraph_jsonet refuser s'il ne correspond pas auchecksumstocké. - Compilation (pure). Parser l'IR, construire un
FlowResolver(résout les sous-flux FlowRef ; seules les versions Published se résolvent), générer unseedfrais par invocation, parserparamsJson, et exécuterWorkflowCompiler.Compile. Le compilateur est pur et déterministe — pas de DB, pas d'horloge, pas de GUID frais ; même graphe + même seed → jeu de tasks octet-identique. Il :- Expanse FlowRef, valide (Authored), expanse le contrôle de flux (Branch/Loop/MapFanOut → nodes
Control), valide (Final), puis applique les params en littéraux. - Assigne des
TaskDefIds déterministes (DeterministicIdGenerator.TaskDefId(seed, nodeId)), calcule les vagues topologiques de Kahn (l'ExecutionOrder), et abaisse chaque node en unCompiledTaskportantTaskType,Track,CoderVariant,DependsOn, status, tools autorisés, critères d'acceptation, un porteurworkflow(le JSON décrivant node id/kind/site/inputBindings/outputSchema/config de contrôle, utilisé au dispatch) et — pour les gates — unCompiledGate. - Abaissement par genre : Gate →
gate/Paused ;Control→workflow-control/Paused ;Read→analyze/Pending ;Action→workflow-action/Pending ;ServiceAdapter→workflow-service/Pending ;CallSite→code(ou configuré)/Pending. Une garde de défense-en-profondeur lève une erreur contre une ligne non-gate portant les task types réservésgate/workflow-control/workflow-service(qui s'auto-approuveraient ou se mal-routeraient).
- Expanse FlowRef, valide (Authored), expanse le contrôle de flux (Branch/Loop/MapFanOut → nodes
- Résoudre le project cible optionnel (fail-loud avant la création de la mission ; une cible omise est journalisée et consignée comme
projectScope=tenant-default). - Dériver model/provider pour un invoke UI en un clic depuis le preset épinglé d'un node coder (résolu via le même dispatch de site
Coder:Default) — additif et appliqué uniquement lorsque model/provider de l'appelant sont vides, de sorte qu'un model/provider fourni par l'appelant est un no-op ici. - Créer la mission avec
Metadata.skipDecomposition=trueet un blob de provenanceworkflow(workflowId,version,irChecksum,invocationSeed,paramsJson,targetProjectId,projectScope). Model/provider sont transmis àCreateMissionAsync, qui échoue bruyamment quand les deux sont vides. - Matérialiser les tasks en une seule sauvegarde (le pattern ProposalMaterializer) avec des
TaskDefIds pré-définis et un status par task. Les lignes gate et control reçoiventMaxRetries=0(une gate rejetée doit rester rejetée ; une loop-exit résolue en échec doit rester en échec — l'auto-retry les ressusciterait sinon en « approuvées »). - Mettre en file une demande d'approbation par gate via la file de décisions (
IDecisionQueueService), portant les arms de décision / champs typés de la gate dans les metadata de l'AttentionRequest, plus une deadline optionnelle + action de timeout. Si quoi que ce soit échoue en cours de matérialisation, la mission est compensée àFailed(un run à moitié matérialisé avec une gate non-débloquable ne doit jamais se garer silencieusement).
Le résultat est { missionId, workflowId, version, checksum, stepCount, gateCount, controlCount } (les lignes control synthétisées par le compilateur sont exclues de stepCount et exposées séparément).
2.7 Exécution runtime d'un run
Un run s'exécute sur le moteur de mission existant (ArdsMissionOrchestrator) — les workflows n'ajoutent aucun nouveau runtime. Parce que la mission est créée skipDecomposition=true, l'orchestrateur ne la décompose jamais automatiquement ; il dispatche les tasks pré-matérialisées par vague. Pour les missions à provenance workflow, chaque tick de l'orchestrateur exécute une passe de contrôle déterministe (IWorkflowControlService.EvaluateAsync) avant les boucles de dispatch Ready et de promotion Pending→Ready :
- Elle lit le porteur résolu de chaque task
workflow-controlet la liste de tasks en mémoire, et s'exécute jusqu'à un point fixe (plafonné par une garde), ne faisant jamais que transitionner les status de tasks déjà matérialisées — elle ne crée jamais de task (sauf le materializer MapFanOut, qui ajoute des tasks de corps de manière idempotente). Les routeurs :RouteBranches,RouteLoopContinues,RouteLoopExits,RouteGateSkipArms,RouteGateDecisionArms,RouteOutcomeArms,RouteMapFanOut,RouteMapJoins, etCascadeSkip(annulation de région morte, marquéeworkflow-cascadepour la distinguer d'un skip opérateur). - Les conditions privilégient une expression booléenne RulesEngine rédigée quand elle est présente, sinon reviennent à une égalité scalaire chemin-pointé-plus-attendu — de sorte que chaque graphe pré-expression se comporte de manière octet-identique.
Exécution des étapes par genre :
- Gate — née
Pausedavec une AttentionRequest ouverte. L'opérateur la résout viadecision_respond/decision_create:approvelibère les dépendants une fois les étapes antérieures terminées (la pré-approbation est autorisée) ;skipannule la région gatée ;failla fait échouer. Les gates à N arms routent sur le pin de décision (jamais le libellé d'affichage) ; les champs de gate typés sont capturés sur leResultSummaryde la gate et exposés via un pin dataresponse. - Read / Action / ServiceAdapter — s'exécutent inline dans le poller de dispatch (ne dispatchent jamais de coder) : l'orchestrateur résout l'
IWorkflowReadAdapterExecutor/IWorkflowActionExecutor/IWorkflowServiceAdapterExecutorcorrespondant, passe lesinputBindingsrésolus du porteur (littéraux, références de sortie amont, et liaisons de motif de nom au moment du dispatch viaWorkflowReadInputResolver), et réécrit le résultat. Les lignes Action/ServiceAdapter sont gardées : une ligne atteignant le dispatch sans provenance de porteur du compilateur est mise en échec plutôt qu'exécutée. - CallSite — matérialisée en une coding task et dispatchée à un coder comme d'habitude ; le preset épinglé du node du porteur pilote le routage de provider, et un async call site doit émettre une ligne finale
{"outcome":…}parsable (le consommateur de résultat échoue+retente un résultat qui n'en déclare aucun).
2.8 Workflows système vs tenant
La plateforme livre 22 templates de system-workflow qui représentent les flux d'orchestration codés en dur sous forme de graphes composables, définis en code (SystemWorkflowCatalog) et réconciliés dans la table control-plane system_workflows au démarrage. La ventilation par catégorie : Mission ×6 (sys-mission-lifecycle, sys-research-mission, sys-decompose-direct, sys-mission-decompose-grounded, sys-decompose-research, sys-task-dispatch), Onboarding ×4 (sys-first-run-onboarding, sys-aspect-onboarding, sys-intelligence-scaffolding, sys-project-onboarding), Ops ×3 (sys-batch-processing, sys-canary, sys-run-acceptance), Compliance ×2 (sys-compliance-assess, sys-incident-pipeline), Review ×2 (sys-review-engine, sys-ux-review), Validation ×2 (sys-llm-preset-validation, sys-validation-runs), Evaluation ×1 (sys-satisfaction-scoring), Improvement ×1 (sys-improvement-cycle), Support ×1 (sys-support-case-triage). Ceux-ci exercent les constructions réelles — ex. sys-mission-lifecycle est un MapFanOut piloté par le moteur (un coder par task proposée, nombre inconnu jusqu'à l'exécution de la décomposition) ; sys-research-mission fait tourner 3 investigateurs parallèles (un diamant) qui convergent dans une boucle de révision bornée synthesize→critique (max 3 passes, rompue dès que le critic approuve).
Les lignes système sont en lecture seule pour les tenants (ISystemWorkflowStore) : les tenants peuvent lister/récupérer et cloner dans un draft détenu par le tenant (workflow_clone_from_system → identité fraîche, graphe à l'identique), puis éditer/publier/invoquer librement. Les templates Scope="Platform" sont masqués des surfaces tenant.
Deux catalogues, deux vocations. SystemWorkflowCatalog contient les 22 templates représentationnels ci-dessus — des clonables en lecture seule : cloner l'un d'eux vous donne le graphe comme draft tenant éditable, pas un branchement dans le flux codé en dur de la plateforme. Séparément, SysWorkflowInventory seede 19 compositions sys- exécutables, publiées par tenant comme de vraies versions de workflow et exposées comme tuiles FlowRef pour l'intégration (ex. sys-research-codebase, sys-decompose-propose) ; la plupart sont seed-only aujourd'hui — les call sites legacy qu'elles reflètent n'ont pas encore été re-pointés dessus. L'énumération complète des templates réside dans la documentation utilisateur : the templates page.
Une capacité connexe, la décomposition-comme-workflow (MaterializeDecompositionWorkflowAsync), matérialise un template système decompose (sys-decompose-direct / sys-decompose-research) directement sur une mission existante et résout automatiquement la simple gate initiale via le chemin de décision vivant — la couture flag-gated qui remplace l'invocateur de phase inline pour les missions opt-in.
2.9 Triggers (invocation automatique)
Un WorkflowTrigger lie un workflow publié (par workflowId stable + une politique de version : LatestPublished ou Pinned) à une source automatique. Chaque source aboutit au même appel — résoudre la version publiée et InvokeAsync — ne différant que par la façon dont « déclencher maintenant » est détecté :
- Schedule —
WorkflowTriggerScheduler(unBackgroundService, boucle d'environ 1 minute avec un délai de démarrage) balaie le registre des tenants et déclenche les lignes dont leNextRunAtest échu, puis avanceNextRunAtvia le parseur cron partagé. Politique de fenêtre manquée : déclencher une fois et recalculer vers l'avant (jamais rattraper N occurrences) ;NextRunAtest la garde d'idempotence. - Webhook — un événement GitLab entrant vérifié contre le
webhook_secretpar trigger (temps constant, jamais journalisé), filtré pareventType+ unfilterJson. - Event —
WorkflowTriggerDispatcherrecherche les triggers Event actifs pour un événement de domaine in-process (les six coutures vivantes :mission.created,conversation.completed,support-case.created,incident.created,batch.completed,mr.merged), évalue lematchJsonde chaque trigger (filtres projectId / mots-clés) contre le contexte de l'événement, et invoque les correspondances. Un ensemble borné(trigger, eventId)donne une livraison at-most-once par processus ; une garde de boucle saute entièrement le dispatch quand le contexte portetriggerSpawned:true, de sorte qu'une mission engendrée par un trigger ne peut re-déclenchermission.created.
Les triggers sont validés fail-loud à la création (le workflow doit avoir une version publiée ; selectedModel + selectedProvider sont obligatoires car invoke n'a pas de repli ; un cron Schedule doit parser ; un Webhook a besoin d'un secret + eventType). Le déclenchement ne contourne ni n'auto-approuve jamais une gate — la discipline fail-closed est préservée. Les triggers ne sont pas intégrés au graphe, ils survivent donc au re-versioning.
2.10 Observabilité des runs
Parce qu'un run est une mission, l'observabilité est une projection sur ses tasks plutôt qu'un store dédié. WorkflowRunsReader lit la provenance Mission.Metadata["workflow"] et mappe chaque TaskDefinition vers son node id d'authoring via le porteur (partagé par MCP et REST pour qu'ils ne divergent pas). Au-delà de la forme brute workflow_run_nodes, les services de lecture projettent chaque node vers un NodeRunState — les huit valeurs TaskDefinitionStatus plus un AwaitingGate dérivé (une task Paused qui a une AttentionRequest ouverte et non résolue). Les surfaces :
GET /workflows/{workflowId}/runs/{missionId}/nodes— états projetés par node, filtrables parstate/nodeType/gateLabel.GET /workflows/runs— vue fleet : runs inter-workflows avec un rollupNodeRunStatepar run, provenant duGetMissionsAsyncF003-safe, filtrable par la grammaireRunFilterpartagée (template/missionId/fenêtre-temps/providerModel au niveau run ; state/nodeType/gateLabel au niveau node).GET /workflow-runs/{missionId}/graph-statusetGET /workflow-runs— la surface FE centrée run (status par node + runs en cours). La forme du graphe elle-même est récupérée via l'API de version existante en utilisant leworkflowId+versionretournés — elle n'est délibérément pas dupliquée ici.
(Les tasks de corps de fan-out sont incomplètes au grain node dans la lecture par run jusqu'à ce que le porteur de corps porte les champs de provenance ; le rollup fleet compte toutes les lignes de task réelles.)
2.11 Clone-from-mission
WorkflowCloneService.CloneFromMissionAsync transforme un run en draft via deux chemins choisis selon ce que porte la mission :
- Workflow-born — la mission épingle la provenance
workflowId@versionet leWorkflowRecordsource existe encore : sonGraphJsonest re-drafté à l'identique sousTargetWorkflowId ?? sourceWorkflowId(une dérive de checksum n'ajoute qu'une note). - Organic — pas de provenance utilisable (une mission construite à la main/décomposée, ou une dont le record source a été supprimé) :
MissionGraphReconstructorreconstruit un graphe à partir des lignes de task de la mission, en ajoutant un trigger et — seulement si nécessaire — une seule gate d'approbation pour que le résultat soit publiable, signalant chaque réparation dans les notes.
Il ne publie jamais (aboutit toujours à un Draft que l'auteur examine) et expose l'objective + model/provider de la mission comme indices de run seulement — aucun paramètre au niveau des pins n'est extrait.
2.12 Relation avec les missions et les agents
- Les missions sont le substrat. Un workflow publié se compile de manière déterministe en le jeu de
TaskDefinitiond'une mission ; le run s'exécute sur le wave executor, la file de décisions et les balayages d'orchestrateur existants. Les workflows ajoutent la couche authoring/versioning/compliance ; les missions ne réinjectent rien dans le graphe. - Les gates réutilisent le système de décision. Une gate n'est pas une nouvelle entité — c'est une ligne AttentionRequest + task
Paused+ missionPendingOperatorDecision, résolue par les mêmes outilsdecision_*que les agents et les opérateurs utilisent déjà. - Les agents sont les exécuteurs. Les étapes
CallSitedispatchent des coders/agents exactement comme les tasks de mission décomposées, honorant les LLM presets par node via le même routage de provider ; les étapes read/action/service s'exécutent inline contre les mêmes services. Un workflow est donc une manière gouvernée, réutilisable et gate-enforced d'orchestrer la même fleet d'agents que les missions ad-hoc utilisent — avec la provenance (workflowId@version+ checksum) épinglée sur chaque run comme artefact de compliance.
2.13 Mission runs et changements (la couche d'acceptation)
workflow_invoke crée une nouvelle mission (§2.6). Une version publiée peut aussi être exécutée à l'intérieur d'une mission existante comme une unité discrète et acceptable — un MissionRun — via mission_run_start (protégé par le flag Workflows:MissionRuns:StartEnabled ; activé sur les déploiements actuels). Il réutilise le même pipeline compile-first, mais le run naît sur sa propre branche git issue du tip de la mission (strict-sequential : le base SHA du run doit toujours égaler le tip), et chaque task matérialisée est estampillée avec l'id/la branche du run.
mission_run_accept boucle la boucle et constitue l'unité d'acceptation :
- Revérifier que la base du run égale toujours le tip de la mission (sinon un
StaleRefused— relancer depuis le tip courant). - Exécuter le plancher de validation physique non-waivable contre la branche du run. C'est fail-closed : sans backend d'exécution vivant pour valider, l'accept est refusé (
ValidationRefused), jamais passé sans validation. - Merger la branche du run sur le tip de la mission et enregistrer le résultat comme un Changement — une unité réversible portant un ordinal, ses fichiers touchés et ses dépendances envers les changements antérieurs (dérivées par recouvrement de fichiers). Le tip accepté est scellé, de sorte que le tip de la mission reste toujours vert.
mission_changement_stack liste la pile dans l'ordre ordinal. mission_revert_preview + mission_revert annulent un changement ainsi que la fermeture transitive de tout ce qui en dépend, dans l'ordre inverse, chacun comme un merge-revert — fail-closed en cas de conflit (un conflit avorte proprement la cascade et nomme le membre en échec). mission_run_discard abandonne un run non accepté (le marque rejected, supprime sa branche) sans toucher à la pile ; un run de compétition se résout en exactement un gagnant (les frères sont rejetés, leurs branches supprimées). C'est ainsi que la sortie d'un workflow devient examinable, acceptable et réversible sur la mission dans laquelle il s'exécute.
mission_run_start accepte un groupId optionnel. Omettez-le et les runs sont strict-sequential : un second démarrage alors qu'un run est encore ouvert est refusé (RunAlreadyOpen) — acceptez ou écartez d'abord le run ouvert. Passez le même groupId à N démarrages et les runs concourent depuis le même base SHA : exactement un peut être accepté ; les frères sont rejetés et leurs branches supprimées (GroupAlreadyWon pour un accept tardif). mission_run_get retourne le roll-up par node plus les ancres d'acceptation — le changement, le seal de validation physique (SHA du tip + verdict) et isAnchored, vrai ssi le run est Accepted et son changement appliqué et son seal passé.
Les deux vocabulaires de status, verbatim. mission_run_start retourne l'un de 11 statuts : Started · FeatureDisabled · AgenticMissionUnsupported · MissionTerminal · MissionNotPlanned · ChildSpawnerDisallowed · RunAlreadyOpen · TipUnavailable · WorkflowNotFound · NotInvocable · MaterializationFailed. mission_run_accept retourne l'un de 7 : Accepted · StaleRefused · MergeConflict · GroupAlreadyWon · ValidationRefused · NotProposed · TipUnavailable.
Agents
Public visé : opérateurs Genesis comme agents Genesis. Cette page documente le sous-système des agents de bout en bout — ce que sont les agents et comment vous les pilotez (surface opérateur), puis comment fonctionnent réellement les rouages internes du dispatch, de l'ordonnancement, du budget et des appels LLM (architecture). C'est une page dense ; survolez la moitié opérateur, lisez la moitié architecture quand vous avez besoin de raisonner sur le comportement.
1. Ce qu'est un agent
Dans Genesis, un agent est un travailleur autonome à longue durée de vie qui exécute une boucle plan-puis-agit (plan-then-act) à sa propre cadence. Contrairement à un appel LLM unique, un agent :
- persiste sous forme de ligne (
agent_instances) dans la base de données de son tenant, avec un statut de cycle de vie, un mode opératoire actif et un état d'ordonnancement à auto-cadence ; - se réveille sur planification (un « tick » de battement de cœur, heartbeat) et sur événements externes (un message opérateur, une question répondue, un changement d'état de mission) ;
- raisonne une fois par tick via un unique appel LLM à provenance enregistrée, puis entreprend des actions typées (proposer une mission, escalader une décision, envoyer un message à l'opérateur) strictement par appels d'outils gouvernés ;
- se souvient de ses propres tours passés (un registre d'état en ajout-seul) et les ré-injecte comme contexte de continuité ;
- n'auto-applique jamais quoi que ce soit de risqué — chaque action conséquente est soit soumise à la gouvernance (governance-gated), soit routée vers un humain via la file de décisions.
Deux grandes familles partagent l'essentiel de cette mécanique :
- Agents permanents (standing) — cerveaux toujours actifs, à portée de tenant, qui exécutent une boucle plan-puis-agit continue : le Strategic Orchestration Agent (SOA) et le Compliance agent. Ce sont eux qui font l'objet de cette page.
- Agents ponctuels / liés (bursty / bound) — des agents qui existent pour accomplir un travail fini puis se taisent : le Prompt Engineer (une salve par retravail de call-site) et les mission agents (un cycle de vie de mission chacun).
Distinct des deux, le léger registre d'agents en mémoire (in-memory agent registry) — un annuaire de coordination des agents externes/travailleurs (coders, reviewers, monitors) utilisé pour le routage de tâches par capacité. Le même mot « agent » recouvre à la fois les cerveaux permanents lourds et les entrées du registre ; les sections ci-dessous les gardent distincts.
2. Surface opérateur
2.1 Types d'agents
Il existe deux systèmes de types complémentaires.
(a) Le discriminant persisté AgentType — le type faisant autorité d'une ligne agent_instances. Il sélectionne la politique de l'agent, son preset/site de planification, son catalogue de modes opératoires, et (pour les missions) la pompe de cycle de vie.
AgentType | Nom produit | Famille | Rôle |
|---|---|---|---|
Soa (par défaut) | Strategic Orchestration Agent | Permanent, natif | Orchestration de tenant à long horizon — passe en revue la santé du tenant + de la plateforme, propose des missions stratégiques bien cadrées, escalade les vrais embranchements vers l'opérateur. |
Compliance | Compliance agent | Permanent, natif | Cerveau réglementaire/conformité permanent — balaie la posture, recherche les cadres réglementaires de l'UE (CRA, DORA, NIS2, EU AI Act, PLD), rédige des dossiers réglementaires en double forme, escalade les décisions de conformité. N'auto-applique jamais (aucun outil de création de mission). |
PromptRedactor | Prompt Engineer | Ponctuel, lié | Retravaille les couches de prompt engagées pour un couple modèle+provider unique à un call-site unique et propose le résultat pour approbation humaine (MR seulement ; ne s'auto-approuve jamais). Le nom du membre d'enum / la chaîne en base reste PromptRedactor en tant que contrat wire/DB ; les types C# et l'UI ont été renommés en Prompt Engineer. |
MissionFeature | Mission de fonctionnalité | Mission | Mission générique productrice de code (le pipeline decompose→code→review). |
MissionTenantBootstrap | Onboarding au premier lancement | Mission | Onboarding de tenant au premier lancement. |
MissionProjectBootstrap | Onboarding de nouveau projet | Mission | Onboarding de nouveau projet pour utilisateur récurrent. |
MissionResearch | Mission de recherche | Mission | Investigation en lecture seule. |
MissionReview | Mission de review | Mission | Analyse par le review-engine. |
MissionAspectOnboarding | Onboarding d'aspect | Mission | Onboarding guidé par projet. |
MissionBugInvestigation | Investigation de bug | Mission | Investigation de support-case. |
MissionBugFix | Correction de bug | Mission | Correction de support-case. |
Les membres Mission* reflètent le « kind » de mission un pour un. Une mission « s'exécute en tant que type d'agent » uniquement à la couture politique + invocation LLM — son cycle de vie reste piloté par la pompe de mission distincte sur les tables missions / mission_event_queue. Les agents permanents natifs (Soa, Compliance, PromptRedactor) s'exécutent directement sur agent_instances / agent_event_queue.
(b) Le rôle dans le registre en mémoire — un annuaire plus léger pour la coordination et le routage. Quand vous appelez agent_register, vous fournissez un role libre (Developer, Reviewer, Coordinator, Monitor ou Generic) plus des capacités. Ces agents de registre sont la façon dont les coders et autres travailleurs se déclarent afin que des tâches puissent leur être routées par capacité. Les entrées du registre sont éphémères (en-processus, partitionnées par tenant, expirées par heartbeat après 5 minutes) ; les lignes agent_instances sont durables.
2.2 Enregistrement & découverte (le registre de coordination)
Ces outils MCP gèrent le registre en mémoire (ils font proxy du contrôleur /api/v1/agents de Core) :
| Outil | Fonction |
|---|---|
agent_register | Enregistrer un agent : name, role, capabilities séparées par virgules, endpoint optionnel, lifecycleKind (manual/docker/process/aspire), transportKind (in-memory/rabbitmq/http), transportTarget, containerId, labels JSON. |
agent_list | Lister les agents enregistrés, filtrables par role / capacité / statut / lifecycle / transport. |
agent_list_available | Lister uniquement les agents actifs (heartbeat dans les 5 dernières min, non hors-ligne) actuellement libres pour affectation. |
agent_discover | Découverte scorée par capacité — classe par compétence, langage et correspondance de framework (minProficiency 1–5). Le point d'entrée du routage intelligent. |
agent_heartbeat | Maintenir un agent en vie (réinitialise le minuteur hors-ligne de 5 minutes). |
agent_deregister | Retirer un agent du registre. |
agent_route_task | Router une tâche vers le meilleur agent par correspondance de capacité (capability/language/framework/priority) et la dispatcher sur son transport, ou forcer un targetAgentId. |
agent_message_queue_depth | Inspecter le nombre de messages en attente d'un agent. |
message_send / message_receive | Messagerie point-à-point ou diffusion (*) entre agents du registre. |
task_assign / task_status | Créer/affecter une tâche à un agent du registre et interroger le statut de la tâche. |
Le SOA permanent s'enregistre ici automatiquement (role/type orchestration) afin d'apparaître sur le tableau de bord /agents et de pouvoir recevoir les push de tours en direct ; cet enregistrement est une commodité d'affichage UI, pas le control-plane du SOA.
2.3 Lancer et piloter des coders
Les coders sont des travailleurs de codage conteneurisés. Deux couches :
Coders à la demande (OnDemandCoderMcpTools, tenant-admin, proxy /api/v1/coders/on-demand) :
| Outil | Fonction |
|---|---|
coder_spawn | Mettre en place un coder pour votre tenant : tool (p. ex. claude, copilot — doit être activé au niveau du fleet), variant (par défaut standard), projectId optionnel (affichage/intention seulement), sessionId pour reprendre une session antérieure (--resume), idleTtlMinutes (par défaut 60). Il survit au scale-to-zero par inactivité de file et s'auto-tue après le TTL d'inactivité. |
coder_list | Lister les coders à la demande de votre tenant (name, tool, variant, state, TTL d'inactivité, id de session de reprise, project). |
coder_kill | Tuer un coder par nom de conteneur (votre tenant uniquement). |
Coding tasks (CodingTaskMcpTools, tenant-admin) — l'unité de travail réelle qu'un coder exécute :
| Outil | Fonction |
|---|---|
coding_task_dispatch | Mettre en file une coding task : taskType (code/test/review/refactor), prompt, context optionnel, targetPath, branch, maxTurns (par défaut 100, max 1000), enableBrowserMcp/enableEmulatorMcp/enableWindowsMcp (attacher un pool de ressources à la tâche ; false par défaut), coderVariant (saveur d'image standard/ide — browser/android sont retirés, utilisez les flags de pool), coderTool (claude/copilot/codex/gemini/aider/octofriend/custom), model/provider/backend ou un presetId, et conversationId+attachmentIds optionnels pour livrer les fichiers uploadés en chat dans le workspace du coder. Asynchrone — interrogez le statut. |
coding_task_status | Vérifier une tâche ; renvoie le résultat une fois terminée. |
coding_task_list | Lister les tâches en attente + récemment terminées. |
coding_task_extend | Reprendre une tâche ayant enregistré une session de coder avec des tours supplémentaires (1–1000) et d'éventuelles instructions supplémentaires ; continue depuis cette session. La condition préalable est la session, pas le statut — en pratique TurnLimitReached. Failed est refusé en pratique (le harness route vers TurnLimitReached toute exécution ayant produit une session, donc une exécution échouée est morte avant qu'il en existe une) ; une exécution limitée en tours tuée par le mur temporel n'en a pas non plus. Les deux refus nomment le cas ; lancez une nouvelle tâche à la place. |
coding_task_session_info | Tours utilisés / tours max / id de session pour la reprise. |
Le model/provider/backend d'une coding task se résout via la même mécanique de preset que tout le reste (voir §3.7) ; presetId prime sur le triplet explicite model/provider/backend.
Voie Windows (WindowsMcpTools, derrière la feature windows-pool, attachée avec enableWindowsMcp) — un coder loue un worker Windows au premier usage (pas de verbe de lease ; la session est tenue d'un appel à l'autre jusqu'à ce que windows_release la rende, que la tâche soit réglée ou que le bail expire) et le pilote selon deux formes. La forme build : windows_run_spec (soumettre un script, recevoir un handle de tâche) + windows_task_status (interroger). La forme bureau (ARDS-857), qui pilote une vraie UI Automation sur la machine louée comme les outils browser pilotent une page : windows_launch (démarrer un programme, recevoir {pid, hwnd, title}), windows_windows (les fenêtres de premier niveau visibles avec leur hwnd et leurs bounds), windows_focus / windows_close, windows_snapshot (l'arbre UI Automation en texte indenté, un nœud par ligne avec un ref=e<N> valable jusqu'au snapshot suivant), windows_click et windows_type (cible par ref, sinon automationId / name / controlType, sinon un point écran ; le method renvoyé dit si c'est le pattern propre de l'élément ou un vrai clic souris / des frappes qui ont agi), windows_key (des accords comme Ctrl+S, Alt+F4), windows_wait_for (un élément ou un titre de fenêtre atteignant exists / enabled / gone), windows_computer (souris / clavier bruts en pixels de l'écran principal) et windows_screenshot (l'écran principal, ou recadré sur un hwnd ; ses pixels sont les coordonnées que prend windows_computer). windows_release rend aussitôt la machine louée au pool : il met fin à la session (un build windows_run_spec encore en cours dessus est annulé et les programmes qui y ont été lancés sont fermés), l'appel windows_* suivant en loue une nouvelle, et il est idempotent — sans rien de tenu il répond released: false (outcome: not_held) et ne change rien. windows_type prend exactement un de text / secretRef : un secretRef nomme un secret que l'opérateur a provisionné sur le pool Windows (un identifiant, une clé de licence) — le pool tape sa valeur sur la machine et la valeur n'atteint jamais le coder. Un secretRef ne peut être tapé que dans un contrôle masqué de type mot de passe : visé sur autre chose, le guest refuse sans rien taper (SECRET_TARGET_NOT_MASKED), et sur un appel qui portait une saisie le corps d'erreur du pool parvient au coder projeté sur {error, reason, state, secretRef, host} — jamais le texte libre du guest. windows_screenshot avec un hwnd est une lecture pure — la fenêtre n'est pas ramenée au premier plan et une zone recouverte montre ce qui est au-dessus ; windows_focus d'abord quand cela compte. Quand la session Windows d'un coder est libérée (par windows_release, expirée, évincée, ou la tâche réglée), le pool fait fermer par le guest chaque processus que la session a démarré avec windows_launch avant que le slot soit réutilisé, de sorte que rien de lancé par un coder ne survit à son bail. windows_wait_for.timeoutMs est borné à 10 minutes et windows_launch.waitForWindowMs à 55 s — le plafond propre du guest, ordonné guest < pool < core (le budget de lancement du pool est l'attente + 10 s), de sorte qu'un programme qui n'a montré aucune fenêtre à l'échéance revient comme le hwnd: null honnête du guest, jamais comme UI_TIMEOUT (tous deux bornés, pas refusés). Chaque erreur renvoyée par un verbe Windows porte l'un de ces codes. FEATURE_DISABLED : la feature windows-pool est désactivée pour ce tenant — chaque verbe, avant tout bail ; un opérateur l'active. VALIDATION_ERROR : windows_type a reçu ni l'un ni l'autre, ou les deux, de text / secretRef, ou un secretRef qui n'est pas un nom nu — corriger l'appel, aucune machine n'a été louée. Un hôte sans bureau interactif répond DESKTOP_UNAVAILABLE à chaque verbe bureau avec la raison donnée par le pool : session_0 est une installation compile-only (aucune relance n'y change rien) ; capture_probe_failed signifie que la session interactive de l'hôte a cessé de produire des images (son client RDP s'est déconnecté ou a été réduit) — un opérateur doit restaurer cette fenêtre, après quoi le pool re-sonde le bureau sous 30 s ; ne relancer qu'après l'intervention de l'opérateur ; ELEMENT_NOT_FOUND signifie qu'il faut re-snapshoter, WINDOW_NOT_FOUND que ce hwnd n'existe plus (relister avec windows_windows), WAIT_TIMEOUT porte le temps écoulé, UI_TIMEOUT signifie que le guest n'a pas répondu dans le budget par appel du pool (une boîte de dialogue modale bloque peut-être le bureau — windows_screenshot la montre ; relançable), SECRET_NOT_FOUND nomme le secret manquant pour l'opérateur, WINDOW_NOT_FOREGROUND signifie qu'il faut donner le focus à la cible (ou écarter ce qui la recouvre) et réessayer, INPUT_BLOCKED qu'une fenêtre de plus haute intégrité ou un bureau verrouillé refuse la saisie. Tout le reste relève du vocabulaire générique du pool, partagé avec les voies browser et émulateur : POOL_UNAVAILABLE (aucune réponse HTTP — le pool est injoignable ou l'appel a dépassé le timeout HTTP de core ; réessayer), POOL_ERROR (le pool a répondu 5xx ; à saturation il nomme le ou les détenteurs actuels, pour distinguer un pool occupé d'un bail qui a fui ; réessayer), UNAUTHENTICATED / FORBIDDEN (le pool a refusé l'identifiant de core — un opérateur corrige le secret resource-pool-auth ; aucune relance n'aide), NOT_FOUND avec sessionEvicted: true (le pool ne connaît plus la session : le bail est abandonné, l'état de la machine est perdu, l'appel suivant en loue une neuve), CONFLICT (un 409 hors du vocabulaire bureau, par exemple un windows_run_spec alors qu'une tâche tourne déjà — son taskHandle est dans poolDetail), RATE_LIMITED (429 ; réessayer plus tard) et BAD_REQUEST (tout autre refus — un nom de touche inconnu dans windows_key, par exemple). Le data de chaque erreur porte httpStatus, retryable et le corps propre du pool en poolDetail.
2.4 Human-in-the-loop (HITL)
Les agents ne prennent jamais silencieusement des décisions irréversibles. Il existe deux canaux HITL :
La file de décisions (escalade d'agent). Quand un agent permanent a besoin d'une décision humaine, il lève une AttentionRequest via soa_propose_decision (ou, en interne, soa_propose_mode_change pour un changement de mode). Cela :
- est soumis au contrôle de la constitution (constitution-gated) avant sa création (une violation est réinjectée à l'agent, non levée en exception) ;
- apparaît sur la file de décisions de l'opérateur (les outils / le tableau de bord
decision_*) comme une requête d'origine SOA portant{ source: "soa", soaInstanceId }; - met en pause le travail concerné jusqu'à ce que l'opérateur réponde (
decision_respond).
Quand l'opérateur la résout, AgentControlService.EnqueueOperatorAnsweredEscalationAsync met en file un événement OperatorAnsweredEscalation vers l'instance d'origine exacte, portant la resolution + les resolutionNotes de l'opérateur. L'agent reprend depuis cet événement à son tick suivant. L'aller-retour est idempotent (un index partiel unique déduplique les résolutions concurrentes REST-puis-MCP). Point crucial : l'agent ne met jamais ses propres événements en file — le côté contrôle possède chaque mise en file.
Chat opérateur. soa_send_message (agent→opérateur) et la réponse de l'opérateur (qui arrive comme un événement OperatorMessage) forment un canal de chat non bloquant, persisté comme transcript durable et diffusé en direct sur la page de détail de l'agent.
HITL de mission (mission_ask_user). La famille mission a son analogue : un sous-agent de mission peut appeler mission_ask_user pour poser une question qui remonte à l'opérateur et réinjecte la réponse comme guidage de raffinement depuis lequel la mission reprend. C'est l'équivalent côté mission de la boucle soa_propose_decision → OperatorAnsweredEscalation du SOA.
2.5 Modes opératoires, presets & call-sites
Les modes opératoires façonnent ce sur quoi un agent se concentre et quels outils il peut utiliser cet épisode. Chaque type d'agent a son propre catalogue de modes semé (adossé à une table, avec repli sur seed en code) :
- SOA (six modes) :
Strategic(par défaut),Incident,Dialogue,Housekeeping,Idle,Discovery. - Compliance (trois) :
Cadence(par défaut),GateReview,Research. - Prompt Engineer (un) :
Redact.
L'agent ne peut pas changer son propre mode (rail R3/R7). Le mode est écrit uniquement par un humain :
- le contrôle de mode de l'UI (
AgentControlService.SetActiveModeAsync/ les variantes Compliance + redactor par type,source=ui), ou - l'approbation d'une AttentionRequest
soa_propose_mode_change(source=approval).
Les deux chemins convergent vers un unique point d'étranglement et ajoutent une ligne d'audit à agent_mode_change_events. L'agent ne fait jamais que proposer un changement.
Presets & call-sites. Chaque appel LLM dans Genesis est attribué à un call-site nommé dans le LlmSiteRegistry statique. Les sites pertinents pour les agents :
| Id du site | Utilisé par |
|---|---|
Agent:Default | Preset parent par défaut de la famille pour les agents natifs. |
Agent:Planning | L'appel de planification/raisonnement par-tick du SOA. |
Agent:Compliance | L'appel par-tick du Compliance agent (séparé du SOA le 2026-06-24 pour pouvoir être épinglé indépendamment). |
PromptRedactor:Default / PromptRedactor:Redact | Les appels de sous-agent Document/Evaluate du Prompt Engineer. |
Agent:Pod | Le gate de classe de l'agent-pod distant (la frontière /mcp/agent). |
Un opérateur lie un preset (un bundle model+provider+backend+overlay) à un call-site (llm_site_attach_preset / _detach_preset). Un site feuille hérite de la liaison par défaut de la famille de son parent jusqu'à épinglage (p. ex. Agent:Planning → Agent:Default). C'est ainsi que vous épinglez Compliance sur un modèle différent du SOA sans toucher au code. Voir §3.7 pour la mécanique de résolution.
2.6 Pages du tableau de bord
| Route | Page | Affiche |
|---|---|---|
/soa | Tableau de bord SOA | Le Strategic Orchestration Agent : statut, start/stop/reset, chat opérateur, timeline des tours en direct, mode courant + contrôle de mode, audit des changements de mode. |
/agents | Tableau de bord des agents | Effectif des agents à travers le tenant (les cerveaux permanents + les travailleurs du registre). |
/agents/{kind}/{id} | Détail d'agent | Détail en direct par instance : registre des tours, résumés de raisonnement, modèle servi + coût par tour (push en direct SignalR), chat. |
/agents/compliance | Écran Compliance | Le Compliance agent : posture, dossiers, start/stop, mode (Cadence/GateReview/Research). |
/agents/redactor | Écran Prompt Engineer | L'instance liée du prompt-engineer par call-site, ses propositions, son mode. |
/agents/{id} | Détail du registre | Le détail d'un agent du registre. |
/fleet | Fleet de coders | Coders à la demande + config du fleet ; /coders est désormais un onglet ici. |
3. Architecture
3.1 Le modèle de données
Les agents permanents vivent entièrement sur des tables par tenant.
agent_instances — une ligne par instance d'agent (l'analogue SOA d'une ligne de mission) :
| Colonne | Signification |
|---|---|
id | PK (Guid). |
agent_type | Le discriminant AgentType (text NOT NULL DEFAULT 'Soa', stocké en chaîne). |
bound_entity_type / bound_entity_id / bound_entity_key | Couture de liaison pour les agents liés. Le Prompt Engineer se lie à un call-site via (PromptRedactor, "CallSite", siteId) — bound_entity_key est le frère en chaîne, avec un index unique partiel garantissant une instance par couple@call-site. Null pour le SOA. |
label | Libellé d'affichage. |
status | AgentInstanceStatus : Active (pompé), Paused (garé, reprenable), Closed (terminal). Seules les instances Active sont tickées. |
current_phase | Libellé de phase libre que l'agent estampille à chaque tour. |
next_event_sequence_number | Compteur monotone par instance alimentant la séquence de la file d'événements. |
lease_holder_session_id / lease_expires_at | Colonnes de bail CAS (sûreté multi-réplica). |
next_tick_at | Quand le prochain tick auto-cadencé est dû (audit ; le visible_at de la file fait autorité). |
agent_string_id | L'id de l'enregistrement de registre faisant surface à cette instance sur /agents. |
consecutive_idle_ticks | Compteur de backoff B1 (ticks inactifs depuis le dernier changement d'entrées). |
last_plan_input_hash | Hash des entrées externes du planificateur au dernier tick (la clé du court-circuit no-op). |
consecutive_blocked_turns | Compteur du garde STUCK (ticks PhaseBlocked consécutifs). |
active_mode | Le nom du mode opératoire (nullable ; défaut appliqué en code). Écrit uniquement par les chemins humains. |
is_building_starting_workset / workset_deadline_utc | Drapeau de phase fondationnelle + deadline de sûreté-coût (voir §3.6). |
created_at / updated_at | Horodatages. |
agent_event_queue — le journal d'événements par instance. Chaque ligne est un événement avec un event_kind, un payload JSON optionnel, un sequence_number, un visible_at (le gate de dû faisant autorité) et un marqueur de consommation (les événements sont consommés, non supprimés, afin que la dédup-de-reprise puisse voir l'historique). Le discriminant AgentEventKind :
AgentInitialized— premier événement d'une instance neuve (déclenche l'ouverture plan-puis-salue).AgentTick— le battement de cœur auto-planifié.OperatorMessage— un message de chat opérateur à lire au tick suivant.OperatorAnsweredEscalation— un opérateur a répondu à une décision levée par l'agent.MissionStateChanged/DecisionResolved/DependencyCompleted— signaux d'orchestration (une mission pilotée a changé de statut, une décision s'est résolue, une dépendance s'est débloquée).ExternalSignalReceived— un signal générique agnostique du type d'agent dont le payload JSON porte unAgentSignalKind(NewCouple/GuidanceUpdated/RegressionDetected/HumanRequest). Utilisé par le Prompt Engineer (l'étape 6 ne câble queHumanRequest) ; le SOA ne le reçoit jamais.
agent_state_ledger (+ agent_state_ledger_actions) — l'enregistrement des tours en ajout-seul. Chaque ligne de tour porte le kind/payload de l'événement déclencheur, le AgentDecisionKind, le payload de décision structuré ({actions, waitCondition, reasoningSummary, activeMode}), la wait-condition, le résumé de raisonnement et un lien retour vers le snapshot d'appel LLM (modèle servi + coût). Les insertions sont soumises au bail (lease-enforced). Des lignes enfants par action normalisent les actions produites par le tour.
agent_modes — le catalogue de modes par type (name, description, fragment de prompt, JSON de sous-ensemble d'outils, preset optionnel, JSON d'override de budget optionnel, drapeau de seed système). agent_mode_change_events — la piste d'audit des changements de mode. agent_messages — le transcript de chat opérateur↔agent (avec direction).
AgentDecisionKind classe chaque tour : Initialized, Heartbeat, MessageAcknowledged, EscalationResumed, NoOp (hérité), plus les kinds de boucle de planification Planned, ActedWithTool, WaitingForEvent, Escalated. Il est en ajout-seul (persisté en chaîne ; les lignes historiques doivent continuer à classer).
3.2 Le modèle de dispatch
Le AgentDispatcher est un BackgroundService hébergé qui pompe les agents permanents. Sa forme :
- Contrôlé par la fonctionnalité
standing-agents, à deux niveaux. Le dispatcher est hébergé dès que le niveau déploiement est actif (services.core.features.standingAgents.enabled, historiquement la variableAgentDispatcher:Enabled; actif par défaut au déploiement), mais il ne cadence qu'un tenant dont le niveau locataire est actif — et la valeur locataire par défaut est désactivé : chaque tenant s'inscrit depuis Paramètres → Fonctionnalités (voir Fonctionnalités activables). Au démarrage il énumère les tenants actifs et déploie une boucle de polling par tenant. Les tenants nouvellement ajoutés nécessitent un redémarrage de pod pour être pris en compte. - Bootstrap par tenant. Quand
AutoBootstrap=true, chaque tenant obtient une instance SOA singleton assurée au démarrage (le schéma n'impose pas le singleton ; l'invariant « un SOA par tenant » vit dansAgentControlService/ l'appelant du bootstrap). AvecStandingAgentsIdleByDefault=trueelle est créée Active et semée d'un événementAgentInitialized(afin d'exécuter immédiatement son ouverture plan-puis-salue, puis de rester inactive) ; sinon elle est créée Paused, en attente d'un start opérateur. À la première création, l'instance entre aussi dans la phase fondationnelle (§3.6). - Cycle de polling. À chaque
PollingInterval(par défaut 5 s) le dispatcher ouvre un scope DI par-cycle sous un scope tenant ambiant, liste les instances « nécessitant attention » et en traite jusqu'àMaxConcurrentInstancesPerTenant(par défaut 4). - Le traitement par instance est borné par le bail et passe par le superviseur de tick partagé (section suivante).
- Isolation des erreurs aux niveaux cycle et instance — une mauvaise instance ou un mauvais cycle n'arrête jamais la boucle.
Le corps à exécuter est résolu par instance selon l'AgentType via DI par clé (AgentType.Soa → AgentAgent ; AgentType.Compliance → aussi AgentAgent mais avec la politique Compliance ; PromptRedactor → PromptRedactorAgent). C'est ainsi qu'un seul dispatcher sert chaque type permanent.
Deux régimes d'exécution, un seul chemin de code. Un unique drapeau de config, AgentDispatcher:EphemeralPod, choisit le régime :
- Chaud (par défaut,
EphemeralPod=false) — la boucle de polling en-processus tique les instances directement.KeepWarm == !EphemeralPod. - Pod éphémère (
EphemeralPod=true) — la pompe in-core cesse de tiquer les instances en-processus ; des agent pods engendrés par KEDA tirent les ticks via l'endpoint/mcp/agentavecagent_tick_claim/agent_tick_complete. Le bootstrap et le semis d'événements s'exécutent toujours in-core ; seul le tick par-instance migre vers les pods.
Les deux régimes pilotent les ticks via les mêmes primitives AgentTickSupervisor, de sorte que la persistance, le heartbeat et la logique STUCK sont octet-pour-octet identiques quel que soit celui qui s'exécute.
3.3 Ordonnancement des ticks : claim → run → complete
AgentTickSupervisor factorise les primitives bail + file + passivation afin que le dispatcher chaud et le runner de pod les partagent exactement.
ClaimTickAsync :
- Acquérir le bail CAS par-instance pour un
sessionIdfrais (sauter si détenu par une autre session →null). - Retirer de la file le prochain événement dû (
visible_at <= now). Si aucun n'est dû, semer un heartbeatAgentTicksi aucun n'est en attente (premier battement / reprise de chaîne), relâcher le bail et renvoyernull. - Lire le snapshot pré-tick de l'instance (les compteurs idle/STUCK s'y appuient) et renvoyer un
TickClaim.
CompleteTickAsync est l'unique écrivain de passivation — exactement un endroit écrit phase/next-tick/compteurs par tick :
- Garder la session à l'écriture — relire l'instance et confirmer que le bail est toujours détenu par cette session (un pod dont le bail a expiré en cours d'exécution ne doit pas écraser). Si perdu, sauter l'écriture et revenir.
- Dériver le decision kind/phase (le chemin chaud transmet directement le kind/phase déjà décidé par l'agent, de sorte que la valeur persistée est octet-pour-octet identique ; le chemin pod laisse le superviseur re-dériver à partir du résultat brut via le
AgentDecisionMapperpartagé). - Détection d'inactivité — un tick est inactif quand c'était un
AgentTickdont lePlanInputHashcorrespond à celui du tick précédent.consecutive_idle_tickss'incrémente à l'inactivité, se réinitialise sinon. - Garde STUCK — un
PhaseBlockedauthentique (le planificateur a renvoyé bloqué, mappé àWaitingForEventavec phaseidle:blocked) incrémenteconsecutive_blocked_turns. Le compteur est toujours persisté ; l'arrêt ne se déclenche que quandenforceStuckGuard=true(le chemin pod). À l'arrêt àMaxConsecutiveBlockedTurns(par défaut 3) l'instance est passéeClosed, le heartbeat est supprimé (afin que la file se vide et que KEDA scale à zéro) et une AttentionRequest opérateur remonte. Le chemin chaud ne s'arrête jamais (préservant le comportement hérité). - Maintenir exactement un heartbeat — sauf en cas d'arrêt, mettre en file un unique
AgentTickfutur ànext_tick_atsi aucun n'est en attente. - Faire surface de l'instance sur
/agents(chaud seulement), écrire l'unique mise à jour de passivation, pousser le tour en direct via SignalR (chaud seulement) et relâcher le bail dansfinally.
ComputeNextHeartbeatDelay règle la cadence :
- Quand
StandingAgentIdleHeartbeatEnabled=true(par défaut), le prochain heartbeat est unStandingAgentHeartbeatIntervalfixe (par défaut 24 h) — un check-in quotidien lent immunisé contre la gigue de télémétrie. Ainsi un agent se tait juste après son salut d'ouverture et reste silencieux jusqu'à un vrai événement. - Sinon il retombe sur le backoff d'inactivité géométrique (
ComputeTickDelay) :base · BackoffFactor^priorIdle, plafonné àMaxBackoffInterval(par défaut 30 min). Il ne s'engage jamais que sur des entrées inchangées.
Dans les deux cas, les vrais événements contournent entièrement la cadence — les messages opérateur et les escalades répondues sont mis en file avec visible_at = now et réveillent l'agent au cycle suivant.
C'est la distinction « permanent vs ponctuel » en pratique : les agents permanents (SOA, Compliance) se posent sur le heartbeat fixe lent et réagissent aux événements ; les agents ponctuels (Prompt Engineer) ne sont jamais bootstrappés par le dispatcher — ils sont créés Paused sur une liaison/un signal et tickés seulement une fois activés.
3.4 La boucle de planification par-tick (AgentAgent)
AgentAgent est le corps plan-puis-agit partagé pour chaque agent de planification permanent. Par tick il ne touche pas aux baux ni à la file d'événements (le dispatcher en est propriétaire) ; il ne fait que ré-injecter, planifier et enregistrer. La séquence :
- Ré-injecter — charger la queue récente des tours (les 12 derniers tours) pour la continuité à travers les ticks / redémarrages de pod.
- Digest d'ops — sonder la santé opérationnelle « ARDS-self » (deadlocks/rollbacks DB, pics de taux d'erreur, alertes déclenchées) via
IOpsDigestProbe, bucketisée dans le hash d'entrées de plan afin qu'un vrai incident bascule le bucket et force une re-planification. - Charger l'instance — nécessaire à la fois pour le court-circuit et la résolution de mode. Si la lecture échoue, le tick avorte proprement (il ne peut pas résoudre mode/type en sûreté) et réessaie au tick suivant.
- Court-circuit no-op B1 — calculer un
PlanInputHashSHA-256 sur les seuls pilotes externes (event kind + payload + digest d'ops bucketisé ; la queue de raisonnement toujours changeante de l'agent est délibérément exclue). Si le hash correspond à celui du dernier tick et qu'une re-planification forcée n'est pas due, sauter entièrement l'appel LLM et rester inactif. Une soupape de sûreté (ForcedReplanEveryNIdleTicks, par défaut 20) force périodiquement une vraie re-planification pour rattraper la dérive. C'est le levier qui empêche les agents inactifs de re-planifier toutes les 30 s et de brûler du budget. - Préambule par-événement — piloter selon ce qui a déclenché le tick :
AgentInitialized→ survole + poste un court salut ancré puis reste inactif ;OperatorMessage→ lire et répondre ;OperatorAnsweredEscalation→ reprendre en incorporant la réponse ;AgentTick→ baseline. - Effectif des éléments ouverts (open-items roster) — les missions que cet agent a déjà créées + les escalades qu'il a levées (liées via un helper de métadonnées JSONB
soaInstanceId, servi par index). Injecté au sommet de l'objectif afin que le modèle s'ancre sur le travail en cours avant de proposer — le levier direct sur les propositions en double. - Résoudre le mode actif — lire
active_mode(défaut par type), le rechercher dans le catalogue semé, et asserter son toolset ⊆ le superset §3 en fail-closed (le résolveur lève si un mode accordait un outil hors-appartenance — il n'y a pas de filet[Authorize]sur le chemin chaud). Le toolset du mode résolu devient à la fois les outils autorisés de l'invoker et le menu d'actions annoncé de l'objectif ; son fragment de prompt est ajouté à la base invariante. - (Compliance uniquement) découverte du corpus en balayage à froid — résoudre le(s) id(s) de projet de conformité du tenant afin que l'objectif puisse nommer le corpus à interroger.
- Credit gate (B-iii) — résoudre la fenêtre de crédit hebdomadaire de planification de l'agent du tenant (par défaut 60 $/sem). Quand
CreditEnforcementEnabledet que le pool est épuisé, sauter l'appel LLM et rester inactif jusqu'à la régénération ; sinon mesurer le prélèvement. - Planifier — un appel LLM à provenance enregistrée via
ISubAgentInvoker(§3.5), avec le toolset du mode comme surface d'outils autorisée et le budget par-tick résolu (§3.6). - Mapper le résultat — précédence pilotée par histogramme (a levé une escalade →
Escalated; a pris une action à effet de bord →ActedWithTool; sinon complétion propre →Planned/MessageAcknowledged/EscalationResumedselon l'événement ; sinon bloqué →WaitingForEvent). L'échelle vit dans leAgentDecisionMapperpartagé afin que chaud et pod mappent de façon identique. - Enregistrer le tour du registre en ajout-seul (avec le snapshot de provenance en lien retour) et renvoyer l'
AgentDecision— le dispatcher persiste la phase, planifie le prochain tick et relâche le bail.
Une « salve » (burst) est donc une séquence de ces ticks : le premier (AgentInitialized) salue et reste inactif ; les ticks suivants se déclenchent sur le heartbeat fixe ou sur des événements injectés ; à l'intérieur d'un unique tick l'invoker exécute une boucle agentique multi-tours bornée (l'« épisode ») qui peut interroger la mémoire/télémétrie puis émettre une ou deux propositions avant de terminer.
3.5 Comment les agents font des appels LLM (le pipeline en-processus)
Les agents raisonnent via SubAgentInvoker — la boucle agentique manuelle de la base de code, délibérément pas le chemin d'auto-invocation du SDK, parce qu'elle doit observer la frontière de boucle à chaque tour (application du budget, terminaison par outil nommé, provenance par-tour, politique d'échec de dispatch).
Chaque invocation prend un SubAgentRequest portant l'id de l'entité parente (l'instance d'agent), l'AgentType, un phase kind (l'agent utilise une phase Research en findings-seulement afin qu'aucun batch de proposition de mission ne soit ouvert), la clé de site de preset (Agent:Planning / Agent:Compliance, résolue depuis l'IPlanningAgentPolicy de l'agent), le payload d'objectif, l'enveloppe de budget, les outils MCP autorisés (le toolset du mode actif), un id d'invocation et le suffixe de prompt système du mode. Il porte aussi des hooks d'attribution de coût (OwnerAgentInstanceId, QuotaWindowId) et l'override par-tour de tokens de sortie fondationnel.
Le corps de la boucle : semer les messages → tant que non terminé : vérifier le budget → résoudre le couple (model, provider, backend) depuis le preset/site (voir §3.7) → appeler le LLM via un IChatClient Microsoft.Extensions.AI → écrire un LlmCallSnapshot (étiqueté AgentPlanning, indexé par id d'invocation) → mettre à jour la consommation → dispatcher chaque FunctionCallContent via son handler MCP typé → réagir. La règle porteuse (§1.1) : l'appel d'outil est le commit ; le texte de réponse est une trace de raisonnement et n'est jamais parsé pour l'état. La terminaison se fait par outil de control-plane nommé (phase_complete / phase_blocked), non par interprétation de prose ; si un tour émet zéro appel d'outil, la boucle ajoute un coup de pouce synthétique pour terminer.
Repli & provenance. L'invoker pilote la chaîne de repli du preset — bascule de credentials intra-provider d'abord (p. ex. un OAuth-Max 429 → la clé API de priorité inférieure), puis avance de provider — émettant des spans et compteurs OpenTelemetry (subagent.llm_call.fallback_advance, …all_providers_exhausted, etc.). Chaque tentative enregistre un CallAttempt sur le snapshot, avec le modèle servi-vs-demandé et le coût calculé côté Core via le chemin de pricing canonique (l'agent n'auto-reporte jamais le coût). AgentAgent relie ensuite le dernier id de snapshot sur le tour du registre afin que le tableau de bord affiche modèle servi + coût par tour.
Les overlays font partie du preset résolu — un overlay de prompt (et les profils routing-chain / tool-policy / sampling / limits) liés au site. Le fragment de prompt du mode est ajouté au prompt système de base invariant à l'intérieur de l'invoker (base + "\n\n" + fragment), gardant la base invariante par mode.
Parité hors-processus (chemin pod). Quand EphemeralPod=true, le runner d'agent programmatique n'a pas d'invoker en-processus, alors AgentPodMcpTools porte la provenance exacte en deux étapes sur la surface d'agent : agent_record_call_attempt frappe le snapshot AgentPlanning + la tentative terminale afin que les tableaux de bord s'allument de façon identique. Le tick de pod lui-même exécute agent_tick_claim → (tour de substrat) → agent_tick_complete, le superviseur effectuant l'unique écriture de passivation côté serveur.
3.6 Budgets par-tick
AgentTickBudgetResolver est la source unique de vérité pour l'enveloppe de budget par-tick d'un agent permanent. Chaque axe lit la couche de config DB en premier (les clés AgentDispatcher:Tick* dans system_configs), avec repli sur la valeur AgentDispatcherOptions (appsettings/env, elle-même retombant sur le défaut du code). La lecture DB-d'abord est ce qui rend les plafonds ajustables en direct par l'opérateur — une écriture via l'UI Settings / config_set prend effet dès le tick suivant, sans redémarrage.
L'enveloppe (valeurs par défaut du SOA, toutes surchageables par config) :
| Axe | Défaut | Clé de config |
|---|---|---|
| Tokens max (entrée+sortie) | 24 000 | AgentDispatcher:TickMaxTokens |
| Appels d'outils max | 12 | …:TickMaxToolCalls |
| Temps mural max | 300 s | …:TickMaxWallClockSeconds |
| Coût max | 2,00 $ | …:TickMaxCostUsd |
| Tours max (anti-emballement dur) | 12 | …:TickMaxTurns |
AgentAgent.ResolveTickBudget superpose trois sources, par précédence :
- Phase fondationnelle d'abord. Tant que
is_building_starting_worksetest positionné et dans les limites deworkset_deadline_utc, chaque axe est élevé àUnlimitedet le plafond de sortie par-tour monte àFoundationalMaxOutputTokensPerTurn(par défaut 16 384) — afin qu'un agent tout neuf puisse construire son starting workset unique (son socle de connaissances / corpus de dossiers) sans bridage. L'agent termine la phase en appelant le terminateur de contrôleagent_workset_complete; la deadline (par défautnow + 24 h) l'auto-répare si le terminateur n'est jamais appelé. Le plafond hebdomadaire en dollars reste en vigueur tout du long comme filet anti-coût-emballé. L'exemption est universelle — elle vit sur la couture partagéeAgentAgent, donc elle s'applique à chaque type permanent. - Override de mode. Un mode peut porter un override
BudgetJson(p. ex. le mode ComplianceResearchélargit à 48k tokens / 24 appels d'outils / 600 s / 4,00 $ / 24 tours pour la rédaction de dossiers de chapitre entier) — appliqué uniquement à ce mode, n'élargissant jamais le défaut partagé. - Défaut de politique — le
IPlanningAgentPolicy.TickBudget(lu en direct depuis les options à chaque accès).
3.7 Résoudre le couple (model, provider)
Chaque appel LLM d'agent est attribué à un call-site dans le LlmSiteRegistry statique (chaque LlmCallSite porte un SiteId, un nom d'affichage, un modèle par défaut, les backends supportés, les outils autorisés/refusés par défaut et les axes de catalogue — catégorie, la frontière de track à laquelle il appartient, le mode de dispatch, les ids par défaut de routing-chain/tool-policy/overlay). Les sites d'agents sont Agent:Default, Agent:Planning, Agent:Compliance, PromptRedactor:Default, PromptRedactor:Redact et Agent:Pod.
Résolution au niveau de l'invoker :
- La politique de l'agent fournit la clé de site de preset (SOA →
Agent:Planning; Compliance →Agent:Compliance). - Le résolveur de provider recherche le preset attaché au site (liaison
llm_site_attach_preset). Si le site feuille n'en a aucun, il remonte la chaîne de parents (GetParentSiteId:Agent:Planning→Agent:Default;Agent:Compliance→Agent:Default;PromptRedactor:Redact→PromptRedactor:Default) et utilise la liaison par défaut de la famille (LLM.Agent:Default.Preset). Un seeder par défaut sème une liaison initiale afin que la résolution atterrisse sur un vrai preset plutôt que sur la queue héritée[synthetic, anthropic]. - Le preset résolu produit le couple concret (model, provider, backend) plus sa chaîne de repli et tous overlays/profils attachés. L'invoker essaie chaque couple dans l'ordre (bascule de credentials au sein d'un provider avant d'avancer).
Ainsi « avec quel modèle le SOA pense-t-il » se répond par : le preset lié à Agent:Planning (ou hérité de Agent:Default), épinglé en direct par un opérateur via llm_site_attach_preset — sans changement de code, effectif au tick suivant. Le défaut actuel du code pour la famille d'agents est claude-opus-4-8.
La deny-list Agent:Pod sur ce site est purement indicative (un rognage de tools/list). La frontière faisant autorité pour la surface de l'agent-pod distant est le gate de classe : AgentPodMcpTools est la seule classe qu'un token d'agent peut atteindre (il satisfait AgentPodPolicy et rien d'autre), et chaque outil dangereux (decision_respond, *_approve, config_set, mutations llm_*, constitution_*, project_delete, écritures gitlab_*, coder_spawn, modification_apply, browser_*) vit dans une classe gardée par une politique que le token d'agent échoue. La deny-list énumère chaque membre explicitement parce que le filtrage d'outils correspond aux noms exacts (pas de glob).
3.8 Le rail outils/gouvernance
L'ensemble des outils qu'un agent permanent peut jamais atteindre sur le chemin chaud est le superset d'outils §3 (AgentModeCatalog.ToolSuperset), et le toolset d'un mode est toujours un sous-ensemble strict (asserté en fail-closed). Chaque membre du superset est soit en lecture seule (soa_query_telemetry, agent_query_memory, intelligence_knowledge_query, intelligence_code_search, compliance_query_posture, compliance_knowledge_query, orchestrator_research_get, compliance_dossier_list), soit enregistrement-d'artefact (compliance_dossier_record / _translate, compliance_knowledge_ingest, orchestrator_research_create), soit un verbe d'escalade/contrôle soumis à un humain (soa_propose_decision, soa_send_message, soa_propose_mode_change, agent_workset_complete).
L'unique mutation de tenant auto-appliquante — soa_propose_task (création de mission soumise à la gouvernance) — est dans le superset pour le SOA uniquement. La deny-list SelfApplyingTools gardée par la machine assère qu'aucun toolset de mode Compliance (ou Prompt Engineer) ne le contient jamais : ces agents peuvent escalader vers un humain mais ne peuvent jamais auto-appliquer un changement. Ce rail « n'auto-applique jamais » est imposé en code (un test assère que le superset ne contient aucun outil auto-appliquant au-delà de celui du SOA, et que les modes Compliance l'excluent), pas seulement documenté.
Les handlers d'action eux-mêmes gardent leurs gates de gouvernance intacts quelle que soit la surface (chaud en-processus ou pod) : soa_propose_task exécute les vérifications constitution + boundary avant de persister ; soa_propose_decision / soa_send_message / soa_propose_mode_change exécutent la constitution sur leur contenu. Une violation est bloquée-mais-réinjectée (renvoyée au modèle comme un { blockedReason, violations } structuré, jamais levée en exception), afin que l'agent puisse reconsidérer dans le même épisode.
3.9 Cycle de vie & contrôle
AgentControlService possède chaque action opérateur et chaque mise en file (l'agent ne met jamais en file) :
- Start / Stop / Reset (SOA) et StartCompliance / StopCompliance — bascule
statusActive↔Paused, semant un événementAgentInitializedau start. Reset efface en plus la mémoire du registre, draine les événements périmés et re-sème une ouverture fraîche (refusant si un tick est en cours, pour protéger l'invariant d'unique-écrivain-de-passivation). - Chat opérateur — persiste le message (transcript durable), met en file un événement
OperatorMessage, diffuse en direct. - Contrôle de mode — l'ensemble UI (
source=ui) et le point d'étranglement d'approbation (source=approval), chacun validant la cible contre le catalogue propre de l'agent et auditant le changement. - Aller-retour d'escalade — à la résolution par un opérateur d'une AttentionRequest d'origine SOA, appliquer tout changement de mode approuvé, puis mettre en file la reprise
OperatorAnsweredEscalation(idempotente via l'index de dédup-de-reprise). - Signaux Prompt Engineer —
RaiseRedactorSignalAsyncassure-crée l'instance de redactorPausedliée au call-site et met en file un événementExternalSignalReceived(livré éteint — durablement en file mais non tické tant que le corps du redactor n'est pas activé).
Le registre d'agents (AgentRegistryService) est l'annuaire de coordination en mémoire distinct : partitionné par tenant, thread-safe, expiré par heartbeat (5 min), faisant surface des agents de registre (y compris l'auto-enregistrement du SOA) sur /agents. Il est éphémère — re-peuplé après un redémarrage de pod — et strictement isolé par tenant.
4. Mise en perspective : la vie d'un agent permanent
- Bootstrap. Le dispatcher assure un SOA par tenant. Avec l'inactivité-par-défaut activée, il est créé
Active, entre dans la phase fondationnelle (par-tick sans bridage, plafond hebdomadaire en $ toujours imposé) et est seméAgentInitialized. - Ouverture. Le premier tick survole le contexte et poste un court salut ancré (
soa_send_message), puis planifie le prochain heartbeat ~24 h plus tard et se tait. - Fondation. Au fil des ticks suivants (sans bridage) il construit son starting workset, puis appelle
agent_workset_completepour revenir au budget par-tick normal (ou la deadline l'auto-répare). - Régime permanent. Il reste inactif sur le heartbeat quotidien fixe. À chaque heartbeat : sonder la santé d'ops, hacher les entrées externes, et court-circuiter sans appel LLM si rien n'a changé.
- Réagir. Un vrai événement — un message opérateur, une escalade répondue, un changement d'état de mission, un incident basculant le bucket d'ops — est mis en file avec
visible_at = now, réveille l'agent immédiatement et force une re-planification. Dans ce tick l'invoker exécute un épisode borné : interroger la mémoire/télémétrie pour s'ancrer, puis prendre au plus une ou deux actions gouvernées (proposer une mission, escalader une décision, envoyer un message), sans jamais dupliquer quelque chose déjà présent dans l'effectif des éléments ouverts, puisphase_complete. - Gate humain. Tout véritable embranchement devient une AttentionRequest sur la file de décisions ; la réponse de l'opérateur revient comme
OperatorAnsweredEscalationet l'agent reprend. - Modes. Un humain (UI ou approbation) peut changer le focus de l'agent —
Strategic/Incident/Discovery/… pour le SOA,Cadence/GateReview/Researchpour Compliance — resserrant ou élargissant sa surface d'outils et son budget par épisode. L'agent ne peut que proposer un changement. - Sûreté. Si un agent en chemin-pod se coince (
MaxConsecutiveBlockedTurnsblocages consécutifs) il s'arrête àClosed, draine sa file (KEDA scale à zéro) et fait surface d'une AttentionRequest opérateur.
Missions & Tasks
Ce que c'est
La colonne vertébrale de l'exécution. Une mission est un livrable unique que Genesis planifie, décompose en tasks et mène à terme ; une task est l'unité atomique qu'un Agent ou un Coder exécute. Les gates d'approbation humaine à l'intérieur du pipeline se matérialisent sous forme de decisions.
Surface opérateur
Les outils MCP couvrent l'ensemble du cycle de vie :
- Cycle de vie des missions —
mission_create,mission_get,mission_list,mission_decompose,mission_status,mission_pipeline_status. - Revue et approbation des tasks —
mission_tasks_list,mission_tasks_approve/mission_approve_tasks,mission_task_add. - Contrôle au niveau des tasks —
task_create,task_get,task_list,task_update,task_retry,task_reset_retry,task_cancel,task_delete. - Decisions (gates d'approbation humaine) —
decision_list,decision_get,decision_respond,decision_acknowledge,decision_bulk_acknowledge,decision_stats. - Runs & changements (couche d'acceptation) —
mission_run_start,mission_run_get,mission_run_accept,mission_run_discard,mission_revert_preview,mission_revert,mission_changement_stack. Voir Workflows §2.13 pour le modèle run/accept/revert complet.
La surface REST est constituée de MissionsController / TasksController / DecisionsController, et les missions s'affichent sur les pages mission du dashboard.
Comment ça marche
Une mission passe par Pending → Planning (décomposition) → InProgress → PendingReview → Completed / Failed, avec Paused comme état latéral reprenable et Cancelled comme sortie anticipée ; Completed, Failed et Cancelled sont terminaux. L'entité Mission enregistre son track, son kind, la liaison au project / matter, les cumuls de tokens / coûts, le modèle / provider sélectionné et les métadonnées de branche d'intégration. Le plan d'une mission peut provenir d'une décomposition LLM ou d'un Workflow publié compilé en elle — le cycle de vie ci-dessus est le même dans les deux cas ; seule la source du plan varie.
La décomposition est pilotée par LLM et résout le preset de site Missions:Decomposition — qui peut router vers un Coder conteneurisé ajoutant des tasks via mission_task_add. Les tasks (TaskDefinition + TaskEvent) sont dispatchées vers les Agents / Coders, et les étapes de gate se mettent en pause derrière des lignes Decision en attente, résolues avec decision_respond (approve / skip / fail). Les changements d'état des missions et des tasks transitent par une file d'événements (MissionEventQueue) consommée par l'agent dispatcher.
Les transitions de status illégales sont refusées, pas silencieusement ignorées. L'agrégat Mission possède la liste des transitions légales ; demander une transition qu'il n'autorise pas (p. ex. Failed → InProgress, ou tout changement hors d'un status terminal) est rejeté plutôt que transformé en succès no-op. En REST, l'endpoint de status renvoie un 409 avec le code mission.status.invalid-transition et un corps portant currentStatus, requestedStatus et legalTransitions ; l'outil MCP mission_status renvoie une erreur structurée INVALID_STATE_TRANSITION avec les trois mêmes champs — de sorte qu'un Agent ou un opérateur apprend ce qu'il peut faire au lieu de recevoir un succès pour un changement qui ne s'est jamais appliqué. La liste des transitions légales est dérivée des gardes de l'agrégat lui-même, elle ne peut donc pas diverger des règles réelles.
Completed est terminal, avec exactement une sortie sanctionnée : démarrer un nouveau run sur une mission terminée la rouvre en InProgress via une intention de réouverture explicite (ReopenForRun). Le chemin générique de mise à jour de status refuse toujours Completed → InProgress ; la réouverture pour un run est la seule façon dont une mission quitte Completed.
Les missions sont le substrat dans lequel se compilent les Workflows et que pilotent les Agents ; consultez ces guides pour les rouages internes de l'orchestration.
Artefacts d'exécution
Un artefact d'exécution est quelque chose qu'une exécution de workflow a produit et qu'une personne peut regarder — une application web construite ou un APK Android — rendu à l'intérieur de la conversation qui possède la mission, avec une identité durable qui survit à toute session de visualisation. L'exécution construit la chose ; Genesis la sert sur notre propre infrastructure et diffuse des pixels vers le navigateur de l'opérateur, de sorte que les clics de l'opérateur sont de vrais clics sur l'application en cours d'exécution tandis que son code n'atteint jamais sa machine.
Les artefacts d'exécution sont par locataire : chaque outil et point de terminaison est protégé par
la politique tenant-admin, et la location est implicite via la base de données par locataire (pas de
colonne TenantId — ADR-008), exactement comme les missions, les tâches et les workflows. L'
enregistrement vit dans la base de données du locataire propriétaire ; un identifiant frappé pour un
locataire est structurellement invisible pour un autre.
Cette page couvre les deux surfaces :
- Opérateur / produit — ce qu'est un artefact, les deux genres, éphémère vs durable, le modèle de visibilité, et la frontière d'isolement telle qu'elle est réellement aujourd'hui.
- Architecture — l'enregistrement, comment la construction d'une exécution devient une cible servable, le pipeline de captures, la session de rendu lecture-seule/écrivain-unique, et la surface d'outils.
Statut (2026-08) : staging uniquement, désactivé par défaut. Toute la surface est derrière
Artifacts:Enabled(désactivé par défaut) et la session de rendu interactive derrièreFeatures:OperatorBrowseInputLock(désactivé par défaut). La mise en garde d'isolement ci-dessous est déterminante — lisez-la avant d'activer quoi que ce soit.
1. Guide de l'opérateur
1.1 Ce qu'est un artefact
| Concept | Signification |
|---|---|
| Artefact | Un enregistrement durable (stringId, 8 caractères) d'une chose visualisable qu'une exécution a produite, cadré sur (run, node) — un artefact par nœud produit. |
| Genre | WebApp (une page servie, pilotée par le pool navigateur) ou AndroidApp (un APK, rendu par le pool émulateur). Modélisé pour qu'un troisième genre n'ajoute aucun changement de schéma. |
| Captures | Le côté durable : un ensemble ordonné d'images PNG plus un CaptureSetHash stable, et assez de provenance de build pour réengendrer. C'est ce qui rend un artefact réouvrable et partageable. |
| Session | Le côté éphémère : une paire de pods en cours d'exécution (l'app servie + le relais de pixels) avec un TTL, engendrée à la demande depuis la build de l'exécution et récupérée à son expiration. |
| Visibilité | Private (l'admin du locataire producteur seulement, la valeur par défaut à la naissance) · Tenant (tout membre autorisé) · Link (un jeton de lien non authentifié — captures uniquement, jamais une session live). |
| État de session | Un état distinct, rendu séparément : pas de session, live, session expirée, échec d'engendrement, build indisponible, capacité dépassée — jamais une image vide. |
1.2 Éphémère vs durable
Une session de rendu live ne peut pas être conservée indéfiniment ; l'identité stable doit donc lui survivre. Rouvrir un artefact après la mort de sa session affiche ses captures, pas une erreur, et propose de réengendrer si la build est toujours disponible. Un visualiseur par lien ne voit que des captures — jamais une session capable d'entrée.
1.3 La session interactive
L'opérateur autorisé s'attache interactif par défaut — vrai clavier et souris dans l'application en cours d'exécution. Les visualiseurs supplémentaires de la même session s'attachent en lecture seule, et un attachement lecture-seule a l'air lecture-seule : leur entrée est abandonnée au relais tandis que les pixels continuent de circuler. L'entrée est à écrivain unique — exactement un visualiseur attaché détient le verrou d'entrée à la fois ; le transmettre est explicite, et deux personnes ne pilotent jamais la même session simultanément. Le navigateur dans le pod est épinglé à l'origine de l'app servie : une navigation hors de cette origine est bloquée et montrée à l'opérateur comme un refus, jamais suivie silencieusement.
1.4 Rendre un artefact accessible par un lien est une écriture
Produire un artefact est un effet de bord d'exécution et ne nécessite aucune nouvelle approbation.
Activer la visibilité Link est un franchissement de frontière : c'est classé écriture, protégé, et
enregistré (qui l'a activé et quand). Une identité automatisée est refusée — exactement comme
decision_respond en refuse une sur un changement de gouvernance ; seul un humain authentifié peut
ouvrir un lien.
1.5 La frontière d'isolement — à lire
À l'intérieur d'un locataire, un artefact de prévisualisation (code écrit par le modèle) et les environnements de test client de ce locataire partagent la frontière de rendu. C'est délibéré : un locataire est le domaine de données d'un seul client.
La frontière par locataire n'est PAS appliquée au niveau réseau sur le substrat actuel. Le pool de rendu est une instance unique partagée par cluster, et les deux clusters exécutent un CNI (Flannel) qui ne livre aucun moteur de NetworkPolicy — les politiques réseau qui existent sont donc inertes. Mesuré depuis l'intérieur du pod de rendu, une build non fiable peut atteindre l'API core de Genesis, Postgres, Keycloak, le miroir git, le point de terminaison MCP et les services d'un autre locataire ; l'authentification au niveau applicatif (jetons MCP/API, identifiants BD) tient encore, mais le réseau non. L'épinglage d'origine empêche un clic d'opérateur de devenir une requête hors-origine ; il n'empêche pas les propres requêtes de chargement de l'app servie d'atteindre des services internes.
C'est pourquoi la fonctionnalité est staging uniquement et désactivée par défaut. Elle y est bornée
par cinq propriétés — pas de contenu (un clone structurel, aucun dépôt client / donnée locataire réelle
/ identité réelle), un opérateur unique, drapeau désactivé, aucun chemin d'identifiant vers la prod, et
aucun chemin réseau privé vers la prod. Le préalable à tout usage prod ou multi-locataire est un CNI
capable de politiques (Cilium/Calico) plus un durcissement du pool (ports noVNC authentifiés,
browser_run_spec/eval protégés, aucun jeton de compte de service monté, espaces de noms de rendu par
locataire). Cet écart est enregistré comme un écart de conformité, non porté silencieusement par le
drapeau de fonctionnalité.
Si l'app testée peut atteindre quoi que ce soit d'avec état, les clics d'un opérateur provoquent de vraies écritures — visibles avant de cliquer, pas découvertes après.
2. Architecture
2.1 L'enregistrement
RunArtifact (BD locataire, run_artifacts) porte : le StringId de l'artefact ; la provenance
MissionId / RunId / TaskDefId / NodeId ; Kind / Visibility / SessionState (persistés en
chaîne pour qu'un troisième genre ne nécessite aucune migration) ; les champs de lien (LinkToken,
expiration, activé-par/le) ; la référence de build (BuildRef, branche, sha, slug locataire, id
d'environnement — assez pour réengendrer) ; l'ensemble de captures (CaptureSetHash + un
CaptureManifestJson ordonné) ; et le handle de session courant quand une est live. L'unicité est
(RunId, NodeId) NULLS NOT DISTINCT — un artefact par nœud produit. EnvironmentId est une simple
chaîne, pas une clé étrangère : l'enregistrement d'environnement vit dans la base du plan de contrôle.
L'enregistrement est le producteur manquant d'un consommateur déjà livré en échec-fermé :
RunTargetProvisioner.ResolveRunArtifactRef fait désormais une vraie recherche de la build qu'une
exécution a produite au lieu d'en dériver une depuis un gabarit opérateur.
2.2 De la build à la cible servie
Il n'y a aucune construction d'image dans le core Genesis — le chemin est git-clone plus un
environnement rendu par ArgoCD. Une WebApp est servie par un mode serve du chart
run-built-target : la branche d'exécution est clonée dans un pod éphémère qui construit et sert l'app
sur un port ; BuildRef est cette URL de service intra-cluster. Le pool navigateur loue une session,
navigue vers elle, et diffuse Chrome à tête sur noVNC — le même chemin de relais que le genre
émulateur/APK utilise. Le pod serve garde une posture durcie (aucun jeton de compte de service monté,
non-root, seccomp, toutes capacités abandonnées).
2.3 Captures
Les captures sont des pixels, pas du code. Une image est persistée via le service de pièces jointes
(base64 dans Postgres — il n'y a pas encore de stockage objet, donc un « screencast » est une séquence
bornée d'images, pas de la vidéo), ajoutée au manifeste ordonné, et empreintée par un SHA-256 stable sur
les ids de pièces jointes ordonnés. Elles sont servies via un point de terminaison dédié qui force
image/png — du HTML/JS capturé n'est jamais servi comme document actif depuis une origine de
confiance.
2.4 La session de rendu
Le relais de pixels est le proxy VNC d'operator-browse. Pour un visualiseur lecture-seule, un filtre de
cadrage de messages RFB à état abandonne les messages d'entrée entiers (clavier/pointeur/presse-papier)
tout en transmettant les messages d'affichage, et échoue-fermé sur tout ce qu'il ne peut pas cadrer. Qui
peut écrire est un verrou d'entrée autoritatif côté core diffusé vers le relais ; le relais met en
cache le détenteur localement et se traite comme lecture-seule si le flux de verrou tombe ou devient
périmé (> 2 s). L'application est protégée par Features:OperatorBrowseInputLock (désactivé par défaut
— le proxy verbatim hérité quand désactivé).
2.5 Surface d'outils
MCP en lecture seule : artifact_list (par mission ou exécution), artifact_get (métadonnées + URLs de
captures), et artifact_show (émettre le bloc de rendu dans la conversation pour que la carte s'affiche
en ligne). Tous sont tenant-admin, protégés par Artifacts:Enabled, et nés attribués. La publication
de lien n'est délibérément pas un outil MCP — c'est une action humaine derrière le point de passage de
décision.
2.6 Ce qui n'est pas implémenté
Servir le HTML d'un artefact au navigateur propre d'un humain (un modèle de sécurité d'isolement d'origine différent) ; l'édition, le versionnage ou la comparaison d'artefacts ; et les screencasts vidéo (reportés jusqu'à l'existence d'un stockage objet). La frontière réseau par locataire (voir §1.5) est le préalable déterminant pour la prod.
Charters et Matters
Ce que c'est
La couche stratégique au-dessus des missions. Un Charter est une initiative de longue durée — une Vision assortie de critères d'acceptation et d'un périmètre exclu. Un Matter est un épic stratégique rattaché à un Charter qui regroupe des missions liées.
Surface opérateur
Principalement en lecture depuis MCP :
charter_get— Vision + critères d'acceptation.matter_get— détail de l'épic avec son Charter parent et les missions liées.matter_progress— missions totales / terminées / en échec + un ratio de santé.matter_register/matter_list— enregistrer et lister les épics.
Le dashboard expose une vue stratégie / roadmap, et StrategyController sert les API de lecture.
Comment ça fonctionne
CharterRecord possède une collection de MatterRecord (ordonnés via ExecutionOrder / SortOrder), et les missions référencent leur MatterId. Les Charters portent aussi des métadonnées de branche d'intégration et de dépôts affectés, de sorte qu'une initiative entière peut atterrir sur une branche cible. Le MatterPipelineService et le MatterVerificationService font avancer les épics et vérifient leurs critères d'acceptation, tandis que StrategyRepository est l'accesseur de données en lecture/écriture. Les Charters et les Matters résident dans la tenant database et sont gérés par les administrateurs de tenant.
Dialogue (conversations)
Ce que c'est
Des conversations stratégiques et multi-tours avec le modèle, qui servent aussi de principal point d'entrée pour transformer une idée en travail approuvé. Une conversation peut lire l'état vivant du système et, quand vous lui demandez d'agir, soit proposer un travail à votre approbation, soit — lorsque le tier d'écriture est activé — accomplir une action bornée.
Surface opérateur
conversation_create,conversation_send,conversation_list,conversation_get,conversation_complete— le cycle de vie de la conversation. Chaque conversation est étiquetée avec un Track (Governance / Research / Planning / Build) pour le contexte.conversation_branch— bifurque une conversation pour explorer une alternative.mission_propose— le pont actuel vers l'exécution. Sur un tour où vous demandez une fonctionnalité ou un changement, le modèle appelle cet outil (au lieu de décrire le travail en prose) pour lever une demande d'approbation. Il crée un draft de workflow non publié plus une unique demande d'attention d'approbation qui atterrit dans la file des Decisions — aucune Mission vivante ni workflow publié. Vous examinez et approuvez — et l'approbation crée alors la Mission automatiquement (voir plus bas).dialogue_propose_mission— le pont plus ancien et plus simple, toujours présent : il crée directement une Mission pending (en attente), reliée à la conversation, que vous approuvez. Aucun draft de workflow n'y est attaché.dialogue_check_mission,dialogue_get_mission_results— suivent une proposition et rapatrient les résultats de tasks d'une Mission terminée dans la conversation pour en synthétiser une réponse.
DialogueController et ConversationExportController sous-tendent la surface de chat REST / dashboard.
Comment ça marche
Les conversations sont stockées sous forme de lignes Conversation + ConversationMessage, étiquetées avec leur Track. Les appels au modèle effectués pendant une conversation transitent par la couche LLM sous leur propre Call site de dialogue (p. ex. Dialogue:GeneralDialogue, Dialogue:MissionAssistant) et sont attribués en coût à la conversation. Tout ce que le modèle crée porte l'id de la conversation d'origine (OriginConversationId), de sorte qu'une proposition ou une Mission reste toujours traçable jusqu'au Dialogue qui l'a engendrée. Le dialogue peut s'exécuter contre un provider de modèle direct in-process ou un sidecar, selon le preset et le backend résolus.
Ce que le modèle a le droit de faire (tiers d'outils)
Les outils qu'une conversation peut appeler sont hiérarchisés en tiers selon leur pouvoir de modification. Par défaut, Core les sert in-process (aucun processus Bridge distinct requis) :
- Tier lecture — toujours disponible. Les outils de status, de liste et de get (missions, tasks, decisions, coûts, pipelines, …) s'exécutent directement. Quelques outils au nom en read qui, à l'exécution, se déploient en appels d'expert ou de modèle — et coûtent donc de l'argent — sont retenus jusqu'à ce qu'un opérateur les active.
- Tier act / écriture — désactivé par défaut, doublement gaté. Un allowlist organisé d'outils de création/mise à jour (
mission_create,task_create,decision_create,mission_add_task, …) n'est servi que lorsqu'un interrupteur au niveau du déploiement (Dialogue:InProcessTools:WriteEnabled) l'admet. Même alors, un outil ne s'exécute que si le tenant a activé les outils d'écriture (une bascule sur l'écran de réglages Fonctionnalités — le message de refus vous y renvoie) et que vous avez explicitement demandé l'action (une intention execution-command) ou qu'un grant de session vivant l'autorise. Sur un tour de feature-request ordinaire, il ne s'exécute pas — le modèle expose l'action proposée et une suggestion est enregistrée à la place. Les verbes de disposition (*_approve/*_reject/*_respond/*_promote) sont exclus purement et simplement, de sorte qu'une conversation ne peut jamais approuver ni résoudre un artefact gaté par un humain — y compris ses propres propositions. - Tier propose —
mission_propose. Servi sous le même interrupteur de déploiement que le tier d'écriture : sur un déploiement où les outils d'écriture sont éteints, vous ne le verrez pas du tout. Ce que proposer contourne, c'est le gating d'exécution : proposer ne mute rien directement (cela ne fait que lever une demande d'approbation), donc ni la bascule par tenant ni le contrôle d'intention explicite ne s'y appliquent — même un tour de feature-request ordinaire a le droit de proposer. Le système propose ; l'humain dispose.
Ce qu'approuver une proposition fait — et ne fait pas
La proposition atterrit dans la file des Decisions en portant la spec de Mission proposée et une poignée vers le draft de workflow non publié, avec trois options : Approve and create, Request changes, Reject. Choisissez Approve and create et la Mission est créée pour vous : un handler de résolution guette l'approbation et matérialise la Mission par le même chemin que celui qu'emprunte mission_create — aucune ressaisie manuelle, et exactement une Mission par proposition même si l'approbation se déclenche deux fois.
Ce que l'approbation ne fait délibérément pas, c'est publier (ou attacher) le draft de workflow. Si le modèle n'a pas pu esquisser de plan d'exécution, le draft est un graphe placeholder qui échouerait à la validation de publication — le draft reste donc un draft, que vous examinez, complétez et publiez vous-même. En bref : approuver crée la Mission automatiquement ; publier le workflow reste votre acte délibéré.
Si une feature-request n'atteint jamais une proposition formelle, la conversation enregistre tout de même une suggestion (une ligne MissionSuggestionRecord) reliée à la conversation, afin que l'idée soit capturée pour une revue ultérieure plutôt que perdue.
Compliance
Ce que c'est
Gestion continue de la posture réglementaire. Évaluez un projet au regard de référentiels (DORA, CRA, PLD, NIST CSF, ISO 27001, SOC 2, GDPR, HIPAA, NIS2, EU AI Act, et bien d'autres), suivez les écarts, gérez les incidents ainsi que le SBOM / les vulnérabilités, et générez des dossiers de preuves. Un Compliance agent permanent balaie cette posture de façon autonome.
Surface opérateur
- Évaluation et reporting —
compliance_status,compliance_assess(réévalue les référentiels et persiste les scores + écarts),compliance_assessment_history,compliance_requirements,compliance_gaps/compliance_gap_create,compliance_frameworks,compliance_mappings,compliance_market_readiness. - Personnalisation du catalogue —
compliance_catalogue_list, ainsi que les outils de création, override, désactivation et effacement d'override pour les contrôles / exigences. - Incidents —
incident_create,incident_classify,incident_timeline_submit,incident_close,incident_overdue. - Chaîne d'approvisionnement —
sbom_latest,sbom_import,vulnerability_list/vulnerability_record,compliance_documents/compliance_document_upload.
Le REST réside dans ComplianceController, ComplianceCatalogueController, IncidentController, RegulatoryDossierController et DossierController.
Comment ça marche
Le catalogue d'exigences / contrôles et les correspondances de contrôles inter-référentiels résident dans le control-plane (ComplianceRequirements, ComplianceControls, ComplianceControlMappings) et sont résolus par tenant avec des overrides. Les évaluations sont persistées sous forme de lignes ComplianceAssessmentRunRecord → ComplianceAssessmentItemRecord avec ComplianceGapRecord et ComplianceEvidenceRecord. L'évaluation peut invoquer des vérifications de règles pilotées par LLM sous le site preset Compliance:Assessment.
Les changements de catalogue proposés par le Compliance agent (compliance_catalogue_propose_delta) n'écrivent jamais le catalogue directement : chaque delta atterrit dans la file des Decisions sous forme de demande de ratification qu'un humain différent doit approuver — le proposeur ne peut jamais être l'approbateur. À l'approbation, le delta est appliqué au catalogue de référence et chaque dossier qui en dépend est marqué stale (périmé) ; re-générer un dossier périmé reste une action humaine explicite.
Les incidents, les instantanés / composants SBOM, les fournisseurs tiers, les entrées de dossier et les instantanés de rapport sont tous cantonnés au tenant et alimentent des rapports et dossiers de compliance exportables, optionnellement bilingues (EN / FR). Le même catalogue de contrôles sous-tend l'overlay de compliance des Workflows (materialize / waivers / plancher de publication).
Support Cases
Ce que c'est
Un service d'assistance assisté par agent. Les problèmes remontés suivent un playbook (guide de traitement) de la prise en charge à la résolution, avec corrélation de télémétrie, mise en correspondance avec des cas similaires et des problèmes connus, ainsi que la rédaction de réponses.
Surface opérateur
- Cycle de vie —
support_case_create(ouvre en Received),support_case_get,support_case_list,support_case_acknowledge,support_case_close,support_case_defer,support_case_escalate,support_case_supersede,support_case_promote. - Assistants d'investigation —
support_case_correlate_telemetry,support_case_find_similar,support_case_match_known_issue,support_case_classify_area,support_case_run_investigation,support_case_run_playbook,support_case_compose_reply,support_case_apply_verdict,support_case_request_reporter_info,support_case_request_verification,support_case_raise_stack_readiness.
SupportCasesController et ReporterCasesController sous-tendent la surface REST / dashboard.
Comment ça fonctionne
Un cas est créé sur une Matter et progresse à travers des états pilotés par un default playbook (playbook par défaut) — exécuté à la demande, pas sur minuterie. Il n'existe aucun ticker de playbook en arrière-plan : une passe de playbook s'exécute quand quelque chose la demande (support_case_run_playbook, ou l'endpoint REST run-playbook du cas), et chaque passe est idempotente. L'avancée sans intervention, quand elle se produit, vient plutôt du côté workflow : la création d'un cas émet un événement support-case.created, et un workflow dont un event trigger est armé dessus peut prendre le cas en charge automatiquement. Le seul worker planifié est le service de SLA côté rapporteur : un cas en attente dans AwaitingReporter se ferme automatiquement en CannotReproduce après 7 jours (Support:Sla:ReporterReplyDays). Le service repère aussi les cas dus pour un rappel au rapporteur au jour 3 (Support:Sla:ReminderDays), mais pour l'instant il ne fait que les signaler — aucun rappel n'atteint encore le rapporteur.
Les étapes d'investigation s'appuient sur la stack de télémétrie / observabilité (corrélation Loki / Tempo / Prometheus), la base de connaissances intelligence pour les cas similaires / problèmes connus, et la couche LLM pour classer et rédiger les réponses. Les cas capturent leur page / entité d'origine pour le reporting intégré au produit et peuvent être promus en missions ou en problèmes connus.
Intelligence & Knowledge
Ce que c'est
La couche de compréhension propre à chaque Project. Elle profile une base de code, ingère et interroge un corpus de connaissances, exécute des « prisms » analytiques et propose de la gouvernance, du scaffolding et de l'onboarding.
Surface opérateur
- Profilage et découverte —
intelligence_profile,intelligence_profile_build,intelligence_discover,intelligence_recommendations,intelligence_briefing_generate. - Corpus de connaissances —
intelligence_knowledge_ingest,intelligence_knowledge_query,intelligence_knowledge_sources,intelligence_knowledge_stats, ainsi que découverte / suggestion / approbation (intelligence_knowledge_discover,intelligence_knowledge_suggestions,intelligence_knowledge_approve). - Index / recherche de code —
intelligence_code_index,intelligence_code_search. - Prisms (passes analytiques) —
intelligence_prism_run,intelligence_prisms_list,intelligence_prisms_run_all,intelligence_prism_findings,intelligence_prism_report. - Règles de gouvernance —
intelligence_governance_list/_add/_update. - Scaffolding —
intelligence_scaffolding_generate/_approve/_execute/_status; ainsi que les alertes et la configuration de maintenance. - Aspects (dimensions suivies de la santé du Project) —
aspect_summary_get/aspect_summary_refresh,aspect_open_questions,aspect_investigate,aspect_resolve_question.
Le REST correspond à IntelligenceController (+ CooccurrenceController, SuggestionsController).
Comment ça marche
Les sources de connaissances et les profils de Project persistent par Tenant (KnowledgeSource, ProjectProfile, CodebaseSnapshot, IntelligenceBriefing). Le code est découpé en morceaux et vectorisé pour la recherche sémantique (EmbeddingChunk, un modèle all-MiniLM-L6-v2 embarqué en processus), les relations entre fichiers sont extraites dans FileCooccurrence, et les prisms émettent PrismReport → PrismFinding. Les Aspects sont des dimensions suivies de la santé du Project, chacune dotée d'un instantané de synthèse rafraîchissable (AspectSnapshot) et de questions ouvertes que les Agents peuvent investiguer et résoudre.
Configuration LLM et surcharges de prompt
Ce que c'est
Le centre de contrôle qui régit la façon dont chaque appel de modèle est effectué — quel fournisseur / modèle, avec quels fallbacks, outils, échantillonnage, limites et façonnage du system-prompt, le tout sélectionné par call site.
Surface opérateur
- Presets —
llm_preset_list_v2,llm_preset_get_v2,llm_preset_create_v2,llm_preset_update,llm_preset_delete_v2, etllm_preset_simulate(résolution en dry-run pour un site). - Rattachement au site —
llm_site_attach_preset,llm_site_detach_preset,llm_site_attached_preset,llm_preset_apply. - Modes (bundles atomiques) —
llm_mode_list/_get/_create/_update/_delete,llm_mode_preview,llm_mode_apply,llm_mode_history. - Fournisseurs / identifiants / backends —
llm_provider_list/_create/_test/_refresh_models,llm_credential_list/_create/_set_key/_quarantine/_set_coder_cap,llm_backend_list/_create,llm_config_set_fallback_chain,llm_config_set_max_turns, plus la famille historiquellm_config_*et les snapshots (llm_snapshot_list/_get, etllm_call_explainqui réunit en un seul document le snapshot d'un appel et chacune de ses tentatives enregistrées — voir la recette 13 dansdocs/MCP-COOKBOOK.md).
REST : LlmConfigController, LlmConfigModesController, LlmValidationController, LlmAvailabilityController.
Comment ça marche
Un preset (LlmPresetRecord) est un bundle composable, optionnellement hérité, regroupant des étapes de routage (LlmPresetStepRecord → RoutingChain / RoutingTarget avec fallbacks), une tool policy (politique d'outils), des profils d'échantillonnage et de limites, une surcharge de prompt (prompt overlay), et des bascules de capacités MCP (browser / emulator / windows). Une surcharge de prompt (PromptOverlayRecord) injecte ou supprime des experts nommés et ajoute un préfixe / suffixe de system-prompt personnalisé.
Les presets se rattachent aux call sites en écrivant une clé de configuration LLM.{SiteId}.Preset ; au moment du dispatch, le ProviderResolver la lit (en se rabattant sur LLM.{Family}:Default.Preset lorsqu'un site spécifique n'est pas rattaché) et résout le fournisseur / modèle concret. Ces catalogues résident dans le control-plane ; les modes (LlmConfigModeRecord) appliquent en une seule fois tout un ensemble de rattachements de sites, avec preview complet et historique. C'est le même chemin de résolution qu'utilisent les sites de planification des Agents et les nodes de call site des Workflows.
Savoir ce qui s'est réellement passé sur un appel
La configuration dit comment un appel aurait dû être effectué. La télémétrie d'appel, elle, dit ce qui s'est produit — et elle se lit sans rien connaître du schéma de stockage.
Chaque snapshot porte son propre dénouement. À côté de la configuration matérialisée, chaque snapshot — dans la liste, dans le détail comme dans le résultat de llm_preset_simulate — indique disposition et dispositionAt (comment et quand l'appel s'est terminé), correlationId (la chaîne à laquelle il appartenait), attemptCount et servedStepOrder (le nombre de tentatives et l'étape de la chaîne de fallback qui a finalement répondu), errorCode, resolutionRule et resolutionId (la règle qui a choisi le preset), writer, totalLatencyMs et estimatedCostUsd.
Les dispositions possibles sont served, failed, walled, refused_preflight, synthetic, cancelled, timed_out et orphaned. Une disposition absente signifie que l'appel est toujours en cours : une liste sans filtre ne se réduit donc pas à la somme de ces états.
Filtrer par dénouement. GET /api/v1/llm/snapshots accepte les filtres disposition et correlationId : « montre-moi ce qui a échoué sur ce site » tient en une requête au lieu d'un parcours page par page. Comme siteId, ces filtres fonctionnent en égalité stricte — il n'existe ni joker ni forme par préfixe.
L'historique des tentatives. GET /api/v1/llm/snapshots/{id}/attempts renvoie une ligne par tentative, dans l'ordre où le runtime les a essayées : dénouement, statut HTTP, détail de l'erreur, identifiant de requête côté fournisseur (celui à citer au support du fournisseur), identifiant et compte utilisés, fenêtre de rate limit consommée et heure de sa réinitialisation, latence jusqu'au premier token, compteurs de tokens de cache, heures de début et de fin. Une étape que la chaîne n'a jamais atteinte n'a aucune ligne : le nombre de lignes montre donc jusqu'où la chaîne de fallback est allée. Un snapshot sans tentative enregistrée renvoie une liste vide, ce qui reste distinct d'un snapshot inconnu.
llm_call_explain répond à la même question en un seul appel, là où il faudrait sinon enchaîner une liste, une lecture de détail et une lecture des tentatives.
Texte des prompts et frontière d'autorisation. L'historique des tentatives ne contient délibérément aucun texte de prompt ni de réponse — et c'est précisément pour cela qu'il est accessible à tout appelant autorisé : un opérateur peut suivre un appel en échec de bout en bout sans être exposé au contenu des conversations. Le texte des prompts et des réponses reste sur la route de détail du snapshot, protégée par la politique d'administration de tenant. Cette séparation est voulue : les champs nécessaires au diagnostic d'une panne ne sont pas ceux qui portent les données client, ils n'ont donc pas à partager le même niveau de permission.
Costs & Budgets
Ce que c'est
La comptabilité de bout en bout des dépenses et ses garde-fous — chaque appel de modèle est mesuré, tarifé, attribué et vérifié par rapport aux budgets et aux quotas.
Surface opérateur
costs_query,costs_summary,costs_by_scope,costs_by_mission,costs_record.- Vues d'utilisation —
usage_summary,models_list. budget_status— la vérification du budget restant, exposée aux Agents, utilisée à l'intérieur des phases de mission.
Côté REST, ce sont CostsController / UsageController, et le dashboard affiche les tableaux de bord des coûts et de l'utilisation.
Comment ça marche
Chaque appel écrit un CostTrackingRecord qui capture les tokens d'entrée / de sortie et de lecture / création de cache, les indicateurs de tarification par lot (batch pricing), les unités d'utilisation, la ligne de tarification résolue, le coût dans la devise d'origine et une estimation en USD — attribués par BillingScope à une mission, une conversation, une task et un project. Les fenêtres de quota (QuotaWindow) et le mode de facturation effectif permettent de suivre côte à côte l'usage par abonnement et l'usage à l'usage mesuré (metered), y compris un coût « théorique » pour les appels sous abonnement. Ces enregistrements se cumulent dans les totaux de tokens / coûts de la mission ainsi que dans les vérifications de budget que les Agents consultent avant d'entreprendre un travail coûteux (voir l'enveloppe de budget par tick dans le guide Agents).
Projects & Workspaces
Ce que c'est
Deux surfaces liées. Les Projects enregistrent une base de code (avec ses repos, son arborescence de fichiers et sa politique de périmètre) comme point d'ancrage des missions. Les Workspaces sont des dossiers de travail éphémères que les agents utilisent pour préparer des fichiers.
Surface opérateur
- Projects —
project_list,project_get,project_register,project_sync,project_delete,project_tree_get/project_tree_update,project_check_boundary. - Workspaces —
workspace_create(renvoie le handleworkspaceIddont tous les autres outils ont besoin),workspace_write_file,workspace_read_file,workspace_list_files,workspace_delete.
Côté REST, on trouve ProjectsController, WorkspaceDownloadController et les contrôleurs de connexions / onboarding ; le dashboard expose l'enregistrement des projets et les vues d'arborescence de fichiers.
Comment ça marche
Un ProjectRecord est relié à ses dépôts Git (ProjectConnection, ProjectMirrorMetadata, ProjectSubmodule) et stocke une arborescence enregistrée de fichiers / modules ainsi qu'une politique de périmètre que project_check_boundary applique pour que les agents restent à l'intérieur des chemins approuvés ; ProjectSession et PendingSync suivent l'état de synchronisation. Les Workspaces sont provisionnés dans un service genesis-workspace propre à chaque tenant et adressés uniquement par l'id qu'ils renvoient — ils sont délibérément séparés des repos de projet permanents, afin que les agents puissent gribouiller librement avant de produire des changements soumis à review.
Canevas de design
Une tâche de design (coding_task_dispatch avec taskType: "design", ou un nœud Coder de workflow dont le type de tâche est design) fait produire au coder un canevas de design — des maquettes multi-plans sous forme de fichiers .dc.html accompagnés d'une mise en page canvas.json, commités sous design/<slug>/ dans le dépôt du projet. Genesis assemble ces sources en un unique canevas pan/zoom et l'affiche sur la page du projet (/projects/{id}) et l'écran Aperçu ; chaque canevas s'ouvre à /projects/{id}/design/{taskId}/{slug}.
Il s'agit du skill propre à Genesis (genesis-design-canvas), et non de la fonctionnalité /design de Claude Code : le skill intégré et son outil Artifact exigent une connexion claude.ai que le coder, médié par le broker, n'a pas ; Genesis produit donc le même format .dc.html et réalise l'assemblage lui-même — rien n'est publié sur claude.ai. Le canevas est rendu dans une iframe srcdoc en bac à sable (origine opaque, allow-scripts uniquement), la même posture d'isolation d'origine que la vue conversation emploie pour les maquettes UI en ligne ; dans le dashboard il est en lecture-et-export seulement (pas de sauvegarde en retour), et c'est un chemin distinct, au rayon d'impact plus faible, que la voie de rendu des artefacts de run (voir artifacts).
Lorsqu'une direction visuelle est réellement ouverte, le coder esquisse 2 à 4 plans de direction basse fidélité, émet une demande d'attention (decision_create, une Clarification) et attend que l'opérateur réponde dans la file de décisions Genesis après avoir vu les directions sur le dashboard — seul un humain la résout (séparation des devoirs). Le coder construit ensuite la direction choisie dans Main.dc.html. Les tâches de design sont dispatchées explicitement ou intégrées à un workflow ; le décomposeur de mission n'en émet pas de lui-même.
Atlassian : Jira et Confluence
Genesis lit et écrit dans le Jira et le Confluence du client — ses tickets, ses pages, son compte de service. Les lectures sont ordinaires. Les écritures sont des propositions : Genesis ne dépose jamais un commentaire, un temps passé, une transition ou une modification de page sur le système d'un client sans qu'un humain distinct ait d'abord approuvé cette écriture précise.
Deux niveaux peuvent posséder un site. Un locataire dispose d'une connexion Atlassian, utilisée par tout ce qui se trouve en dessous. Un produit — le niveau de regroupement sans dépôt git situé au-dessus des projets — peut au contraire pointer vers son propre site : son hôte, son compte de service, son jeton. Cela existe parce que le travail d'un même locataire peut couvrir plusieurs clients, et que le commentaire destiné au ticket d'un client ne doit jamais atterrir dans le Jira d'un autre.
Statut (2026-09) : le niveau produit est désactivé par défaut. La voie locataire est le comportement livré. Les sites de produit sont derrière la fonctionnalité
product-atlassian-sites(désactivée par défaut au niveau déploiement) et ne prennent effet que pour un produit explicitement lié. Un locataire sans produit lié n'acquiert aucun comportement nouveau.
1. Guide opérateur
1.1 Les trois fonctionnalités
Atlassian est contrôlé par trois entrées du catalogue de fonctionnalités, chacune
avec les deux niveaux habituels : un bit de déploiement dans les valeurs de release
(services.core.features.<clé>.enabled) et un interrupteur par locataire dans Paramètres →
Fonctionnalités. Ce ne sont plus des clés de configuration plateforme depuis la consolidation de
2026-09 : un config_set sur les anciens noms est désormais refusé et renvoie vers la fonctionnalité.
| Fonctionnalité | Défaut déploiement | Défaut locataire | Ce qu'elle contrôle |
|---|---|---|---|
atlassian | désactivé | activé | Toute la surface. Désactivée, chaque verbe refuse feature_disabled. |
atlassian-writes | désactivé | activé | Les verbes d'écriture uniquement. Les lectures continuent de fonctionner. |
product-atlassian-sites | désactivé | activé | Si la liaison propre d'un produit est honorée. |
Le défaut locataire est « activé » pour les trois : activer une fonctionnalité au niveau déploiement l'active donc pour chaque locataire qui ne s'en est pas retiré — exactement ce que donnait l'unique ligne de configuration plateforme. Un administrateur de locataire peut maintenant s'en retirer sans déploiement, et un interrupteur locataire illisible échoue en position FERMÉE (avec une demande d'attention) au lieu de supposer « activé ».
1.2 Lier le site du locataire
Une connexion par capacité (WorkItem pour Jira, KnowledgeBase pour Confluence), portant l'hôte et
l'adresse e-mail du compte agissant ; plus un identifiant — le jeton d'API de ce compte. Atlassian
Cloud s'authentifie en email:jeton : une connexion sans e-mail n'est donc pas une configuration
partielle, c'est un appel authentifié en tant que quelqu'un d'autre. Le résolveur la refuse au lieu de
l'envoyer.
1.3 Lier un produit à son propre site
product_atlassian_site_set (ou PUT /api/v1/products/{id}/atlassian-site) prend un hôte, un e-mail
agissant et un jeton d'API, stocke le jeton comme identifiant de portée produit, et y pointe le
produit. product_atlassian_site_get montre la liaison sans le jeton ;
product_atlassian_site_delete supprime les deux.
Trois propriétés méritent d'être connues avant d'en créer une :
- Le drapeau doit être activé d'abord. Créer une liaison pendant que le niveau est éteint est refusé : un produit lié ne retombe jamais sur le site du locataire, la liaison prendrait donc effet comme une panne.
- Désactiver le drapeau n'est pas un retour en arrière. Un produit lié avec le drapeau désactivé
refuse tous les appels Atlassian (
product_site_disabled). Le retour en arrière consiste à supprimer la liaison. - Le même hôte est autorisé, le même compte ne l'est pas. Un produit peut se trouver sur l'hôte Atlassian du locataire, à condition d'utiliser un compte différent avec son propre jeton. C'est tout l'objet de ce niveau : l'identifiant est résolu par identité, jamais par hôte, si bien que les deux ne peuvent jamais être confondus.
1.4 Ce que fait une écriture produit
Toute écriture vers le site propre d'un produit est mise en attente d'approbation humaine, quelle que soit la politique de la connexion du locataire. Un locataire qui a ouvert ses propres écritures n'a rien dit du système d'un autre client, et un consentement pour l'un n'est pas un consentement pour l'autre.
1.5 Approuver une écriture en attente
L'approbateur voit le contenu proposé et vers quel site il part — l'hôte et le compte agissant sont nommés sur la demande. Approuver exécute l'écriture ; rejeter l'abandonne.
Si le site a changé entre l'approbation et l'exécution — repointé, ré-identifié, ou compte agissant
remplacé — l'écriture est refusée, pas envoyée (park_scope_drift). Un humain a approuvé une
écriture précise vers un système précis ; cette approbation ne se transfère pas à un autre. Reproposez
l'écriture face à la liaison actuelle.
1.6 Lire un refus
| Réponse | Signification | Que faire |
|---|---|---|
feature_disabled | Un drapeau est désactivé. | L'activer. |
connection_missing | Pas de connexion, ou pas d'e-mail agissant dessus. | Configurer la connexion. |
connection_unavailable | La recherche elle-même a échoué — l'existence d'une connexion est inconnue. | Réessayer ; vérifier la base. |
credential_missing | Aucun identifiant ne porte cette identité. | Corriger la liaison. |
credential_unreadable | La ligne existe ; son secret est illisible (refusé, absent, ou plus déchiffrable). | Corriger le magasin de secrets ou sa politique. Réessayer n'aidera pas. |
credential_unavailable | Le magasin de secrets n'a pas répondu. | Réessayer. |
product_site_disabled | Ce produit est lié et le drapeau du niveau est désactivé. | Activer le drapeau, ou supprimer la liaison. |
atlassian_scope_indeterminate | L'appel n'a pas pu dire pour quel produit il agit, et ce locataire en lie au moins un. | Examiner la liaison de projet de l'appelant. |
awaiting_approval | L'écriture est en attente. Ce n'est pas un échec. | L'approuver ou la rejeter. |
park_scope_drift | Le site a changé après l'approbation de l'écriture. | Reproposer face à la liaison actuelle. |
La distinction entre credential_missing, credential_unreadable et credential_unavailable existe
parce que l'action suivante de l'opérateur diffère dans chaque cas, et parce qu'un unique « introuvable »
envoyait les gens recréer des liaisons qui étaient déjà correctes.
2. Architecture
2.1 Le site tient en trois en-têtes
Chaque appel Atlassian passe par un side-car par locataire. Le site atteint est décidé entièrement par trois en-têtes de requête — le jeton, l'e-mail agissant et l'URL de base. Rien du routage ne change entre la voie locataire et la voie produit ; seule change la ligne qui a fourni ces trois valeurs.
2.2 Une seule élection
Un résolveur unique élit la cible de chaque lecture, de chaque écriture contrôlée et de chaque rejeu approuvé, et le résultat qu'il renvoie est transmis à la fois au fil et au portail d'écriture. C'est important parce que le portail lit une politique d'approbation sur une connexion : si le portail élisait sa propre ligne pendant que le client en élisait une autre, il pourrait décider selon la politique d'un site tandis que l'écriture partirait vers l'hôte d'un autre. Une seule élection rend cela irreprésentable.
2.3 La portée : quatre états, dont deux sont opposés
Un appel déclare sa portée. Tenant est la surface opérateur, locataire par construction. Product
nomme un produit. Unbound signifie que la portée a été déterminée et que le projet n'appartient à
aucun produit lié — il utilise le site du locataire et ne refuse jamais. Indeterminate signifie que la
portée n'a pas pu être déterminée, et il refuse : un appel incapable de dire de quel Jira il parle ne
doit pas deviner. Une lecture échouée est toujours Indeterminate, jamais Unbound — confondre les deux
est précisément ainsi qu'un incident de base de données devient une écriture silencieuse vers le mauvais
site.
2.4 Le fusible
Chaque refus introduit par le niveau produit est conditionné à l'existence d'au moins une liaison chez le locataire. Un locataire qui n'a pas adopté le niveau — y compris lorsqu'une portée d'appel est indéterminée — se comporte exactement comme avant l'existence du niveau. Il n'y a aucun site de produit à se tromper, donc la réponse historique n'est pas seulement sûre : c'est la seule correcte.
2.5 Lié veut dire lié
Dès qu'un produit porte une liaison, il n'y a aucun repli vers le site du locataire. Drapeau manquant, identifiant manquant, identifiant pendant, secret illisible, e-mail agissant vide : tous refusent avant tout appel réseau. Un repli enverrait l'écriture d'un client dans le Jira d'un autre, soit exactement le seul résultat que ce niveau existe pour rendre impossible.
2.6 Les identifiants se résolvent par identité
L'identifiant d'un produit est recherché par (produit, identifiant) — jamais par (hôte, type). C'est
ce qui permet à un produit de se trouver sur l'hôte du locataire avec un compte de service différent, et
ce qui empêche une liaison de s'authentifier avec l'identifiant d'un autre produit ou du locataire. La
réciproque tient aussi : le parcours d'identifiants du locataire exclut explicitement les lignes de
produit, si bien que le jeton d'un produit ne peut jamais l'emporter dans une recherche locataire.
2.7 Mise en attente et rejeu
Une écriture en attente conserve les coordonnées nécessaires à son exécution ultérieure, plus une empreinte du site pour lequel elle a été autorisée — hôte, identifiant, compte agissant, et pour un produit la version de ligne de sa liaison. À l'approbation, le site est résolu à nouveau et comparé à l'empreinte ; une différence refuse au lieu d'envoyer. Une empreinte ne compare que les parties qu'elle porte réellement, de sorte que les approbations créées avant l'existence de l'empreinte se rejouent exactement comme auparavant.
Les mises en attente produit portent en outre leur propre discriminant de source. Un binaire antérieur au niveau produit lit une telle mise en attente comme étrangère et ne la rejoue jamais — après un retour arrière, la proposition est abandonnée plutôt qu'envoyée vers le site du locataire.
2.8 Supprimer des choses
Les liaisons sont protégées par RESTRICT dans les deux sens. Supprimer un produit qui porte encore
une liaison est refusé et le dit. Supprimer l'identifiant vers lequel une liaison pointe est refusé
aussi : une liaison qui se lit comme liée ne peut donc jamais pointer vers un identifiant qui n'existe
plus. L'ordre de démontage est par conséquent : délier le site (ce qui supprime son identifiant), puis
supprimer le produit.
2.9 Ce qui est observable
Chaque résolution est comptée selon le niveau dont le site a été élu (tenant ou product), et chaque
refus selon son code, de sorte qu'un opérateur voit à la fois l'adoption du niveau et ses modes de
défaillance. Chaque appel enregistre une ligne d'attribution nommant le type d'identifiant qui l'a servi
— un appel produit attribué comme un appel locataire serait un mensonge sur la piste d'audit.
Reviews et évaluation Ghost
Ce que c'est
La couche qualité :
- Reviews — des portes d'approbation humaines / agents sur les changements.
- Le Review Engine — un analyseur automatisé, domaine par domaine.
- L'évaluation Ghost — des tests A/B hors ligne de prompts et de modèles face à des candidats fantômes (shadow candidates).
Surface opérateur
- Reviews —
review_create(CodeReview, DesignReview, SecurityReview, ComplianceReview, TaskReview, General),review_list,review_get,review_pending,review_assign,review_approve,review_reject,review_cancel,review_report_generate. - Review Engine —
review_engine_start,review_engine_domains,review_engine_status,review_engine_findings,review_engine_run_sweep,review_engine_full_system, plus les outils de planification et de soumission ; et la review UX (ux_review_*). - Ghost —
ghost_evaluation_list/_get/_stats,ghost_evaluation_trigger,ghost_evaluate_from_history,ghost_promotion_candidates,ghost_prompt_history.
REST : ReviewsController, ReviewEngineController, UxReviewController, GhostEvaluationController.
Comment ça fonctionne
Les Reviews sont persistées sous forme de ReviewRecords liés à l'entité examinée et peuvent bloquer l'achèvement d'une Mission à une porte de contrainte (constraint gate). Le Review Engine exécute une ReviewEngineSession qui énumère les cibles du Project et produit des ReviewEngineFindings via une analyse LLM cible par cible, chaque domaine étant routé à travers son Preset de call site ReviewEngine:{Domain} (avec des planifications pour les balayages récurrents). L'évaluation Ghost rejoue des prompts réels ou synthétiques face à des modèles fantômes (shadow models), en les notant (GhostEvaluation, PromptEvolution, LearningPrompt) afin que de meilleurs prompts / modèles puissent être remontés comme candidats à la promotion (promotion candidates) sans toucher au trafic en direct.
Fleet et Profiles
Ce que c'est
Configuration en couches pour la coder Fleet — des profiles réutilisables (plafonds de modèle, coder tool, env, bascules MCP) qui se lient à des projets, avec des surcharges, se résolvant en une configuration effective unique par projet.
Surface opérateur
- Profiles —
fleet_profile_list/_get/_create/_update/_delete/_cloneet l'env de profile (fleet_profile_env_set/_remove/_list). - Liaisons et surcharges —
fleet_project_bind,fleet_project_unbind,fleet_project_override,fleet_project_override_env_set/_remove. - Résolution —
fleet_resolveetfleet_resolve_env(affichent le résultat fusionné et l'origine de chaque valeur). - Contrôles de coder associés —
coder_spawn,coder_list,coder_killet les coder tools à la demande.
Côté REST, ce sont FleetProfileController / CoderFleetController.
Comment ça marche
FleetProfileRecord réside dans le control-plane et prend en charge l'héritage (un profile peut étendre un parent) ; ProjectFleetBinding rattache un profile à un projet et superpose par-dessus des surcharges propres au projet. fleet_resolve fusionne valeurs par défaut du système → profile parent → profile → surcharges du projet et renvoie FieldSources afin que vous puissiez voir exactement quelle couche a défini chaque valeur — la même configuration résolue qui régit la façon dont les coders sont lancés (voir Agents) ainsi que l'environnement et les capacités MCP dont ils disposent.
Cheatsheet : états missions, tâches, revues
Lookup rapide. Pour les explications longues, voir États du cycle de vie.
Mission
Le tableau de bord affiche les statuts de mission tels quels — des noms bruts en anglais comme InProgress ou PendingReview, pas de libellés traduits.
| État | Terminal | Sens |
|---|---|---|
| AwaitingApproval | non | Proposée depuis une conversation ; attend votre approbation avant d'entrer dans la file. |
| Pending | non | Créée ; la planification n'a pas encore démarré. |
| Researching | non | Recherche préalable à la décomposition en cours. |
| Planning | non | La mission est en cours de planification (recherche + décomposition). |
| Decomposing | non | Le planificateur produit activement le plan de tâches. |
| Decomposed | non | Plan de tâches prêt ; attend votre approbation avant l'envoi des tâches. |
| InProgress | non | Tâches envoyées et en exécution. |
| PendingReview | non | Attend votre revue avant de se terminer. |
| Paused | non | Mise en pause par vous. Reprise possible — cliquez Reprendre. |
| PendingOperatorDecision | non | La mission a posé une question et attend votre réponse sur la page mission ; rien n'avance tant que vous ne répondez pas. |
| Completed | oui | Terminée. Une seule sortie sanctionnée — voir plus bas. |
| Failed | oui | Arrêtée sur une erreur. |
| Cancelled | oui | Vous l'avez arrêtée. |
Toutes les missions ne passent pas par tous les états. Le chemin nominal est Pending → Planning → InProgress → PendingReview → Completed (ou Failed), avec Paused comme état latéral repris à volonté.
Boutons de la page mission : Pause (pendant InProgress), Reprendre (pendant Paused), Annuler la mission (affiché sauf mission Completed ou Cancelled), Approuver le plan de décomposition (pendant Decomposed ou AwaitingApproval).
Deux règles à connaître :
- Completed est terminal, à une exception près. Démarrer un nouveau run sur une mission terminée la rouvre en InProgress. Rien d'autre ne fait sortir une mission de Completed.
- Les changements d'état illégaux sont refusés, pas ignorés. Si vous (ou un outil) demandez une transition que l'état courant n'autorise pas, la requête échoue et l'erreur vous dit quelles actions sont permises. Un changement refusé ne se présente jamais comme un succès.
Issues d'un run
Les runs appartiennent aux missions workflow — un run par exécution de workflow, sur sa propre branche (voir États du cycle de vie).
| Issue | Terminal | Sens |
|---|---|---|
| Proposed | non | Le seul état ouvert : les changements du run attendent sur leur branche votre décision. Hors groupe concurrent, un seul run peut être ouvert à la fois. |
| Accepted | oui | Vous l'avez accepté ; le run a fusionné dans la mission et produit un changement. |
| Rejected | oui | Décliné — écarté via le verbe agent, ou rejeté automatiquement quand un frère concurrent a été accepté. La branche du run est supprimée ; rien n'a atterri. |
| Superseded | oui | Remplacé par un run plus récent ; n'est plus en jeu. |
Tâche
Statuts des tâches de code, tels qu'ils apparaissent dans les listes de tâches et au sein d'une mission :
| Statut | Terminal | Sens |
|---|---|---|
| Pending | non | Approuvée, en file ; pas encore confiée à un coder. |
| Dispatched | non | Confiée à un coder ; l'exécution n'a pas encore démarré. |
| InProgress | non | Un coder travaille. |
| UsageLimitWait | non | En pause sur une limite d'usage du fournisseur. Pas une erreur — elle reprend seule quand la fenêtre de quota se rouvre. |
| Completed | oui | Faite ; résultat sur le miroir de revue. |
| CompletedNoPush | oui | Le coder a terminé proprement mais n'avait aucun changement à pousser. |
| TurnLimitReached | oui | Le coder a épuisé son budget de tours avant de finir. La tâche peut reprendre avec des tours supplémentaires, là où elle s'était arrêtée. |
| Failed | oui | Plantée. Voir le log de tâche ; le bouton ↻ (« Réessayer la tâche ») la remet en Pending pour une nouvelle tentative. |
| Cancelled | oui | Arrêtée par vous ou par l'annulation de mission. |
Revue
Les statuts de revue s'affichent bruts, comme dans les autres tableaux (InReview, pas « In review ») :
| État | Terminal | Sens |
|---|---|---|
| Pending | non | Revue créée ; personne ne l'a encore prise. |
| InReview | non | La revue est ouverte et en cours d'examen. |
| Approved | oui | Vous avez approuvé. Push vers l'origine en vol ou fait. |
| Rejected | oui | Abandonnée. La branche reste sur le miroir mais ne part jamais. |
| Cancelled | oui | Annulée avant décision. Rien n'est poussé. |
Demander des modifications est un bouton, pas un état : sur la carte de décision d'une revue de mission (tableau de bord Revues), vous pouvez Approuver, Demander des modifications ou Rejeter — l'enregistrement de revue, lui, ne porte jamais que l'un des cinq états ci-dessus.
Finding Review Engine
Les findings au sein d'une revue ont leur propre statut :
| Statut | Sens |
|---|---|
| Open | Frais, pas trié. |
| Investigating | Vous l'avez marqué comme en cours d'examen. |
| Resolved | Réglé (à la main ou par une tâche coder de suivi). |
| Dismissed | Vous avez décidé que ce n'était pas un vrai problème. |
| Deferred | Repoussé à un run futur. |
Demande d'attention
Les demandes d'attention n'ont pas un état à proprement parler — elles sont soit en cours (attendent un humain) soit résolues (un humain a répondu). Elles apparaissent sur la page mission et déclenchent un email.
Types que vous verrez :
- Approval — « approuvez ce plan/changement pour continuer ».
- Decision — « choisissez une de ces options ».
- Input — « donne-moi une chaîne / une valeur à utiliser ».
- Clarification — « votre brief était ambigu ; merci de clarifier ».
- Error — « quelque chose a échoué ; intervenez ».
Catalogue de modèles
Modèles disponibles en v1, par fournisseur. Les prix ci-dessous sont les chiffres que la plateforme utilise pour sa propre comptabilité de coûts — la facture de votre fournisseur fait foi.
Anthropic Claude
Facturation au token. Genesis tarifie les modèles Anthropic par famille et découvre les modèles eux-mêmes dynamiquement via l'API Anthropic : tout modèle claude-* servi par l'API est accepté et facturé aux tarifs de sa famille. Quand une nouvelle version apparaît — claude-opus-4-8 par exemple — elle fonctionne sans mise à jour de la plateforme et hérite du tarif et de la fenêtre de contexte de la famille Opus.
| Famille | Entrée ($/MTok) | Sortie ($/MTok) | Contexte | Pour quoi |
|---|---|---|---|---|
| Fable | 10 $ | 50 $ | 1M tokens | Le travail le plus dur — un niveau au-dessus d'Opus. |
| Opus | 5 $ | 25 $ | 200K | Raisonnement complexe, architecture, stratégie. |
| Sonnet | 3 $ | 15 $ | 200K | Équilibré. Code, analyse, tâches générales. |
| Haiku | 1 $ | 5 $ | 200K | Le plus rapide et le moins cher. Tâches simples, gros volume. |
Les IDs de modèle ressemblent à claude-fable-5, claude-opus-4-7, claude-sonnet-4-6, claude-haiku-4-5-20251001.
Sauf changement de votre part, les conversations tournent sur Claude Opus 4.7 (claude-opus-4-7).
Synthetic.new
Forfaitaire via abonnement — pas de prix au token. Les IDs de modèle portent le préfixe hf:. Le jeu enregistré :
| Modèle | ID |
|---|---|
| MiniMax M2.5 | hf:MiniMaxAI/MiniMax-M2.5 |
| Qwen 3.6 27B | hf:Qwen/Qwen3.6-27B |
| Kimi K2.6 | hf:moonshotai/Kimi-K2.6 |
| NVIDIA Nemotron 3 Super 120B | hf:nvidia/NVIDIA-Nemotron-3-Super-120B-A12B-NVFP4 |
| GLM 4.7 | hf:zai-org/GLM-4.7 |
| GLM 4.7 Flash | hf:zai-org/GLM-4.7-Flash |
| GLM 5.1 | hf:zai-org/GLM-5.1 |
| GPT OSS 120B | hf:openai/gpt-oss-120b |
| Qwen3 Coder 480B | hf:Qwen/Qwen3-Coder-480B-A35B-Instruct |
| Qwen 3.5 397B | hf:Qwen/Qwen3.5-397B-A17B |
Le catalogue complet est récupéré en direct depuis l'API Synthetic ; le sélecteur de modèles peut donc montrer plus que cette liste.
Autres fournisseurs
Si votre déploiement a connecté GitHub Copilot ou JetBrains Junie (avec votre propre compte), leurs modèles apparaissent dans le sélecteur de modèles comme leurs propres groupes de fournisseur. Ils sont décomptés sur ces abonnements — pas de prix au token là non plus.
Choisir en 30 secondes
- Aucune idée de quoi prendre → gardez les défauts.
- Les problèmes les plus durs, ou un très grand contexte → Fable (contexte 1M tokens ; préparez-vous à la facture).
- Économe → forfait Synthetic ; Qwen3 Coder 480B est le spécialiste code.
- Gros volume, travail mécanique → Haiku.
Défauts
Si vous ne configurez rien, les conversations utilisent claude-opus-4-7. Les presets de modèle des autres rôles de la plateforme (décomposition, revue, et le reste) sont initialisés par la plateforme ; la page Configuration LLM montre — et permet de modifier — ce que votre tenant utilise réellement. C'est cette page qui fait foi, pas celle-ci.
Types de notifications
Ce qui peut se déclencher, quand, sur quel canal.
| Évènement | Tableau de bord | Mutable | Notes | |
|---|---|---|---|---|
| Bienvenue / activation | oui | — | non | Envoyé une fois quand le tenant est provisionné. |
| Mission décomposée (en attente d'approbation) | oui | oui | non | Sujet : nom de mission + nombre de tâches. |
| Mission terminée | oui | oui | oui | Notification d'état final. |
| Mission échouée | oui | oui | non | La première tâche défaillante est nommée. |
| Mission annulée | — | oui | — | Pas d'email (c'est vous qui avez lancé). |
| Tâche démarrée | — | oui | — | État en direct dans le tableau. |
| Tâche terminée | — | oui | oui | Email par tâche off par défaut. |
| Tâche échouée | oui | oui | oui | Mutable ; le niveau mission tire toujours. |
| Tâche bloquée / demande d'attention | oui | oui | non | Porte le texte de la question. |
| Revue créée | — | oui | — | Icône cloche dans le tableau. |
| Push de revue vers origine échoué | oui | oui | non | Erreur côté push ; action requise. |
| Seuil de coût | — | oui | oui | L'intégration email est un follow-up v2. |
| Résumé heures silencieuses | oui | — | oui | Digest quotidien optionnel. |
Mutable veut dire que vous pouvez couper depuis Settings → Notifications. Les non-mutables sont obligatoires pour la sûreté du produit (vous devez pouvoir être notifié pour approuver un plan ; rater un email d'activation vous verrouille dehors, etc.).
Catalogue complet des évènements
Le tableau ci-dessus décrit les évènements d'une session normale. L'ensemble complet des types d'évènements que la plateforme peut émettre est plus large — regroupé ici, une ligne chacun. La plupart se déclenchent sur le fil du tableau de bord ; un sous-ensemble vous écrit aussi par email.
Décisions
DecisionCreated— une décision a besoin de vous.DecisionApproved/DecisionRejected— une décision a été approuvée / refusée.
Missions
MissionUpdate— une mission a changé de statut.MissionDecomposed— un plan est prêt (titre + nombre de tâches).MissionCompleted— une mission a atteint son état final.MissionTasksModified— la liste des tâches d'une mission a changé.MissionLinked— une mission a été liée à d'autres travaux.MissionDeleted— une mission a été supprimée.
Tâches
TaskStatusChanged— une tâche est passée à un nouveau statut.TaskCompleted/TaskFailed— une tâche a fini / échoué.TaskReady— une tâche est prête à tourner.TaskAwaitingIntegration— la branche d'une tâche finie attend d'être intégrée.TaskRecovered— une tâche a été récupérée après une interruption.TaskLinked— une tâche a été liée à d'autres travaux.
Revues
ReviewCreated— une revue est prête à être lue.ReviewAssigned— une revue a été assignée.ReviewCompleted— une revue a atteint un verdict.
Coûts, quotas et fournisseurs
CostUpdate— un point de dépense (coût estimé + modèle).RateLimitUpdate— une famille de modèles approche ou touche une limite de débit.QuotaWarning— les crédits du fournisseur s'épuisent.ProviderFailover— un appel a basculé d'un fournisseur vers son secours.AllProvidersFailed— aucun fournisseur n'a pu prendre l'appel.
Projets et onboarding
ProjectCloneCompleted/ProjectCloneFailed— le clone de votre dépôt a fini, ou pas.ProjectDiscoveryCompleted— la découverte du projet a fini.OnboardingProgress/OnboardingComplete— l'onboarding du projet a avancé / fini.ConversationEvent— de l'activité dans une conversation.
Recherche et intelligence
ResearchPhaseCompleted/ResearchFailed— une phase de recherche a fini / la recherche a échoué.KnowledgeSourceIngested— une source de connaissance a été ingérée.KnowledgeDiscoveryCompleted— la découverte de connaissances a produit des suggestions.IntelligenceBriefingGenerated— un briefing d'intelligence est prêt.TrendAlertRaised— une tendance suivie a franchi un seuil.
Tickets de support
SupportCaseReceived— nous avons reçu votre ticket.SupportCaseTransitioned— votre ticket a changé d'état.SupportCaseConfirmedBug— confirmé comme bug.SupportCaseAwaitingReporter— nous vous avons posé une question et attendons.SupportCaseVerificationRequested— un correctif est livré ; merci de vérifier.SupportCaseSlaReminder/SupportCaseSlaTimeout— une réponse est attendue / le ticket s'est auto-fermé sans réponse.SupportCaseClosed— votre ticket est fermé, avec un verdict.
Revue automatique
ReviewEngineSessionStarted/ReviewEngineTargetReviewed/ReviewEngineFindingDiscovered/ReviewEngineSessionCompleted/ReviewEngineFullSystemCompleted— le revueur automatique a démarré, revu une cible, trouvé quelque chose, fini une session, fini un balayage complet.UxReviewFinding/UxReviewPageReviewed/UxReviewSweepCompleted— la même forme pour le revueur UX.
Coders et flotte (surtout côté opérateur)
CoderStarted/CoderStopped— un coder a démarré / s'est arrêté.CoderScaleBlocked— la flotte a atteint son plafond global.CoderHealthIssue— un coder a signalé un problème de santé.FleetConfigChanged/FleetDiscoveryCompleted— la config de flotte a changé / la découverte d'images a fini.
Gouvernance et conformité (côté opérateur)
GovernanceAlertCreated/GovernanceAlertResolved— une alerte de gouvernance s'est ouverte / fermée.IncidentCreated/IncidentTimelineOverdue— un incident de conformité s'est ouvert / une phase est en retard.ComplianceDocumentExpiring/ComplianceAssessmentCompleted/ComplianceReportGenerated— évènements de documents, d'évaluations et de rapports.
Agents permanents (seulement si activés pour votre tenant)
AgentMissionUpdate/AgentMilestone/AgentRiskFlagged/AgentAttention— un agent permanent a signalé un avancement, un jalon, un risque, ou a besoin de vous.
Internes de la plateforme (surfaces opérateur — vous les verrez rarement)
SystemEvent,ConfigChanged,ScenarioFailed,MaintenanceCycleCompleted,CycleCompleted,ReportCompiled,PrismReportGenerated,ComparisonCompleted,CharterStatusChanged,MatterVerificationStarted,DesignConcernUpdated,DesignAlertRaised,ScaffoldingPlanGenerated,ScaffoldingExecuted,PreviewStatusChanged,PreviewReady,PreviewFailed— évènements de cycle de vie des surfaces opérateur listées dans Pages que vous pouvez ignorer.
Sujets d'email
Tout le courrier système utilise des sujets préfixés [Genesis]. Exemple :
[Genesis] Mission Decomposed: "Add /healthz endpoint to api/" (4 tasks)
Ce préfixe [Genesis] est constant (le courrier du revueur automatique utilise [Genesis Review]) — utile pour les filtres Gmail ou règles Outlook.
Adresse expéditeur
Sortants : update@etiakorp.com. On ne rotate pas. Les réponses entrantes atterrissent dans notre boîte support mais ne pilotent pas d'action dans le produit — voir Ouvrir un ticket de support pour le bon chemin entrant.
Quand les canaux divergent
L'email fait la queue ; le tableau est en direct. Si vous acquittez une demande d'approbation via le tableau dans une fenêtre rapide, l'email arrive quand même. Le lien dans l'email pointe sur la bonne page de toute façon — il ne renvoie pas l'action.
Intégration webhook / Slack
Pas en v1. Si vous voulez des notifications type pagination vers Slack ou PagerDuty, ouvrez un ticket de support — on suit la demande.
Fonctionnalités activables
Chaque capacité activable de Genesis est une fonctionnalité d'un catalogue unique défini dans le code. Cette page est générée depuis ce catalogue ; c'est la liste complète. Il n'existe aucun autre registre d'interrupteurs.
Une fonctionnalité a deux niveaux, et l'état effectif est toujours le ET des deux :
- Niveau déploiement — la fonctionnalité existe-t-elle dans ce déploiement. Défini dans les
valeurs de release sous
services.core.features.<cléValeurs>.enabled(le chart le traduit en variable d'environnementFeatures__<clé>__Enabled). Le changer est un changement GitOps : une fusion des valeurs, puis le prochain déploiement. Une fonctionnalité éteinte à ce niveau apparaît verrouillée chez chaque locataire et ne peut pas être allumée depuis le produit. - Niveau locataire — ce locataire l'a-t-il activée. Les administrateurs du locataire la
basculent à chaud depuis Paramètres → Fonctionnalités (
/settings/features) ou avec l'outil MCPfeature_set; le changement est audité sousFeature:<clé>et prend effet en quelques secondes. Tant qu'un locataire n'a jamais touché une fonctionnalité, sa valeur locataire par défaut s'applique. Un déploiement peut remplacer cette valeur pour tous ses locataires avecservices.core.features.<cléValeurs>.tenantDefault.
Certaines lignes n'ont pas d'interrupteur locataire :
- Déploiement seul — la fonctionnalité est un rail à l'échelle de la plateforme (un coupe-circuit, un fournisseur de runtime) ; l'écran locataire montre son état en lecture seule.
- Redémarrage requis — la valeur est consommée au démarrage du service, un basculement à chaud ne pourrait pas prendre effet. La ligne est en lecture seule et le seul levier est la release.
Quelques fonctionnalités de la voie d'exécution peuvent en plus être gelées à chaud : une entrée
de configuration plateforme valant false sous l'ancien chemin de la fonctionnalité ferme la porte
sans déploiement. Le levier est à sens unique — il ne peut que fermer une porte que le déploiement
a ouverte, jamais ouvrir une porte qu'il a fermée — et dégeler consiste à effacer l'entrée, pas à
écrire true.
Lire les tableaux
| Colonne | Signification |
|---|---|
| Clé | La clé stable du catalogue. C'est le segment de Features__<clé>__Enabled et l'argument de feature_set. |
| Clé valeurs | La clé en camelCase sous services.core.features dans les valeurs de release. |
| Interrupteur locataire | Oui — les administrateurs du locataire peuvent basculer ; Déploiement seul — lecture seule dans l'écran locataire ; Redémarrage requis — lecture seule, nécessite un déploiement. |
| Défaut déploiement | Ce que le niveau déploiement vaut quand les valeurs de release ne disent rien. Les environnements déployés le fixent toujours explicitement. |
| Défaut locataire | Ce qu'un locataire obtient avant que quiconque touche l'interrupteur. |
Refus que vous pouvez rencontrer : feature.deploy-disabled (la fonctionnalité est éteinte au niveau
déploiement — rien qu'un administrateur locataire puisse faire), feature.not-togglable (la ligne
n'a pas d'interrupteur locataire), et le résultat feature_disabled qu'un outil ou un point d'accès
renvoie quand sa fonctionnalité est éteinte pour le locataire.
Intégrations
| Clé | Nom | Ce qu'elle contrôle | Clé valeurs | Interrupteur locataire | Défaut déploiement | Défaut locataire | Notes |
|---|---|---|---|---|---|---|---|
atlassian | Intégration Atlassian | Le Jira et le Confluence du client : chaque lecture et écriture atlassian_*. Éteint, chaque verbe refuse feature_disabled. | atlassian | Oui | désactivé | activé | Ancien chemin Atlassian:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
atlassian-writes | Écritures Atlassian | Les verbes d'écriture Atlassian soumis à approbation (commentaires, temps passé, transitions, modifications de page). Les lectures continuent de fonctionner quand c'est éteint. | atlassianWrites | Oui | désactivé | activé | Ancien chemin Atlassian:WriteEnabled toujours honoré ; Se ferme si le bit locataire est illisible |
product-atlassian-sites | Sites Atlassian de portée produit | Honorer le site Atlassian propre à un produit (hôte, compte agissant, jeton) au lieu de la connexion du locataire. Un produit lié avec cette fonctionnalité éteinte refuse les appels Atlassian plutôt que de se rabattre. | productAtlassianSites | Oui | désactivé | activé | Ancien chemin Atlassian:ProductSites:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
gitlab-customer-integration | Intégration GitLab du client | Le GitLab propre au locataire : la voie client qui clone les dépôts privés et ouvre des merge requests dans le groupe du client. Provisionner une voie locataire l'active pour ce locataire. | gitlabCustomerIntegration | Oui | désactivé | activé | Ancien chemin GitLab:CustomerIntegration:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
gitlab-attribution | Attribution des appels GitLab | Enregistrer quelle identité a effectué chaque appel GitLab (le registre des tentatives derrière les vues identité et quota). | gitlabAttribution | Oui | désactivé | activé | Ancien chemin GitLab:Identity:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
mr-enrichment | Enrichissement des demandes de fusion | Enrichir une demande de fusion avec une description générée et le contexte de revue au moment de son ouverture. | mrEnrichment | Oui | activé | activé | Ancien chemin MrEnrichment:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
Surfaces
| Clé | Nom | Ce qu'elle contrôle | Clé valeurs | Interrupteur locataire | Défaut déploiement | Défaut locataire | Notes |
|---|---|---|---|---|---|---|---|
mcp-apps | Widgets MCP Apps | Annote les résultats et définitions d'outils MCP avec des ressources de widgets interactifs (carte de la file de décisions) pour les hôtes qui prennent en charge l'extension MCP Apps. Éteint = totalement inactif : aucune métadonnée n'est émise nulle part. | mcpApps | Oui | désactivé | activé | Ancien chemin McpApps:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
mcp-apps-generic | Carte générique MCP Apps | Affiche les résultats des outils MCP en lecture seule sous forme de carte générique (vue tableau, détail ou état) dans les hôtes qui prennent en charge l'extension MCP Apps, en plus de la carte de la file de décisions. Nécessite mcp-apps ; éteint = seule la carte de la file de décisions est annotée. | mcpAppsGeneric | Oui | désactivé | désactivé | — |
run-artifacts | Artefacts d'exécution | Publication et liaison des artefacts d'exécution de workflow (outils run_artifact_*, l'API des artefacts et les liens de partage). | runArtifacts | Oui | désactivé | activé | Ancien chemin Artifacts:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
ops-read-plane | Plan de lecture ops | La surface d'exploitation en lecture seule (outils ops_* et l'API ops) qui répond aux questions cluster, pods et journaux sur l'empreinte propre du locataire. | opsReadPlane | Oui | désactivé | activé | Ancien chemin Ops:ReadPlane:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
operator-browse-live-view | Vue en direct de navigation opérateur | Afficher la vue noVNC en direct d'une session de navigation sur le tableau de bord opérateur, et servir le chemin de proxy correspondant. Désactivé, les sessions s'exécutent toujours et leurs artefacts sont collectés ; seule la fenêtre en direct est absente. | operatorBrowseLiveView | Déploiement seul | désactivé | — | — |
operator-browse-input-lock | Verrou de saisie de navigation opérateur | Permettre à un opérateur de prendre le contrôle exclusif de la saisie d'une session de navigation en direct, verrouillant l'agent pendant qu'il pilote. Nécessite la vue en direct. | operatorBrowseInputLock | Déploiement seul | désactivé | — | — |
design-system-v2 | Système de design v2 | Activer la feuille de style du système de design v2 et les panneaux qui lui sont rattachés dans tout le tableau de bord. Désactivé, le tableau de bord rend la v1 exactement comme avant ; la feuille v2 est inerte plutôt qu'absente. | designSystemV2 | Déploiement seul | désactivé | — | Ancien chemin Genesis:DesignSystem:V2Enabled toujours honoré |
Missions et exécutions
| Clé | Nom | Ce qu'elle contrôle | Clé valeurs | Interrupteur locataire | Défaut déploiement | Défaut locataire | Notes |
|---|---|---|---|---|---|---|---|
standing-agents | Agents permanents | Les agents permanents autonomes (orchestration stratégique, conformité, par projet, par produit) tournent pour ce locataire : le répartiteur les cadence et les amorçages les créent. Éteint, plus aucun tick ni amorçage ; les agents existants restent en place mais inactifs. | standingAgents | Oui | activé | désactivé | Ancien chemin AgentDispatcher:Enabled toujours honoré |
mission-runs | Exécutions de mission | La voie des exécutions de mission : créer une exécution de workflow comme unité soumise à acceptation, qu'elle soit lancée sur une mission existante (mission_run_start) ou avec une nouvelle mission (workflow_invoke natif). | missionRuns | Oui | désactivé | activé | Ancien chemin Workflows:MissionRuns:StartEnabled toujours honoré ; Gel à chaud : un false en configuration plateforme sous ce chemin ferme la porte ; Se ferme si le bit locataire est illisible |
run-executor | Exécuteur d'exécutions | Fait avancer les exécutions de workflow de ce locataire : le balayage des missions ramasse aussi les missions portant une exécution ouverte (quel que soit le statut de la mission), répartit leurs tâches d'exécution sur la voie dédiée et intègre chacune sur sa branche d'exécution. Éteint, ce locataire revient au balayage historique piloté par le statut — les exécutions ouvertes cessent d'avancer ; les autres locataires ne sont pas affectés. | runExecutor | Oui | activé | activé | Ancien chemin Workflows:Runs:ExecutorEnabled toujours honoré ; Gel à chaud : un false en configuration plateforme sous ce chemin ferme la porte ; Se ferme si le bit locataire est illisible |
agent-driven-missions | Missions pilotées par agent par défaut | Les missions créées sans voie explicite — le formulaire Créer une mission du tableau de bord SANS workflow attaché, et les appels d'API qui omettent useAgentDispatcher — tournent sur la voie MissionAgent au lieu du balayage classique de l'orchestrateur. Éteint (par défaut) = voie classique ; chaque mission peut encore s'y inscrire explicitement. N'affecte pas les missions attachées à un workflow ni créées via MCP, toujours classiques/natives. | agentDrivenMissions | Oui | activé | désactivé | Ancien chemin Missions:AgentDriven:Enabled toujours honoré |
post-task-verification | Vérification post-tâche | Après l'intégration d'une tâche de codage, lancer la tâche système de vérification (VERDICT VERIFIED ou FAILED, sans approbation) avant que la mission n'avance. | postTaskVerification | Oui | activé | activé | Ancien chemin Missions:Verification:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
run-native-invoke | Invocation en voie native | Matérialiser une invocation de flux comme une exécution sur la voie native plutôt qu'en tâches en ligne. Combinée par ET avec mission-runs : les deux doivent être actives. | runNativeInvoke | Oui | désactivé | activé | Ancien chemin Workflows:Invoke:RunNative toujours honoré ; Se ferme si le bit locataire est illisible |
post-task-validation | Validation post-tâche | Valider le résultat d'une tâche de codage après le passage du codeur, avant de la considérer comme terminée. | postTaskValidation | Oui | activé | activé | Ancien chemin PostTaskValidation:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
post-task-validation-tests | Tests en validation post-tâche | Exécuter les tests du projet dans le cadre de la validation post-tâche. Désactivée, la validation s'exécute mais sans lancer les tests. | postTaskValidationTests | Oui | activé | activé | Ancien chemin PostTaskValidation:RunTests toujours honoré ; Se ferme si le bit locataire est illisible |
auto-regression-tests | Tests de régression automatiques | Générer un test de régression pour un défaut corrigé, afin que la même panne ne puisse pas revenir inaperçue. | autoRegressionTests | Oui | désactivé | activé | Ancien chemin AutoRegressionTests:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
pre-review-acceptance | Acceptation avant revue | Exécuter la passe d'acceptation avant la revue plutôt qu'après, afin qu'un changement inacceptable n'atteigne jamais un relecteur. | preReviewAcceptance | Oui | désactivé | activé | Ancien chemin Acceptance:PreReview:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
run-target-provisioning | Provisionnement de cible d'exécution | Provisionner un environnement réel pour valider une exécution. Chaque exécution coûte de l'argent et de la capacité cluster : chaque locataire peut donc la désactiver. | runTargetProvisioning | Oui | désactivé | activé | Ancien chemin Acceptance:RunTargetProvisioning:LiveEnabled toujours honoré ; Se ferme si le bit locataire est illisible |
proposal-accept-starts-run | Accepter une proposition démarre une exécution | Démarrer une exécution de mission dès qu'une proposition est acceptée, au lieu de laisser un opérateur la démarrer. Désactivé, l'acceptation enregistre la décision et rien d'autre ne bouge. | proposalAcceptStartsRun | Oui | désactivé | activé | Ancien chemin Missions:ProposalAccept:StartRun toujours honoré ; Se ferme si le bit locataire est illisible |
agentic-decomposition | Décomposition agentique des missions | Décomposer une mission via la boucle de sous-agents agentique. Désactivé, chaque mission est confiée à une décomposition gérée par l'opérateur via une demande d'attention — le coupe-circuit lorsque la voie agentique régresse. | agenticDecomposition | Oui | activé | activé | Ancien chemin Decomposition:UseAgenticMcp toujours honoré ; Se ferme si le bit locataire est illisible |
reaction-shadow-mode | Mode fantôme du moteur de réaction | Évaluer les demandes d'attention mais SUPPRIMER toute action que le moteur de réaction prendrait, en émettant le flux de jugement à la place. À l'échelle de la plateforme par conception : c'est ainsi qu'un changement de politique est observé avant d'être approuvé, d'où un réglage au déploiement uniquement. | reactionShadowMode | Déploiement seul | désactivé | — | Ancien chemin Reaction:Engine:ShadowMode toujours honoré |
aspect-repo-backed-analysis | Analyse d'aspect adossée au dépôt | Router l'onboarding d'aspect vers le graphe dont l'analyse Vision s'exécute comme tâche de codeur sur une copie réelle en lecture seule plutôt qu'en processus. Nécessite que la jointure aspect-onboarding soit active et liée ; lorsqu'elle ne peut être honorée, l'onboarding échoue bruyamment au lieu de se replier. | aspectRepoBackedAnalysis | Oui | désactivé | activé | Ancien chemin Workflows:AspectOnboarding:RepoBackedAnalysis:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
workflow-seam-first-run-onboarding | Jointure : Onboarding de première exécution | Router le flux intégré « first-run-onboarding » via le workflow de locataire qui lui est lié plutôt que par le chemin codé en dur. Nécessite aussi une liaison de jointure active avec une cible publiée ; sans liaison, le flux intégré s'exécute quoi qu'en dise ce réglage. | workflowSeamFirstRunOnboarding | Oui | désactivé | activé | Ancien chemin Workflows:Seams:first-run-onboarding:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
workflow-seam-aspect-onboarding | Jointure : Onboarding d'aspect | Router le flux intégré « aspect-onboarding » via le workflow de locataire qui lui est lié plutôt que par le chemin codé en dur. Nécessite aussi une liaison de jointure active avec une cible publiée ; sans liaison, le flux intégré s'exécute quoi qu'en dise ce réglage. | workflowSeamAspectOnboarding | Oui | désactivé | activé | Ancien chemin Workflows:Seams:aspect-onboarding:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
workflow-seam-support-case-triage | Jointure : Tri des cas de support | Router le flux intégré « support-case-triage » via le workflow de locataire qui lui est lié plutôt que par le chemin codé en dur. Nécessite aussi une liaison de jointure active avec une cible publiée ; sans liaison, le flux intégré s'exécute quoi qu'en dise ce réglage. | workflowSeamSupportCaseTriage | Oui | désactivé | activé | Ancien chemin Workflows:Seams:support-case-triage:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
workflow-seam-review-engine | Jointure : Moteur de revue | Router le flux intégré « review-engine » via le workflow de locataire qui lui est lié plutôt que par le chemin codé en dur. Nécessite aussi une liaison de jointure active avec une cible publiée ; sans liaison, le flux intégré s'exécute quoi qu'en dise ce réglage. | workflowSeamReviewEngine | Oui | désactivé | activé | Ancien chemin Workflows:Seams:review-engine:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
workflow-seam-ux-review | Jointure : Revue UX | Router le flux intégré « ux-review » via le workflow de locataire qui lui est lié plutôt que par le chemin codé en dur. Nécessite aussi une liaison de jointure active avec une cible publiée ; sans liaison, le flux intégré s'exécute quoi qu'en dise ce réglage. | workflowSeamUxReview | Oui | désactivé | activé | Ancien chemin Workflows:Seams:ux-review:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
workflow-seam-improvement-cycle | Jointure : Cycle d'amélioration | Router le flux intégré « improvement-cycle » via le workflow de locataire qui lui est lié plutôt que par le chemin codé en dur. Nécessite aussi une liaison de jointure active avec une cible publiée ; sans liaison, le flux intégré s'exécute quoi qu'en dise ce réglage. | workflowSeamImprovementCycle | Oui | désactivé | activé | Ancien chemin Workflows:Seams:improvement-cycle:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
workflow-seam-decompose-direct | Jointure : Décomposition directe | Router le flux intégré « decompose-direct » via le workflow de locataire qui lui est lié plutôt que par le chemin codé en dur. Nécessite aussi une liaison de jointure active avec une cible publiée ; sans liaison, le flux intégré s'exécute quoi qu'en dise ce réglage. | workflowSeamDecomposeDirect | Oui | désactivé | activé | Ancien chemin Workflows:Seams:decompose-direct:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
workflow-seam-decompose-research | Jointure : Décomposition de recherche | Router le flux intégré « decompose-research » via le workflow de locataire qui lui est lié plutôt que par le chemin codé en dur. Nécessite aussi une liaison de jointure active avec une cible publiée ; sans liaison, le flux intégré s'exécute quoi qu'en dise ce réglage. | workflowSeamDecomposeResearch | Oui | désactivé | activé | Ancien chemin Workflows:Seams:decompose-research:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
workflow-seam-mission-decompose-grounded | Jointure : Décomposition de mission ancrée | Router le flux intégré « mission-decompose-grounded » via le workflow de locataire qui lui est lié plutôt que par le chemin codé en dur. Nécessite aussi une liaison de jointure active avec une cible publiée ; sans liaison, le flux intégré s'exécute quoi qu'en dise ce réglage. | workflowSeamMissionDecomposeGrounded | Oui | désactivé | activé | Ancien chemin Workflows:Seams:mission-decompose-grounded:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
product-onboarding-autostart | Démarrage automatique de l'intégration produit | La création d'un produit lance son entretien d'intégration mené par l'intendant (mode Intégration) ; désactivé, l'opérateur le lance à la main depuis la page du produit. | productOnboardingAutostart | Oui | activé | activé | Se ferme si le bit locataire est illisible |
Dialogue
| Clé | Nom | Ce qu'elle contrôle | Clé valeurs | Interrupteur locataire | Défaut déploiement | Défaut locataire | Notes |
|---|---|---|---|---|---|---|---|
dialogue-escalation | Escalade du dialogue vers Claude Code | Achemine un tour de dialogue utilisant des outils vers le harnais Claude Code au lieu de la boucle de conversation en processus. | dialogueEscalation | Oui | désactivé | désactivé | Ancien chemin Dialogue:Escalation:Enabled toujours honoré |
dialogue-write-tools | Outils d'écriture du dialogue | Autorise les outils de dialogue en processus à exécuter des opérations d'écriture ACT/PROPOSE sélectionnées. La porte de déploiement reste le rail dur ; un administrateur locataire peut armer le niveau écriture à chaud. | dialogueWriteTools | Oui | désactivé | désactivé | Ancien chemin Dialogue:InProcessTools:WriteEnabled toujours honoré |
dialogue-bridge-mcp | Pont MCP du dialogue | Exposer les outils MCP de Genesis à un tour de dialogue via le pont d'outils, pour qu'un modèle sans appel d'outils natif puisse tout de même agir. | dialogueBridgeMcp | Oui | activé | activé | Ancien chemin Dialogue:BridgeMcp:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
dialogue-cross-mechanism-fallback | Repli inter-mécanismes | Permettre à un appel de dialogue en échec de se replier sur un fournisseur utilisant un mécanisme DIFFÉRENT, et pas seulement sur un autre modèle du même mécanisme. | dialogueCrossMechanismFallback | Oui | désactivé | activé | Ancien chemin Dialogue:AllowCrossMechanismFallback toujours honoré ; Se ferme si le bit locataire est illisible |
native-tool-calling | Appel d'outils natif | Utiliser le protocole d'appel d'outils propre au fournisseur lorsqu'il en a un, plutôt que le pont à marqueurs textuels. | nativeToolCalling | Oui | activé | activé | Ancien chemin PromptCaching:NativeToolCallingEnabled toujours honoré ; Se ferme si le bit locataire est illisible |
dialogue-escalation-fallback | Repli en processus de l'escalade | Lorsque la répartition Claude Code d'un tour de dialogue escaladé échoue, se replier une fois sur la voie en processus. Désactivé, le tour échoue avec la répartition au lieu de répondre par la voie plus lente. | dialogueEscalationFallback | Oui | activé | activé | Ancien chemin Dialogue:Escalation:FallbackToInProcess toujours honoré ; Se ferme si le bit locataire est illisible |
dialogue-escalation-on-tool-failure | Escalader en cas d'échec d'outil | Lors d'un échec de fournisseur récupérable sur un tour ordinaire (limite de débit, épuisement, blocage de crédit), escalader une fois vers le harnais Claude Code au lieu de renvoyer l'erreur. | dialogueEscalationOnToolFailure | Oui | désactivé | activé | Ancien chemin Dialogue:Escalation:OnToolFailure toujours honoré ; Se ferme si le bit locataire est illisible |
dialogue-in-process-tools | Outils de dialogue en processus | Fournir aux fournisseurs de dialogue le registre d'outils MCP de core (lectures de niveau 1, dans la portée du locataire appelant) plutôt que le side-car Bridge MCP, qu'aucun déploiement cloud n'exécute. Choisi une fois à la construction du conteneur : le modifier exige un redéploiement. | dialogueInProcessTools | Redémarrage requis | activé | — | Redémarrage requis ; Ancien chemin Dialogue:InProcessTools:Enabled toujours honoré |
Intelligence
| Clé | Nom | Ce qu'elle contrôle | Clé valeurs | Interrupteur locataire | Défaut déploiement | Défaut locataire | Notes |
|---|---|---|---|---|---|---|---|
auto-research | Recherche approfondie automatique | Lance automatiquement une mission de recherche approfondie quand un tour de dialogue demande une investigation et que la confiance de l'expert est faible. | autoResearch | Oui | activé | activé | Ancien chemin Orchestrator:Research:AutoTriggerEnabled toujours honoré ; Se ferme si le bit locataire est illisible |
subscription-usage-harvest | Collecte de l'usage abonnement | Collecter l'usage des abonnements fournisseurs (fenêtres de quota, remises à zéro) depuis les sessions coder vers le registre d'usage que lisent les vues coûts et quotas. | subscriptionUsageHarvest | Oui | désactivé | activé | Ancien chemin SubscriptionUsage:HarvestEnabled toujours honoré ; Se ferme si le bit locataire est illisible |
web-research-harness-fallback | Repli harnais pour la recherche web | Quand l'investigateur web en processus ne peut pas répondre, se rabattre sur une session harnais Claude Code pour l'étape de recherche. | webResearchHarnessFallback | Oui | désactivé | activé | Ancien chemin Research:Web:HarnessFallbackEnabled toujours honoré ; Se ferme si le bit locataire est illisible |
search-synthesis | Synthèse de recherche | Synthétiser une réponse en langage naturel à partir des résultats bruts (un appel modèle par recherche) au lieu de renvoyer les résultats seuls. | searchSynthesis | Oui | activé | activé | Ancien chemin Search:SynthesisEnabled toujours honoré ; Se ferme si le bit locataire est illisible |
search-postgres-fts | Recherche plein texte Postgres | Utiliser la recherche plein texte Postgres pour l'historique des conversations ; éteint, repli sur la simple correspondance de motif. | searchPostgresFts | Oui | activé | activé | Ancien chemin Search:PostgresFTS toujours honoré ; Se ferme si le bit locataire est illisible |
llm-snapshot-text-capture | Capture du texte des instantanés LLM | Stocker le texte du prompt et de la complétion de chaque appel modèle avec son enregistrement de tentative (l'instantané que montre le visualiseur d'appels). Éteint, seules les métadonnées sont gardées. | llmSnapshotTextCapture | Oui | activé | activé | Ancien chemin LlmSnapshots:CaptureText toujours honoré ; Se ferme si le bit locataire est illisible |
onboarding-auto-promote | Promotion automatique de l'onboarding | Laisser l'onboarding d'un projet promouvoir automatiquement la maturité de la pile quand ses vérifications passent, au lieu d'attendre qu'un opérateur confirme chaque étape. | onboardingAutoPromote | Oui | désactivé | activé | Ancien chemin Onboarding:AutoPromoteStackReadiness toujours honoré ; Se ferme si le bit locataire est illisible |
onboarding-knowledge-refresh | Rafraîchissement des connaissances d'onboarding | Le travailleur d'arrière-plan qui régénère les synthèses d'aspect et reflète les analyses propres d'un projet dans son corpus de connaissances après que l'onboarding a écrit son suivi de conception. Éteint, le nœud terminal d'onboarding se termine quand même ; les synthèses et le miroir restent en l'état jusqu'à la réactivation. | onboardingKnowledgeRefresh | Oui | activé | activé | Ancien chemin Onboarding:KnowledgeRefreshEnabled toujours honoré ; Se ferme si le bit locataire est illisible |
ghost-evaluation | Évaluation fantôme | Évaluer en ombre un échantillon de dialogues contre des modèles alternatifs (fantômes) et enregistrer la comparaison ; n'affecte jamais la réponse vue par l'utilisateur. | ghostEvaluation | Oui | activé | activé | Ancien chemin GhostEvaluation:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
ghost-judge | Juge fantôme | Noter les paires d'évaluation fantôme avec un modèle juge (un second appel par dialogue échantillonné) au lieu de les stocker sans score. | ghostJudge | Oui | activé | activé | Ancien chemin GhostEvaluation:JudgeEnabled toujours honoré ; Se ferme si le bit locataire est illisible |
learning-extraction | Extraction d'apprentissages | Extraire des enseignements réutilisables à partir du travail terminé, vers la base de connaissances du locataire. | learningExtraction | Oui | désactivé | activé | Ancien chemin Learning:ExtractionEnabled toujours honoré ; Se ferme si le bit locataire est illisible |
maintenance-wave | Vague de maintenance | Exécuter la vague de maintenance périodique qui rafraîchit les experts. Boucle globale : niveau déploiement uniquement. | maintenanceWave | Déploiement seul | activé | — | Ancien chemin Orchestrator:MaintenanceWaveEnabled toujours honoré |
dialogue-intelligence | Intelligence du dialogue | Exploiter les dialogues pour en extraire constats, thèmes et suites à donner, au lieu de les laisser à l'état de simple transcription. | dialogueIntelligence | Oui | activé | activé | Ancien chemin DialogueIntelligence:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
dialogue-intelligence-synthesis | Synthèse du dialogue | Synthétiser en une note unique les constats extraits des dialogues. Désactivée, les constats sont toujours enregistrés, simplement pas résumés. | dialogueIntelligenceSynthesis | Oui | activé | activé | Ancien chemin DialogueIntelligence:SynthesisEnabled toujours honoré ; Se ferme si le bit locataire est illisible |
Flotte et runtimes
| Clé | Nom | Ce qu'elle contrôle | Clé valeurs | Interrupteur locataire | Défaut déploiement | Défaut locataire | Notes |
|---|---|---|---|---|---|---|---|
claude-code-harness | Runtime d'agent Claude Code | Coupe-circuit principal pour exécuter un tick d'agent sur le runtime du harnais Claude Code. Le RuntimeKind claude-code d'un mode ne s'active que si cette porte de déploiement est ouverte. | claudeCodeHarness | Déploiement seul | désactivé | — | Ancien chemin AgentDispatcher:AllowClaudeCodeRuntime toujours honoré |
claude-runtime-provider | Pods de session du runtime Claude | Achemine les backends de codage et de dialogue claude-tool vers le fournisseur de pods de session claude-runtime hébergé dans le cluster. | claudeRuntimeProvider | Déploiement seul | désactivé | — | Ancien chemin Providers:Claude:RuntimeEnabled toujours honoré |
browser-agent-surface | Surface navigateur des agents | Les verbes ÉTENDUS du pool navigateur : onglets, lecteurs console/réseau, actions clavier-souris, téléversement, redimensionnement, plus les verbes d'exécution côté serveur (browser_eval, browser_snapshot, browser_run_spec). Désactivée, les cinq verbes d'origine — naviguer, cliquer, saisir, capturer, état de tâche — continuent de fonctionner ; les douze étendus refusent. | browserAgentSurface | Oui | désactivé | activé | Ancien chemin Browser:AgentSurface:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
windows-pool | Pool Windows | Le pool de ressources Windows (substrat .NET Framework 4.8) : outils windows_* qui louent un worker Windows pour les builds et tests qui en ont besoin. | windowsPool | Oui | désactivé | activé | Ancien chemin Windows:Pool:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
pty-approval-capture | Capture des approbations PTY | Capturer les invites d'approbation interactives d'un coder depuis son terminal et les router vers la file de décisions au lieu de laisser la session bloquée. | ptyApprovalCapture | Oui | désactivé | activé | Ancien chemin Pty:ApprovalGate:CaptureEnabled toujours honoré ; Se ferme si le bit locataire est illisible |
pty-auto-approve | Auto-approbation PTY | Répondre automatiquement aux invites d'approbation capturées selon la politique d'approbation du locataire, sans décision humaine. | ptyAutoApprove | Oui | désactivé | activé | Ancien chemin Pty:ApprovalGate:AutoApprove toujours honoré ; Se ferme si le bit locataire est illisible |
plan-mode-launcher | Lanceur de mode plan | Démarrer des sessions coder en mode plan, lecture seule (plan_mode_session_start), qui ancrent une proposition dans le dépôt réel avant toute écriture. | planModeLauncher | Oui | désactivé | activé | Ancien chemin Pty:PlanMode:LauncherEnabled toujours honoré ; Se ferme si le bit locataire est illisible |
workspace-bridge | Pont d'espace de travail | Permettre à une tâche de codage d'atteindre son espace de travail via le service dédié plutôt que par le seul système de fichiers du pod. | workspaceBridge | Oui | activé | activé | Ancien chemin Workflows:WorkspaceBridge:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
coder-cost-reconciliation | Réconciliation des coûts codeur | Réconcilier les coûts codeur enregistrés avec la comptabilité du fournisseur. Réconciliateur global : niveau déploiement uniquement. | coderCostReconciliation | Déploiement seul | activé | — | Ancien chemin CoderCostReconciliation:Enabled toujours honoré |
fleet-auth-preflight | Contrôle d'authentification avant démarrage | Vérifier qu'un identifiant LLM utilisable existe avant de démarrer un conteneur de codeur, afin qu'une flotte non authentifiée échoue à la porte au lieu de consommer un conteneur par tâche. À l'échelle de la plateforme : réglage au déploiement uniquement. | fleetAuthPreflight | Déploiement seul | activé | — | Ancien chemin Fleet:AuthPreflightEnabled toujours honoré |
coder-tool-allowlist | Liste blanche d'outils des codeurs | Restreindre la surface d'outils d'un codeur à la liste blanche nommée par sa politique. La politique est construite une seule fois lors de la composition de la surface : la modifier exige un redéploiement. | coderToolAllowlist | Redémarrage requis | désactivé | — | Redémarrage requis ; Ancien chemin Fleet:CoderToolAllowlist:Enabled toujours honoré |
coder-cap-idle-eviction | Éviction de conteneur inactif sur plafond atteint | Quand un démarrage à froid de codeur est bloqué parce que le plafond de conteneurs global ou du locataire est plein, évincer le conteneur de codeur inactif depuis le plus longtemps qui n'est PAS occupé pour faire de la place au démarrage bloqué, au lieu d'échouer la requête sur saturation. Éteint par défaut : récupérer un conteneur inactif encore chaud est un compromis de capacité qu'un déploiement choisit d'activer. | coderCapIdleEviction | Oui | désactivé | désactivé | Ancien chemin Fleet:CapBlockedIdleEviction:Enabled toujours honoré |
copilot-per-tenant | Runtime Copilot par locataire | Adresser le runtime Copilot propre à chaque locataire au lieu d'un runtime partagé. Topologie de déploiement couplée aux pods de runtime Copilot du chart : réglage au déploiement uniquement, car un locataire qui se route vers un runtime partagé change l'isolation, ce n'est pas une préférence. | copilotPerTenant | Déploiement seul | désactivé | — | Ancien chemin Providers:Copilot:PerTenant toujours honoré |
junie-per-tenant | Runtime Junie par locataire | Adresser le runtime Junie propre à chaque locataire au lieu d'un runtime partagé. Topologie de déploiement couplée aux pods de runtime Junie du chart : réglage au déploiement uniquement, pour la même raison d'isolation que la ligne Copilot. | juniePerTenant | Déploiement seul | désactivé | — | Ancien chemin Providers:Junie:PerTenant toujours honoré |
Gouvernance
| Clé | Nom | Ce qu'elle contrôle | Clé valeurs | Interrupteur locataire | Défaut déploiement | Défaut locataire | Notes |
|---|---|---|---|---|---|---|---|
compliance-overlay | Socle de conformité superposé | Injecte le socle du catalogue de contrôles actif (portes, vérifications, revues) dans les workflows à la publication, et l'applique. Reporté : désactivé par défaut ; le catalogue et le programme de conformité ne sont pas affectés. | complianceOverlay | Oui | désactivé | désactivé | Ancien chemin Workflows:ComplianceOverlay:Enabled toujours honoré |
scoped-pre-approval-arm | Pré-approbation cadrée | Armer une pré-approbation cadrée sur une barrière de flux, afin qu'une décision déjà accordée pour ce périmètre n'arrête pas de nouveau l'exécution. | scopedPreApprovalArm | Oui | désactivé | activé | Ancien chemin Workflows:Gates:ScopedPreApprovalArm:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
sod-distinct-human | Séparation des tâches : humain distinct | Exiger que l'humain qui approuve une décision de gouvernance ne soit pas celui qui l'a soulevée. Désactivé pour un locataire, une même personne peut soulever et approuver la même décision ; la piste d'audit enregistre toujours les deux actes sous la même identité. | sodDistinctHuman | Oui | activé | activé | Ancien chemin Governance:Sod:RequireDistinctHuman toujours honoré ; Se ferme si le bit locataire est illisible |
sod-role-aware | Séparation des tâches : sensible au rôle | Étendre la règle de l'humain distinct pour que le fait de détenir le rôle demandeur disqualifie un approbateur même si l'identité diffère. Restreint strictement qui peut approuver ; sans effet tant que la règle de l'humain distinct est désactivée. | sodRoleAware | Oui | désactivé | activé | Ancien chemin Governance:Sod:RoleAwareDistinctHuman toujours honoré ; Se ferme si le bit locataire est illisible |
dod-run-acceptance | Définition du terminé : acceptation d'exécution | Exiger une exécution de mission acceptée avant qu'un sceau de promotion soit valide. Désactivé, un sceau peut être accordé sur un travail jamais accepté lors d'une exécution. | dodRunAcceptance | Oui | désactivé | activé | Ancien chemin Governance:Dod:RequireRunAcceptance toujours honoré ; Se ferme si le bit locataire est illisible |
retry-approval | La reprise exige une approbation | Faire passer la reprise d'une tâche échouée par une décision d'opérateur au lieu de la relancer automatiquement. Désactivé, les reprises se poursuivent sans surveillance et consomment du budget sans humain dans la boucle. | retryApproval | Oui | activé | activé | Ancien chemin Missions:RequireRetryApproval toujours honoré ; Se ferme si le bit locataire est illisible |
brokered-credentials-required | Identifiants courtiers obligatoires | Refuser de démarrer un codeur si son identifiant LLM n'est pas servi par le courtier d'identifiants. Désactivé, un codeur peut démarrer avec un identifiant remis directement, ce qui ne laisse aucune trace de courtier par appel. | brokeredCredentialsRequired | Oui | désactivé | activé | Ancien chemin Fleet:RequireBrokeredCredentials toujours honoré ; Se ferme si le bit locataire est illisible |
task-env-allowlist-enforced | Liste blanche d'environnement appliquée | Filtrer l'environnement remis à une tâche de codeur pour ne garder que les variables autorisées. Désactivé, l'environnement calculé complet est transmis, donc une variable ajoutée n'importe où en amont atteint le conteneur. | taskEnvAllowlistEnforced | Oui | désactivé | activé | Ancien chemin Fleet:EnforceTaskEnvAllowlist toujours honoré ; Se ferme si le bit locataire est illisible |
redaction-feed | Flux de capture de caviardage | Enregistrer ce que la couche de caviardage a retiré des invites LLM sortantes. Le caviardage s'exécute toujours ; ceci décide seulement si la preuve est consignée. Réglage au déploiement uniquement : le commutateur est lu à CHAQUE appel LLM sortant par un chemin rapide délibérément non asynchrone, c'est donc le bit du déploiement et non celui du locataire. | redactionFeed | Déploiement seul | désactivé | — | Ancien chemin Redaction:FeedEnabled toujours honoré |
compliance-floor-advisory | Plancher de conformité consultatif | Signaler une violation du plancher de conformité par un avertissement au lieu de bloquer la publication. L'activer AFFAIBLIT le plancher : c'est la soupape pour un catalogue encore en cours de réglage, pas un mode d'exploitation normal. | complianceFloorAdvisory | Oui | désactivé | activé | Ancien chemin Compliance:FloorAdvisory toujours honoré ; Se ferme si le bit locataire est illisible |
proposal-hygiene | Contrôles d'hygiène des propositions | Filtrer la proposition d'un agent pour écarter les formes malformées qui gaspillent la revue d'un opérateur. Le contrôle échoue en mode OUVERT par conception : s'il ne peut pas s'exécuter, la proposition passe plutôt que d'être perdue. | proposalHygiene | Oui | activé | activé | Ancien chemin ProposalHygiene:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
Plateforme
| Clé | Nom | Ce qu'elle contrôle | Clé valeurs | Interrupteur locataire | Défaut déploiement | Défaut locataire | Notes |
|---|---|---|---|---|---|---|---|
superrepo-fan-out | Essaimage de superdépôt | Lors de l'adoption d'un monodépôt, créer aussi un projet enfant par sous-module cloné avec succès, sous le projet maître. | superrepoFanOut | Oui | désactivé | activé | Ancien chemin Onboarding:SuperrepoFanOut toujours honoré ; Se ferme si le bit locataire est illisible |
product-tier-mint | Niveau produit | Créer le niveau PRODUIT au-dessus des projets lors de l'intégration. Dépend de l'essaimage de superdépôt : sans lui, il n'y a pas de produit à créer. | productTierMint | Oui | désactivé | activé | Ancien chemin Onboarding:ProductTier toujours honoré ; Se ferme si le bit locataire est illisible |
onboarding-reset | Réinitialisation d'intégration | Autoriser la RÉINITIALISATION d'une intégration, en abandonnant sa progression. Destructive, donc réservée au niveau déploiement : aucun interrupteur locataire ne peut l'armer. | onboardingReset | Déploiement seul | désactivé | — | Ancien chemin Onboarding:AllowReset toujours honoré |
anthropic-usage-poll | Sondage d'usage Anthropic | Interroger Anthropic sur l'usage de l'abonnement afin de connaître l'état des quotas avant qu'un appel ne soit bloqué plutôt qu'après. Sondeur global : niveau déploiement uniquement. | anthropicUsagePoll | Déploiement seul | désactivé | — | Ancien chemin Anthropic:UsagePollEnabled toujours honoré |
platform-health-probes | Sondes de santé plateforme | Exécuter les sondes périodiques de santé plateforme qui alimentent l'état de gouvernance. Boucle globale : niveau déploiement uniquement. | platformHealthProbes | Déploiement seul | activé | — | Ancien chemin PlatformHealthProbes:Enabled toujours honoré |
synthetic-provider | Sondage de quota Synthetic | Interroger le fournisseur Synthetic sur l'état des quotas. Le service lit cette valeur une seule fois à la construction, avec son point d'accès et son intervalle : la ligne est donc en LECTURE SEULE et un changement exige un redéploiement. | syntheticProvider | Redémarrage requis | désactivé | — | Redémarrage requis ; Ancien chemin Synthetic:Enabled toujours honoré |
git-mirror-per-tenant | Miroir git par locataire | Router le trafic git des codeurs vers l'instance git-mirror propre au locataire plutôt que vers l'instance partagée. Topologie de déploiement : niveau déploiement uniquement. | gitMirrorPerTenant | Déploiement seul | désactivé | — | Ancien chemin Services:GitMirror:PerTenant toujours honoré |
environment-provisioner | Provisionneur d'environnements | Provisionner des environnements par tâche à la demande. Livré éteint ; l'activer autorise la répartition des tâches à créer des environnements dans le cluster. | environmentProvisioner | Déploiement seul | désactivé | — | Ancien chemin Provisioner:Enabled toujours honoré |
prompt-caching | Mise en cache des invites | Demander au fournisseur de mettre en cache le préfixe stable d'une invite, afin qu'un contexte répété soit facturé et traité une seule fois. | promptCaching | Oui | activé | activé | Ancien chemin PromptCaching:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
batch-processing | Traitement par lots | Envoyer le travail éligible à l'API de traitement par lots du fournisseur, en échangeant de la latence contre du coût. | batchProcessing | Oui | activé | activé | Ancien chemin BatchProcessing:Enabled toujours honoré ; Se ferme si le bit locataire est illisible |
ops-per-tenant | Plan d'exploitation par locataire | Router les appels du plan de lecture d'exploitation vers le service d'exploitation propre à chaque locataire plutôt qu'un service partagé. Un garde-fou de démarrage : avec le routage de connexion par locataire actif, core REFUSE de démarrer tant que ceci est désactivé, d'où un réglage au déploiement uniquement, couplé à la topologie d'exploitation du chart. | opsPerTenant | Déploiement seul | désactivé | — | Ancien chemin Services:Ops:PerTenant toujours honoré |
git-mirror-gitlab-proxy | Le miroir Git relaie GitLab | Faire transiter le trafic GitLab des codeurs par le service de miroir Git plutôt que directement vers GitLab. Câblé lors de la composition de l'hôte d'exécution : le modifier exige un redéploiement. | gitMirrorGitlabProxy | Redémarrage requis | désactivé | — | Redémarrage requis ; Ancien chemin GitMirror:ProxyGitLab toujours honoré |
demo-mode | Mode démonstration | Placer l'instance entière en mode démonstration : les écritures sont refusées et tout appel LLM est bloqué au niveau du fournisseur. Choisi au démarrage — l'enregistrement du fournisseur lui-même change — donc un redéploiement est nécessaire. | demoMode | Redémarrage requis | désactivé | — | Redémarrage requis ; Ancien chemin Genesis:DemoMode:Enabled toujours honoré |
Généré depuis le catalogue des fonctionnalités. Ne pas modifier à la main — modifier le catalogue et régénérer.
Pages que vous pouvez ignorer
ARDS a plus de pages qu'un testeur v1 n'en a besoin. Voici la liste explicite des pages que vous pouvez sauter — elles existent pour les opérateurs ou pour des fonctionnalités pas prêtes pour de la doc testeur.
À ignorer : gouvernance et conformité
- Compliance — Pistes d'audit internes, collecte de preuves, recherche SBOM. Surface opérateur. La conformité va pourtant vous rencontrer dans les workflows — voir Gouvernance des workflows.
- Compliance Documents / Incidents / Profile / Gaps / SBOM — Sous-pages de la précédente.
- Governance — Édition de constitution / politique. Lecture seule pour les testeurs ; rien d'utile à changer ici. La gouvernance va pourtant vous rencontrer dans les workflows — sous forme de nodes de contrôle injectés sur le canvas et de vérifications à la publication. C'est documenté dans Gouvernance des workflows ; cette liste ne parle que des pages de tableau de bord ci-dessus.
À ignorer : internes d'orchestration
- Agents — Cycle de vie d'agents internes (pas des coders). Diagnostic opérateur.
- Flotte Coder — L'exploitation des coders en direct : un onglet Moniteur Coder (diagnostic des conteneurs) et un onglet Tableau de bord des files (état brut des files). Les anciennes pages autonomes Queue et Coder Monitor sont devenues ces deux onglets — leurs anciens liens redirigent ici. Utile uniquement quand un opérateur débogue des tâches coincées ; ne changez rien.
- Oracle Detail / Traces — Internes des traces de décision de l'orchestrateur.
- Prism Reports — Agrégation interne de rapports sécurité/conformité.
- Quotas — La salle de contrôle admin des quotas fournisseur : une carte par compte fournisseur, avec l'état de chaque fenêtre d'utilisation. Elle se trouve dans la section basse, toujours visible, de la barre latérale ; libre à vous de la lire par curiosité, rien à changer pour un testeur.
- Observatoire — Tableaux d'observabilité du système. Même section basse et toujours visible de la barre latérale que Quotas ; libre à vous de lire, rien à changer pour un testeur.
- Supervision — Tableaux de supervision en direct, dans cette même section basse. Curiosité en lecture seule pour un testeur.
À ignorer : expérimental / WIP
- Preview Dashboard — Surface expérimentale. Comportement sujet à changement sans préavis.
- Migrations Overview — Vue runbook des migrations de schéma interne.
- Matter Detail Page — Placeholder interne pour une feature pas encore livrée.
À ignorer : chartes et initiatives
- Charters / Initiatives — Documents de planification internes. La feuille de route publique vivra ailleurs quand elle sera prête (le chapitre architecture décrit ce qu'ils sont : Charters et Matters).
À ignorer : canal email
- Email Channel — Plomberie email côté opérateur (files entrantes, gestion de thème). Les testeurs ne configurent pas ça.
- Email Threads — Vue opérateur du courrier entrant.
Disponible dans certains déploiements seulement
- Intégrations — L'écran tenant-admin pour connecter votre propre GitLab, pour que Genesis ouvre des merge requests dans votre groupe. L'entrée de la barre latérale (à côté de Settings) n'apparaît que quand votre déploiement fournit l'intégration — si vous ne la voyez pas, elle n'est pas activée pour votre déploiement.
Disponibilité des fonctionnalités
Toutes les capacités ne sont pas actives partout. Une fonctionnalité peut être coupée pour tout le déploiement, ou seulement pour votre tenant. Settings → Features (« Fonctionnalités ») montre les bascules de votre tenant — ce qui est disponible, ce qui est actif, et qui a changé quoi en dernier. Les lignes marquées Verrouillé par le déploiement sont contrôlées au niveau plateforme : vous les voyez, mais elles ne se changent pas côté tenant. Si une page ou un bouton mentionné dans ce livre vous manque, vérifiez cet écran avant d'ouvrir un ticket de support. La liste complète des fonctionnalités, avec ce que chacune contrôle et ses valeurs par défaut, est la référence Fonctionnalités activables.
Ce qui n'est pas dans cette liste
Si vous ne voyez pas un nom de page ci-dessus, c'est qu'elle est probablement utile à un testeur. Les principales pages testeur :
- Conversations, Missions, Décisions, Tâches, Revues, Modifications.
- Workflows (liste, éditeur, visionneuse de run).
- Fleet Runs (« Exécutions de flotte » — toutes les exécutions de workflow de votre tenant, dans une grille filtrable).
- Projects, GitMirror.
- Config LLM, Snapshots LLM, Fleet Profiles, Paramètres.
- Coûts, Intelligence / Recherche, Rapports.
- Review Engine, Ghost, Revues UX.
- Orchestrateur (lecture seule, ou presque).
- Suggestions, Recherche approfondie, Tickets de support.
Deux notes pour trouver ces pages :
- La barre latérale est volontairement mince. Tâches, Revues, Suggestions, Tickets de support et Recherche approfondie n'y apparaissent qu'après le premier artefact de ce type produit par votre tenant — puis y restent. D'ici là (et pour toute page sans entrée de barre latérale), passez par l'index Toutes les fonctionnalités : l'entrée « … » en bas de la barre latérale.
- Observatoire, Gouvernance, Coûts, Quotas, Conformité et Supervision sont toujours visibles dans la section basse et atténuée de la barre latérale — visible ne veut pas dire qu'un testeur en a besoin (voir les listes ci-dessus).
Tout ce qui est dans la première liste peut être ignoré en v1 sans rater de fonctionnalité destinée aux testeurs. Si vous vous retrouvez à lire une page de cette liste parce que vous ne savez pas où aller, c'est un bug de doc — dites-le-nous via Ouvrir un ticket de support et on vous orientera vers la bonne surface (et on mettra à jour cette doc).
Dépannage
Une doc v1 sur un produit en accès anticipé. Vous allez tomber sur des aspérités. Voici celles que nous connaissons déjà et comment les contourner.
L'email d'invitation a atterri dans les spams
Outlook, Live et Gmail sont les suspects habituels. Vérifiez le dossier indésirables, marquez l'expéditeur (update@etiakorp.com) comme légitime, et déplacez l'email vers votre boîte de réception. Les emails système suivants atterriront au bon endroit.
J'ai reçu plusieurs emails d'invitation
Cela arrive quand le provisionnement réessaie. Utilisez le plus récent. Les liens plus anciens peuvent encore fonctionner, mais le dernier est le bon.
L'URL de l'application ne se charge pas, ou je vois un 502 / 503
Les nouveaux sous-domaines tenant ont besoin d'1 à 2 minutes pour que le DNS et le TLS se propagent. Attendez, puis rafraîchissez. Si plus de 5 minutes se sont écoulées, le cluster est peut-être en cours de synchronisation — réessayez dans une ou deux minutes. Si cela ne fonctionne toujours pas après 10 minutes, voir Obtenir de l'aide.
Le lien d'activation dit « expired »
Les jetons d'action des emails d'activation expirent après une courte fenêtre (généralement quelques heures). La solution est un email frais — ouvrez un ticket de support (avec votre slug) et on relancera l'invitation. Si vous avez déjà reçu plusieurs invitations, essayez un email plus récent avant de contacter le support.
L'assistant d'accueil reste bloqué sur « Decomposing into tasks… »
Rafraîchissez la page. L'assistant relit l'état depuis le serveur et vous pouvez reprendre où vous en étiez — votre choix de workspace est conservé. Si le blocage revient après le rafraîchissement, contactez le support ; cela signifie en général qu'un réglage côté back-end ne va pas et qu'on doit regarder.
Une clé d'API fournisseur a été refusée
Vérifiez le préfixe :
- Les clés Anthropic commencent par
sk-ant-… - Les clés OpenAI (et compatibles) commencent par
sk-… - Les clés Synthetic.new commencent par
syn-…
Si le préfixe est mauvais, vous avez probablement copié le mauvais champ depuis la console du fournisseur. Régénérez depuis le tableau de bord du fournisseur si la clé est expirée. Le message d'erreur dans Genesis peut afficher le code HTTP brut dans certains chemins — 401 veut dire « clé invalide », 403 « pas d'accès », 429 « limite atteinte ou pas de crédit ».
Mission bloquée en « Decomposing » plus de 2 minutes
- Rafraîchissez la page.
- Si votre fournisseur a eu une panne récente, le planificateur peut être en train de retenter ; attendez une minute de plus.
- Si 5 minutes passent sans avancée, annulez la mission et recréez la conversation.
Mission bloquée en « Running » sans avancée apparente
- Ouvrez la mission. Regardez le statut tâche par tâche.
- Tâches en Pending depuis plus de quelques minutes → la flotte est peut-être saturée. Voyez l'onglet Outils de Config LLM : le Max. concurrent de la flotte, le Max Instances de chaque variante et le compte en direct des instances actives vivent là. (L'ancienne page Fleet Resource Config redirige désormais vers cet onglet.)
- Tâches en InProgress avec la même durée écoulée depuis plus de 10 minutes → une tâche unique est peut-être dans une boucle de retry longue. Ouvrez-la ; le log dit ce qu'il se passe.
Une tâche affiche « TurnLimitReached »
Le coder a épuisé son budget de tours — le plafond par exécution du nombre d'étapes qu'il peut prendre — avant de déclarer le travail terminé. C'est un arrêt, pas un plantage : ce que le coder a commité est sur sa branche, mais la tâche n'a pas fini. Sur la page mission, la ligne de la tâche propose le bouton ↻ (Réessayer la tâche) — cliquez-le pour remettre la tâche en file pour un coder frais. Si la même tâche retape le plafond, le travail est probablement trop gros pour une seule tâche ; demandez une tranche plus petite dans la conversation.
Une tâche reste en « UsageLimitWait »
Le quota d'utilisation du fournisseur est épuisé pour la fenêtre en cours. Ce n'est pas une erreur : la tâche est en pause, pas en échec, et elle reprend toute seule quand la fenêtre de quota se réinitialise. Rien à cliquer, pas de ticket à ouvrir — laissez-la tranquille et revenez plus tard.
Une mission affiche « Paused »
Quelqu'un a cliqué sur Pause sur la page mission — cela suspend le nouveau travail sans rien perdre. Ouvrez la mission : dans la rangée d'actions en bas, Reprendre remplace Pause tant que la mission est en pause. Cliquez-le et la mission repasse en InProgress.
« L'action a été refusée » (transition invalide)
Vous avez demandé à une mission un changement d'état qu'elle n'autorise pas depuis là où elle se trouve — la demande est refusée plutôt qu'ignorée en silence. Le message d'erreur nomme l'état actuel de la mission et liste les transitions qu'elle accepte. Lisez cette liste avant de réessayer : le même clic rebondira encore, et l'une des actions listées est le prochain coup légal.
L'écran de revue est vide alors qu'une tâche s'est terminée
- La revue est peut-être encore en synchro — rafraîchissez après 30 secondes.
- Si toujours vide, le coder a peut-être produit un no-op (rare mais possible). La page tâche montre ce que le coder a réellement changé ; si « rien », c'est la cause.
Push vers l'origine échoué après approbation
- Voyez la demande d'attention sur la revue — elle nomme généralement l'erreur (auth, réseau, conflit de ref).
- Ré-ajoutez les identifiants dans la page Projects si le token a expiré.
- Il n'y a pas de bouton de relance du push — les pushes se relancent automatiquement, et une tâche dont le push échoue en boucle est remise en file toute seule. Corrigez les identifiants, puis laissez quelques minutes ; si la tâche finit quand même en Failed, le bouton ↻ (Réessayer la tâche) sur sa ligne est le levier manuel.
Workflows
Symptômes propres aux missions qui exécutent un workflow. Pour la vue d'ensemble, voir Runs, acceptation et changements.
| Symptôme | Solution |
|---|---|
| Publish (« Publier ») refusé | Lisez la liste de problèmes — elle est exhaustive. La validation signale tout d'un coup ; corriger les éléments listés est tout le travail. Voir Cycle de vie d'un workflow. |
| Un run ne démarre pas | En général : un run est déjà ouvert sur cette mission, ou la mission n'est pas encore planifiée. Acceptez ou écartez le run ouvert, ou laissez la planification se terminer, puis relancez. Voir Runs, acceptation et changements. |
| Accept (« Accepter ») refusé | Les choses ont bougé sous le run — la pointe de la mission a avancé ou la fusion entre en conflit. Rien n'a atterri ; lancez un run frais depuis la nouvelle pointe. Voir Accepter. |
| Une gate semble bloquée | Elle vous attend. Ouvrez le tableau Decisions — la carte de la gate porte ses instructions et d'éventuels champs à remplir. |
| Impossible de modifier un workflow publié | C'est voulu — les workflows publiés sont immuables. Clonez-le en un nouveau draft, modifiez, et publiez une nouvelle version. Voir Cycle de vie d'un workflow. |
Surprises de coût
- Ouvrez le tableau Costs, filtrez sur la période en question.
- La vue par mission montre quelle mission et quel point d'appel ont dépensé l'argent.
- Si une tâche unique a beaucoup mangé, ouvrez-la et regardez le modèle — parfois une chaîne de fallback vous a basculé sur un modèle plus cher sans que vous le remarquiez.
Je ne peux pas me connecter
- Confirmez l'URL :
https://<votre-slug>.ards.etiakorp.com/. - Essayez une fenêtre de navigation privée (élimine un cookie périmé).
- Si vous venez de définir un nouveau mot de passe, laissez DNS / TLS encore une minute.
- Toujours coincé après 5 minutes → ouvrez un ticket de support (envoyez-nous un email si vous ne pouvez littéralement pas ouvrir la page de tickets).
Autre chose semble ne pas aller / cette doc est incomplète
Cette doc est en v1. Des manques et des inexactitudes sont probables. Dites-le-nous — voir Obtenir de l'aide. Ce qui aide : ce que vous étiez en train de faire, ce que vous avez vu, un horodatage approximatif, et une capture d'écran si c'est visuel.
Obtenir de l'aide
Email : support@etiakorp.com
Dans l'application : ouvrez Ouvrir un ticket de support pour le chemin recommandé — il attache automatiquement votre contexte tenant pour qu'on débogue plus vite.
Demander à Genesis : le bouton d'aide et support dans l'application propose aussi Demander à l'assistant — un chat d'aide produit (Demander à Genesis) qui explique comment utiliser chaque fonctionnalité. Il ne peut ni voir ni modifier les données de votre projet. Essayez-le d'abord pour les questions « comment faire… » ; gardez les tickets pour ce qui semble cassé.
Quelques éléments qui nous aident à vous aider
- Soyez précis. « Ça ne marche pas » est difficile à exploiter. « J'ai cliqué sur Create sur la carte Start fresh, c'est resté sur "Creating…" pendant deux minutes puis plus rien » est exploitable.
- Indiquez un horodatage approximatif. « Vers 14h30 GMT+2 aujourd'hui » nous permet de retrouver ce qu'il se passait dans les logs.
- Les captures d'écran aident, surtout pour les problèmes visuels ou les messages d'erreur.
- N'incluez pas de secrets (clés API, jetons) dans vos messages. Nous n'en avons pas besoin et nous ne pouvons pas faire comme si nous ne les avions pas vus.
Temps de réponse
Le produit est en accès anticipé. Les délais varient ; nous lisons tout.
- Critical (vous ne pouvez pas utiliser le produit) — au mieux dans les quelques heures pendant les heures ouvrées.
- High (bloquant) — dans la journée ouvrée.
- Normal / Low — dans quelques jours ouvrés.
Le fuseau de l'équipe principale est UTC+1 / UTC+2 (selon l'heure d'été).
Ce que nous ne faisons pas
- Pas de SLA en accès anticipé. Quand le produit sortira de cette phase, les plans payants porteront des SLA.
- Pas de support téléphonique. Email et tickets in-app uniquement.
- Pas de chat en direct avec un humain en v1. La surface conversation de l'app, c'est pour parler à ARDS, pas à nous ; le panneau Demander à Genesis explique le produit, il n'atteint pas une personne.
Sécurité et abus
Pour les problèmes de sécurité (vulnérabilités suspectées, fuites de données, compte compromis), envoyez un email à support@etiakorp.com avec [SECURITY] dans le sujet. On le route directement à l'équipe plateforme.
Pour les signalements d'abus (le tenant d'un autre fait quelque chose qu'il ne devrait pas), même adresse avec [ABUSE] dans le sujet.
Demandes de fonctionnalité
Déposez-les en ticket de support à sévérité Low ou Normal. On suit les demandes sur notre backlog et on revient quand une ressort.
Merci d'essayer ARDS.